4.3 性能优化与资源限制
4.3 性能优化与资源限制
本节摘要:性能优化与资源限制解决两个问题:一是防止某个容器把同机的资源吃光,拖垮其他服务;二是让镜像更小、构建更快、运行时开销更低。核心内容分四块:deploy.resources 的 limits 与 reservations 写法、为什么必须限制内存(OOM 保护)、用 docker stats 观察资源基准、构建期与运行期的优化手段。本节给出完整的限额配置示例、多阶段构建 Dockerfile 和一张容器配额边界示意图。
本节目标
- 能写出 deploy.resources 下的 limits 与 reservations 完整配置
- 能解释不限制内存时 OOM killer 会带来什么后果
- 能用 docker stats 观察容器资源占用,并据此定出合理限额
- 能说出多阶段构建、.dockerignore、构建缓存三个构建期优化手段的原理
一、资源限制的两种写法与字段含义
Compose 限制资源有新旧两套写法。老写法是服务顶层的 cpus、mem_limit、mem_reservation;新写法统一收敛到 deploy.resources 下的 limits 与 reservations。两者效果一致,我们推荐用 deploy 写法——它是 Swarm 兼容的,将来迁移编排不重写配置。
version: "3.9" services: web: image: nginx:latest ports: - "80:80" deploy: resources: limits: cpus: '1.0' memory: 2048m reservations: cpus: '0.5' memory: 1024m
这段配置的意思是:web 服务最多使用 1 个 CPU 核和 2GB 内存,这是它的硬性上限;同时承诺至少预留 0.5 个 CPU 核和 1GB 内存,调度器按这个量给它兜底。deploy 字段下的 resources 在 Docker Swarm 模式下会作为调度约束,在单机 Compose 下 limits 直接生效,reservations 起软性保证作用。
老写法里的字段也有各自语义,做一张对照表:
| 字段 | 含义 | 示例 | 备注 |
|---|---|---|---|
| cpus | 最多可用的 CPU 核数 | cpus: '0.5' | 0.5 表示半个核 |
| cpu_shares | CPU 权重,竞争时按比例分配 | cpu_shares: 512 | 默认值 1024 |
| mem_limit | 内存硬上限 | mem_limit: 512m | 超出触发 OOM |
| mem_reservation | 内存软性预留 | mem_reservation: 512m | 不强制,优先满足 |
| deploy.resources.limits | limits 与 reservations 的统一写法 | 见上文 | Swarm 兼容 |
cpu_shares 值得多说一句:它不是上限,是权重。系统 CPU 空闲时,权重不影响使用;只有多个容器抢 CPU 时,才按权重分配时间片。默认 1024,一个容器设 512、另一个设 2048,争抢时后者分到的时间片约是前者的四倍。理解这一点,才不会把 cpu_shares 当 cpus 用。
二、为什么必须限制内存:OOM 保护
限制内存不是抠门,是保护。Linux 内核有个机制叫 OOM killer:当整机内存耗尽,内核必须杀掉一些进程来回收内存。它选目标时主要看谁占内存多、谁的 oom_score 高,而 Docker 默认给所有容器相同的分数基数——换句话说,一个内存失控的容器,和数据库容器在"被杀优先级"上是平等的,谁占得多先杀谁。
设想一个场景:一台 8GB 的机器跑着 Web、Redis、PostgreSQL 三个容器,没人给它们设内存上限。Web 服务某次流量高峰出现内存泄漏,一路吃到 6GB,整机内存告急。OOM killer 动手时,极可能先选中占内存最大的容器——恰好是那个泄漏的 Web,也可能误伤刚好吃内存的 PostgreSQL。数据库被杀、WAL 未落盘,轻则连接中断,重则数据损坏。这就是不限制内存的连锁代价。
反过来,给每个容器设好 limits,内核的记账就清晰了:Web 的上限是 1GB,泄漏到顶就被杀掉(或触发应用自身崩溃),Redis 和 PostgreSQL 的配额不受影响,整机依然稳定。我们给生产环境定内存限额的口诀是:先不设限跑一周,docker stats 看峰值,峰值乘 1.5 到 2 倍做上限,再留 20% 给系统缓存。
三、docker stats:限额的基准从哪来
限额不能拍脑袋,要先量。docker stats 是 Docker 自带的资源观测命令,实时显示每个容器的 CPU 使用率、内存使用量、网络 I/O 和磁盘 I/O。一个实用技巧是用命令替换把全部运行中的容器都带进来:
docker stats $(docker ps -q)
输出里每行一个容器,CONTAINER ID、CPU%、MEM USAGE、MEM %、NET I/O、BLOCK I/O、PIDS 七列。我们定限额的流程是:先把服务按预估值设一个宽松上限,压测或跑一周真实流量,记录 docker stats 的峰值;内存上限取峰值的 1.5 到 2 倍,CPU 上限按业务类型定——IO 密集型的服务 CPU 给低一点没关系,计算密集型的要给足。这个流程每月重复一次,因为业务形态会变,限额也要跟着变。
四、构建阶段优化:镜像越小,发布越快
镜像体积直接影响拉取时间、磁盘占用和启动速度。构建期优化有三个主力手段。
多阶段构建。 把编译环境和运行时环境分离:第一阶段装全量构建工具(Maven、GCC、Node 等),产出编译产物;第二阶段只从第一阶段拷贝产物,装最小运行时。以 Java 项目为例:
# 阶段 1: 构建阶段 FROM maven:3.8.1-openjdk-17 AS builder WORKDIR /app COPY pom.xml . RUN mvn dependency:go-offline COPY src ./src RUN mvn clean install -DskipTests # 阶段 2: 运行时阶段 FROM openjdk:17-jre-slim WORKDIR /app COPY --from=builder /app/target/*.jar app.jar EXPOSE 8080 ENTRYPOINT ["java", "-jar", "app.jar"]
阶段 1 的镜像是几百兆的 Maven 全家桶,但它是中间产物,最终镜像只保留阶段 2——一个精简的 JRE 加一个 jar 包,体积可能只有前者的五分之一。COPY --from=builder 是跨阶段拷贝的关键语法。
.dockerignore。 和 .gitignore 一个思路:把 node_modules、.git、测试数据、本地环境文件排除在构建上下文之外。构建上下文越大,传输和校验越慢;更重要的是,这些文件一旦被 COPY 进镜像就是永久包袱。一个 Java 项目配了 .dockerignore 后,构建上下文可能从 500MB 降到 10MB。
利用构建缓存。 Docker 构建时逐层缓存,某一层没变化就复用缓存。要利用这个特性,就要把"变化频率低的层"放在前面:依赖清单(pom.xml、requirements.txt)先 COPY 并安装,源码最后 COPY。这样源码改动只触发最后一层重建,依赖层直接命中缓存,本地和 CI 的构建时间能省下大半。反过来,把源码先 COPY 再装依赖,每次改动都要重新下依赖,构建时间翻倍。
五、运行时优化:日志轮转与镜像瘦身
构建期优化解决"镜像怎么小",运行时优化解决"跑起来怎么稳"。两件事最重要。
日志轮转。 默认 json-file 驱动会把日志追加到宿主磁盘,没有上限。一个打日志很猛的服务,几天就能写满磁盘,导致所有容器写不进去数据。生产配置必须加轮转:
version: "3.9" services: web: image: nginx:latest logging: driver: json-file options: max-size: "10m" max-file: "3"
单文件 10MB、最多保留 3 个文件,总占用被限制在 30MB 以内。这个配置在 4.1 已经出现过,这里强调它同时也是性能配置——磁盘写满比慢更致命。
镜像瘦身。 运行期还能再压一轮:基础镜像选 Alpine 这类精简发行版,体积是 Debian 系的五分之一;把多个 RUN 合并成一个,减少镜像层数,每层都是独立的存储单元,层数越多占盘越多;安装依赖时带 --no-cache 之类的参数,不保留包管理器的缓存文件。
存储与网络。 数据卷用 named volume 而不是 bind mount,性能更稳、语义更清晰;存储驱动优先用 overlay2,它是现代 Docker 的默认选择,读写性能比旧版 aufs 好;数据库容器按业务调优,比如 PostgreSQL 的共享缓冲区、MySQL 的 innodb_buffer_pool_size,这些参数对性能的影响往往比 Docker 层的优化更直接。
六、综合示例:一份带完整限额的应用配置
最后给一份综合配置,把限额、依赖、持久化、重启策略组合起来:
version: "3.9" services: web: image: nginx:latest ports: - "80:80" cpus: '0.5' mem_limit: 512m volumes: - web_data:/var/www/html depends_on: - app app: build: context: ./app dockerfile: Dockerfile cpus: '1.0' mem_limit: 1g environment: - DB_HOST=db - DB_USER=user - DB_PASSWORD=password depends_on: - db db: image: postgres:latest environment: - POSTGRES_USER=user - POSTGRES_PASSWORD=password volumes: - db_data:/var/lib/postgresql/data mem_limit: 512m restart: always volumes: web_data: db_data:
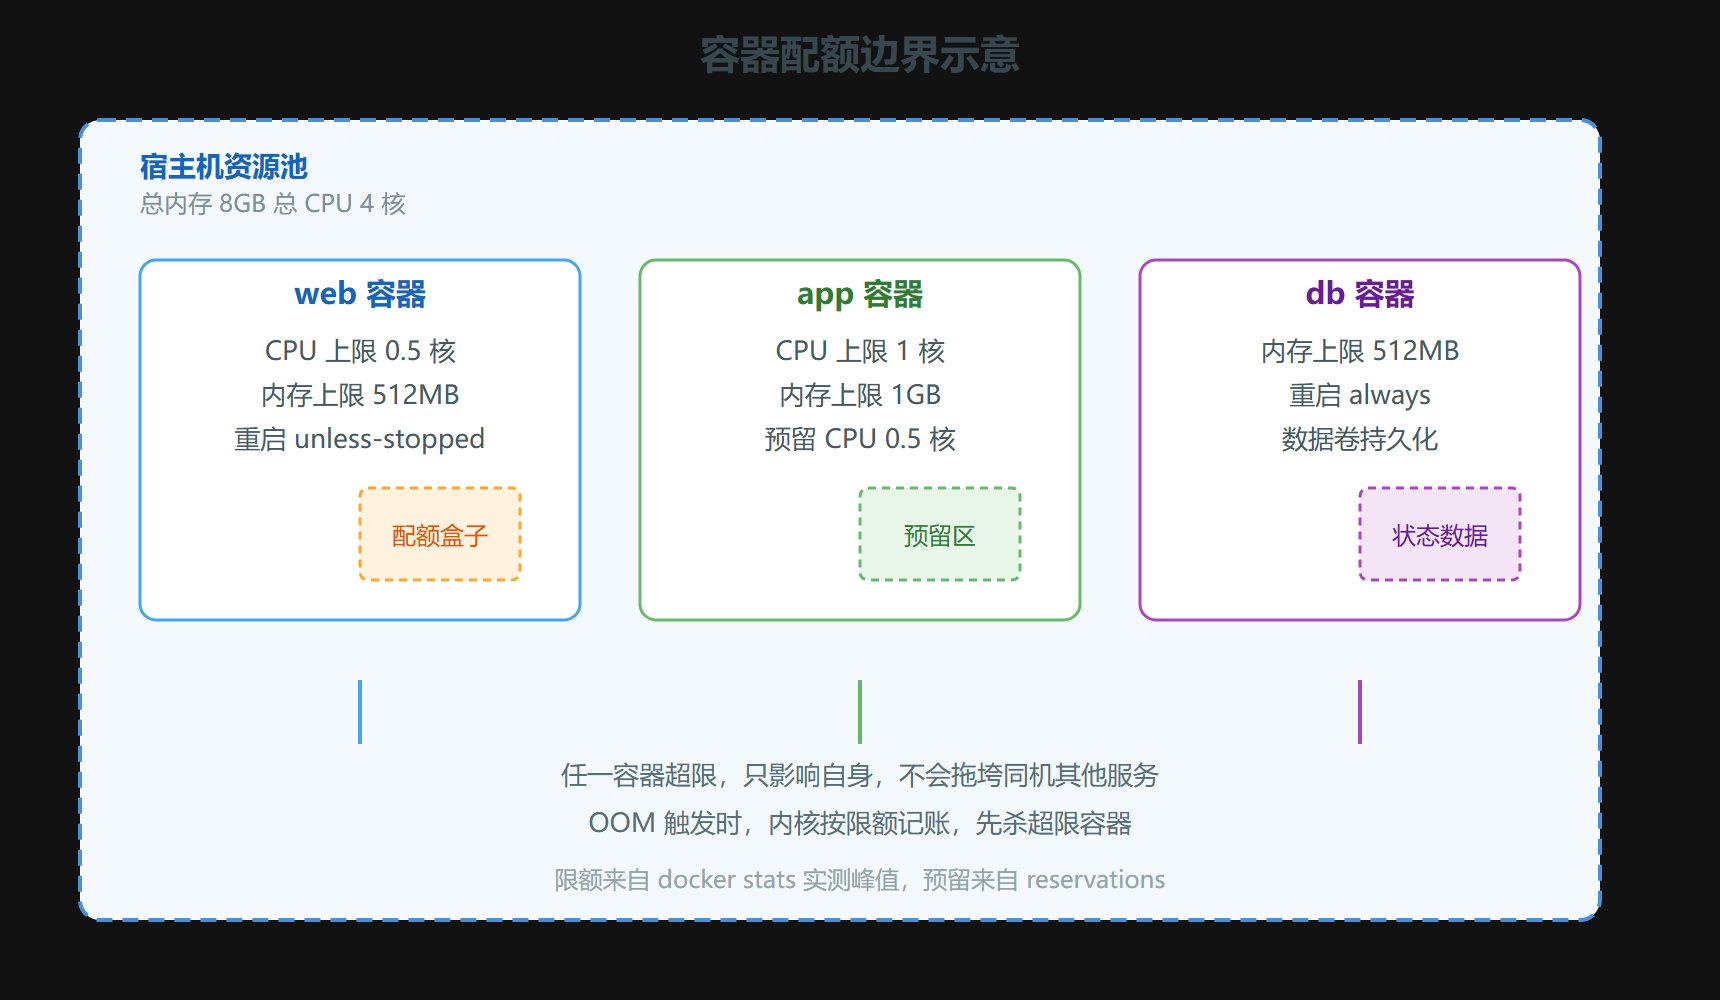
这里保留了原素材的老写法(顶层 cpus、mem_limit),与前面 deploy 写法对照着看,两条路殊途同归。三层服务各有限额:web 半个核加 512MB,app 一个核加 1GB,db 512MB 加 restart: always——数据库是状态服务,挂了必须立刻拉起,所以它的重启策略最激进。数据库的限额反而比 app 低,这提醒我们:限额要按实测数据定,不是按"谁重要给谁多"。
每个容器的配额边界,可以想象成下面这张图:每个容器都住在自己的"配额盒子"里,盒子尺寸由 limits 决定,盒子里的资源由 reservations 兜底:
容器配额边界示意
多阶段构建的流程用 mermaid 再走一遍,和上面的配额图互补:
六、常见性能坑
JVM 堆内存没设。 容器限了 512MB,Java 应用默认堆上限却按宿主机内存算,可能超过容器限额,直接触发 OOM 被杀。给 Java 应用显式设 -Xmx,让堆上限明显低于容器内存上限,这是容器化 Java 的第一课。
日志无限增长。 json-file 驱动不配 max-size 与 max-file,日志文件吃满磁盘后所有容器写不进去。这一条在 4.3 和 4.4 反复出现,因为它确实是生产事故最高频的导火索之一。
健康检查太频繁。 interval 设成 1 秒、每次探针都做完整业务请求,健康检查自己成了性能瓶颈。探针要轻量:间隔 10 到 30 秒,探一个静态接口,别把重逻辑放进探针路径。
bind mount 拖慢读性能。 开发环境用 bind mount 方便,生产环境高 IO 路径别用它——它走宿主文件系统,性能不如 named volume 稳定。日志、缓存这类高写入路径优先考虑 tmpfs 或 named volume。
镜像层数失控。 每个 RUN 指令都产生一层,层数多不仅占盘,拉取和启动也慢。合并 RUN、清理中间产物,构建一次看一眼层数和体积,别让镜像在没人注意时长成庞然大物。
拉镜像慢。 生产机从公共仓库拉镜像慢,部署窗口被拉长。解法是配置镜像加速器,或者把常用镜像提前同步到私有仓库,部署时从内网拉,几秒完成。
七、应用层优化:Docker 之外的功夫
镜像和限额都优化到位后,别忘了应用本身——容器只是运行环境,瓶颈常常在代码里。三个方向最值得投入。缓存:用 Redis、Memcached 这类缓存挡在数据库前面,热点数据命中缓存,数据库压力成倍下降,这一条对读多写少的业务收益最明显。异步处理:把耗时操作(发邮件、生成报表、推送通知)放进后台任务队列,接口响应时间从秒级降到毫秒级,用户感知的提升比任何 Docker 参数都直接。连接池与并发配置:数据库连接池大小、线程池大小要按容器限额调整,应用默认配置按宿主机资源估算,容器里不收敛就会把连接数打满,数据库先扛不住。优化的顺序建议是先应用层后容器层:代码里的慢查询和高频分配,比镜像体积更值得先处理。
⚠️ 别让数据库容器不设内存上限。它是全栈最"能吃"的容器,也是最不能被 OOM killer 误伤的容器。先量再设,别裸奔。
💡 构建缓存是 CI 里最便宜的性能优化。把依赖层放前面、源码放后面这一行顺序的调整,就能让流水线构建时间从十分钟降到两分钟,改的是 Dockerfile 的指令顺序,零成本。
温故知新
- limits 是硬上限,reservations 是兜底:deploy.resources 统一写法,兼容 Swarm。
- cpu_shares 是权重不是上限:只有 CPU 争抢时才按比例分配时间片,默认 1024。
- 不限制内存等于裸奔:OOM killer 会按占用杀进程,数据库容器首当其冲。
- 限额要有基准:docker stats 看峰值,峰值乘 1.5 到 2 倍做上限。
- 多阶段构建:编译环境与运行时分离,最终镜像只留产物。
- .dockerignore 与构建缓存:缩小构建上下文,依赖层前置命中缓存。
- 日志轮转是性能配置:max-size 与 max-file 防止磁盘被写满。
- 镜像瘦身三招:Alpine 基础镜像、合并 RUN、安装不带缓存。
下一节,容器稳了、快了,接下来要让"出问题能被看见"——日志管理与监控集成。