4.4 日志管理与监控集成
4.4 日志管理与监控集成
本节摘要:日志管理与监控集成解决"出问题能不能被看见"的问题。日志侧的核心是:默认 json-file 驱动必须配 max-size 与 max-file 做轮转,必要时切换到 syslog、journald 或 fluentd 驱动,生产环境再用 Loki 或 ELK 思路做集中收集;监控侧的核心是:用 cAdvisor 采集容器指标、node_exporter 采集宿主机指标,Prometheus 存储,Grafana 展示。本节给出日志驱动对比表、完整监控栈 compose 示例和一张日志汇聚流向图。
你能学到什么
- 能配置 json-file 驱动的 max-size 与 max-file,说清不配置的后果
- 能说出 syslog、journald、fluentd 等驱动的适用场景并完成切换
- 能熟练使用 docker compose logs 查看与过滤多容器日志
- 能画出"容器到集中收集再到检索"的日志链路,描述 Loki 与 ELK 的思路差异
- 能搭建 cAdvisor 加 Prometheus 加 Grafana 的最小监控栈
一、默认驱动 json-file:先学会给日志上锁
Docker 默认的日志驱动是 json-file:每个容器的 stdout 和 stderr 被追加写入宿主机的 /var/lib/docker/containers 目录下的 JSON 文件。开发时这没什么问题,生产上它的第一个坑就是没有上限——日志文件无限增长,直到写满磁盘。磁盘写满的连锁反应我们在 4.3 说过:所有容器都写不进去数据,服务全线雪崩。
解法是在 compose 里给每个服务配轮转:
version: "3.9" services: web: image: nginx:latest logging: driver: "json-file" options: max-size: "10m" max-file: "3"
max-size: "10m" 表示单个日志文件超过 10MB 就滚动,max-file: "3" 表示只保留最近 3 个文件。滚动后的旧文件会被删除,该服务的日志总占用被锁死在 30MB 内。这两个参数是生产配置的底线,4.1 的基线表里出现过,这里不再展开。
注意一个常识:轮转解决的是"日志撑爆磁盘",不解决"日志去哪了"。轮转掉的旧文件直接删除,排障时只能看到最近 30MB。所以生产环境真正要做的是下一节——把日志送到集中式存储。
二、驱动切换:syslog、journald 与 fluentd
json-file 之外,Docker 还支持多种日志驱动,切换方式是在 logging.driver 里指定。我们用一张表对比常见的几种:
| 驱动 | 日志去向 | 特点 | 适用场景 |
|---|---|---|---|
| json-file | 宿主机本地文件 | 默认驱动,必须配轮转 | 开发环境、日志量小的单机 |
| syslog | 本机或远程 syslog 服务 | 与系统日志统一,支持远程转发 | 已有 syslog 体系的公司 |
| journald | systemd 日志库 | 与宿主机 journalctl 统一查看 | 宿主机用 systemd 的场景 |
| fluentd | Fluentd 采集器 | 可转发到 ES 等多种后端 | 集中式日志的标准选择 |
| gelf | Graylog 等后端 | 二进制压缩传输 | Graylog 用户 |
| none | 直接丢弃 | 不落盘不转发 | 纯测试容器、日志无用场景 |
以 journald 为例,切换后日志不再写 json-file 文件,而是进 systemd 日志库,用 journalctl 就能查:journalctl -u docker -f 可以跟着容器日志走。syslog 驱动则适合已经有集中 syslog 服务器、想零改造接入的团队——驱动直接把容器日志转发到远程 syslog 端口,业务代码一行都不用动。
选择驱动时我们给两条建议:日志量小、单机部署,json-file 加轮转就够;一旦超过两三台机器或者要跨容器检索,直接上 fluentd 或 Loki 这类集中方案,别在 syslog 上缝缝补补。
驱动切换还有一个容易忽略的副作用:日志的查看方式变了。json-file 的日志 docker compose logs 直接看;切到 journald 后要用 journalctl 查宿主机日志库;切到 fluentd 后日志不再留在本机,排障入口变成了集中收集端。切换前要确认团队知道"日志去哪了",最好在部署文档里写清楚每个服务的日志驱动和查看命令,否则切换驱动本身会变成一次排障事故。另外,syslog 远程转发依赖宿主机 syslog 服务的配置,journald 的转发要确认 journal 持久化目录的磁盘空间——这两类驱动把存储责任交给了 Docker 之外的系统,它们的容量策略也要纳入运维检查项。
三、docker compose logs:日常排障的入口
无论日志最终去哪,日常排障的第一入口都是 docker compose logs。它比 docker logs 强在"按服务聚合":一条命令看到整个应用栈的输出,还能按服务过滤。
常用姿势有四个。docker compose logs 查看全部服务当前日志;docker compose logs -f 跟随模式,实时滚动新日志,适合盯发布过程;docker compose logs web 只看 web 服务的日志,加上 --tail 100 只看最近 100 行;docker compose logs --since 10m 看过去十分钟的日志,配合 --until 还能切时间窗。排障套路一般是:先 --since 定位时间点,再按服务名缩小范围,最后 -f 盯变化。
有一个坑要提前说:容器内应用写的日志文件(比如 nginx 的 access.log)不会进 Docker 日志系统,只有写到 stdout 和 stderr 的内容才会被驱动捕获。所以容器化应用务必把日志打到标准输出,否则 docker compose logs 什么都看不到——这是容器日志实践的第一条铁律。
四、集中式日志:Loki 与 ELK 的思路
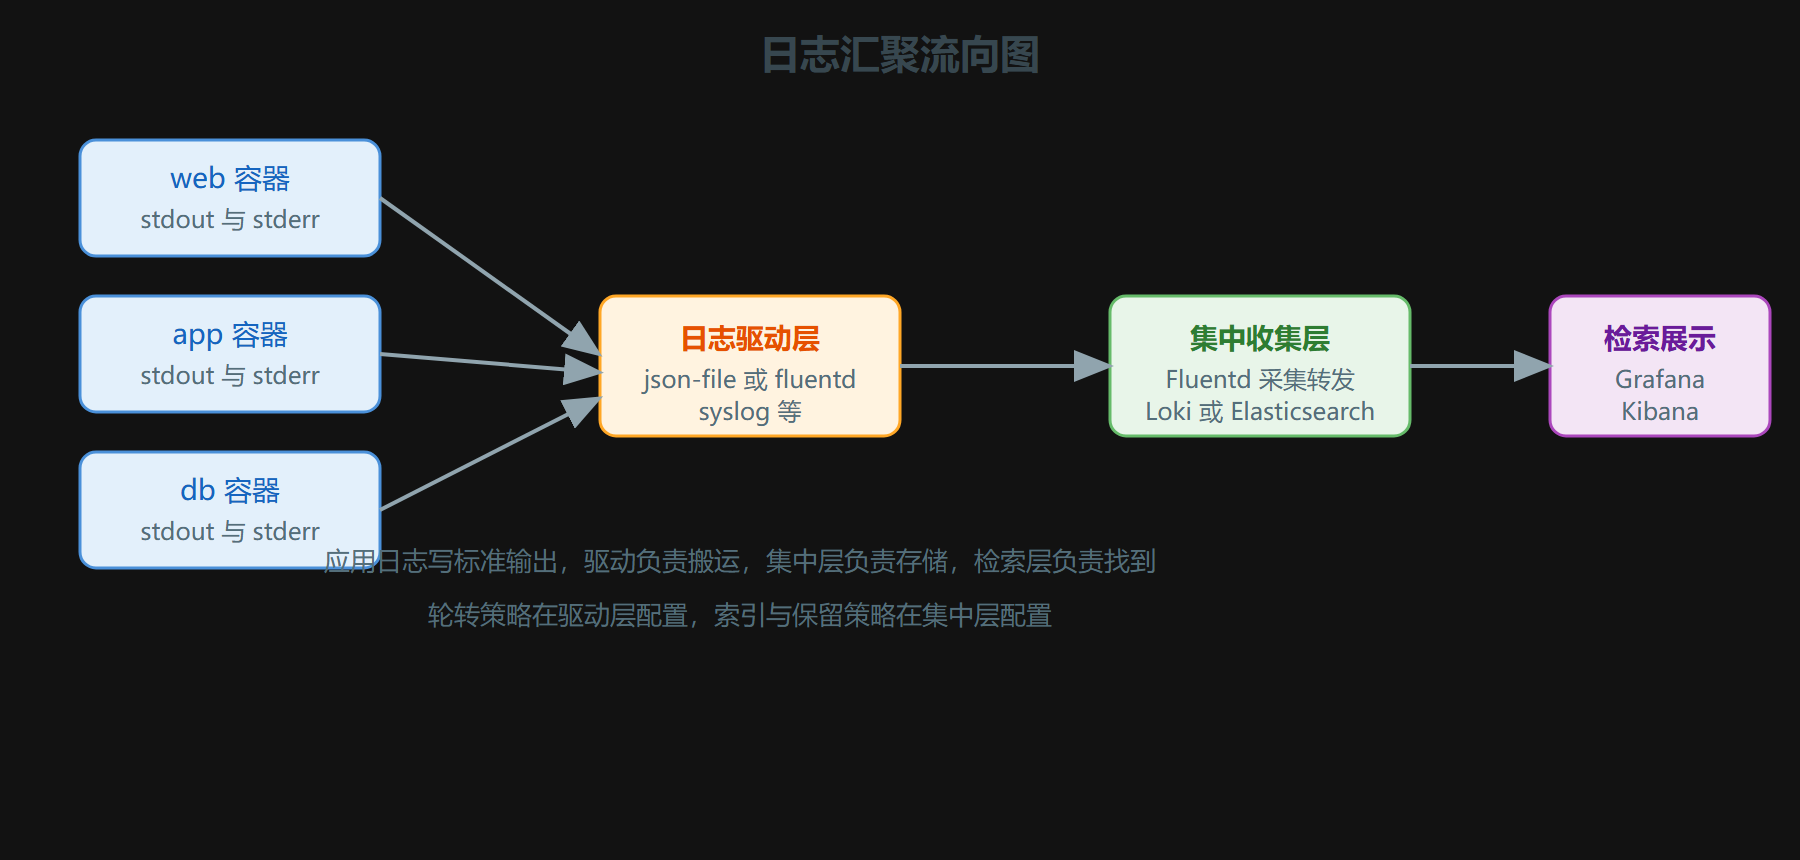
单机日志用 json-file 够用,多机就必须集中。集中式日志的本质是"日志从各容器流向一个中心存储,再从中心检索",具体路线有两大流派。
ELK 流派(Elasticsearch、Logstash/Fluentd、Kibana)是经典方案。以 EFK 为例:Fluentd 作为日志采集器,从各容器接收日志,转发给 Elasticsearch 存储和索引,Kibana 提供检索界面。在 compose 里,业务服务只要把日志驱动切到 fluentd 并指向采集器地址:
version: "3.9" services: web: image: nginx:latest logging: driver: "fluentd" options: fluentd-address: localhost:24224 tag: "nginx.access"
fluentd-address 指向 Fluentd 的 24224 端口,tag 用来标识日志来源,Fluentd 侧按 tag 分流到不同索引。EFK 全家桶的典型版本组合是 elasticsearch:7.17.6 单节点模式(环境变量 discovery.type=single-node、ES_JAVA_OPTS=-Xms512m -Xmx512m 控制堆内存)、fluentd 采集端、kibana:7.17.6 展示端。它的代价也很明显:Elasticsearch 本身吃内存,日志量大时整个栈的运维成本不低。
Loki 流派是轻量替代:它不建全文索引,只索引日志的标签(服务名、主机、级别),日志内容压缩存储。查询时用 LogQL 按标签过滤,适合"我要看某个服务某段时间的日志"这类检索,成本远低于 ELK,和 Grafana 同生态,一个界面同时看指标和日志。我们的建议是:日志量不大、团队已经在用 Grafana,直接上 Loki;有复杂全文检索、聚合分析需求的,才考虑 ELK。
日志从产生到检索的完整流向,一张图说清:
日志汇聚流向图
五、监控集成:cAdvisor 与 Prometheus 链路
日志回答"发生了什么",监控回答"现在是什么状态"。监控的经典组合是 cAdvisor 加 Prometheus 加 Grafana。
cAdvisor 是 Google 开源的容器监控工具,自动发现并采集本机所有容器的 CPU、内存、网络、磁盘指标。它需要挂载宿主机目录才能读到容器数据:根目录、/var/run、/sys 和 /var/lib/docker 四个挂载点,全部只读。node_exporter 是同一生态里补宿主机指标的组件——CPU 总负载、内存、磁盘 IO、网络吞吐,cAdvisor 管容器内,node_exporter 管宿主机,两者互补。Prometheus 按配置的抓取周期(默认 15 秒,即 scrape_interval)拉取这些指标并存储,Grafana 负责画面板,Alertmanager 按规则发告警。
一套最小可用的监控栈,用 compose 就能搭起来:
version: "3.9" services: cadvisor: image: google/cadvisor:latest container_name: cadvisor ports: - "8080:8080" volumes: - /:/rootfs:ro - /var/run:/var/run:ro - /sys:/sys:ro - /var/lib/docker/:/var/lib/docker:ro networks: - monitoring prometheus: image: prom/prometheus:latest container_name: prometheus volumes: - ./prometheus/prometheus.yml:/etc/prometheus/prometheus.yml ports: - "9090:9090" depends_on: - cadvisor networks: - monitoring grafana: image: grafana/grafana:latest container_name: grafana ports: - "3000:3000" environment: - GF_SECURITY_ADMIN_USER=admin - GF_SECURITY_ADMIN_PASSWORD=admin depends_on: - prometheus networks: - monitoring web: image: nginx:latest container_name: web networks: - monitoring networks: monitoring: driver: bridge
配套的 prometheus.yml 抓取配置只有十几行:global 段设置 scrape_interval 为 15s,scrape_configs 里定义一个名为 cadvisor 的 job,targets 指向 cadvisor:8080。启动后三个访问入口分别是:cAdvisor 的 8080 看单容器实时资源,Prometheus 的 9090 写 PromQL 查指标,Grafana 的 3000 用 admin 账号登录后添加 Prometheus 数据源、导入现成面板。验证指标链路是否打通,在 Grafana 里画一张容器 CPU 使用率的面板就够了。
监控链路的依赖关系用 mermaid 画出来,和上面的日志流向图互补:
六、结构化日志:让日志能被机器读
日志轮转解决磁盘问题,集中收集解决检索问题,还有一个决定检索质量的问题:日志格式。非结构化文本日志靠关键词搜,搜不到就抓瞎;结构化日志(JSON 格式)把字段拆开,按时间、级别、服务、请求 ID 精确过滤,排障效率高一个量级。
一条结构化日志长这样:{"ts":"2024-05-01T10:00:00Z","level":"error","service":"web","request_id":"abc123","msg":"db timeout"}。应用侧打日志时带上固定字段,日志驱动原样转发,检索端按字段筛。两个常用约定:请求 ID 贯穿一次请求的所有日志,排障时按 ID 一条线拉完;级别字段统一用 error、warn、info、debug 四种,别自创单词,否则过滤规则写起来很痛苦。
日志治理还有三个配套动作。保留策略:热数据留七天用于日常排障,冷数据归档压缩,超过留存期的定期清理——不管是 Elasticsearch 的索引生命周期还是 Loki 的保留配置,都要明确设置,否则集中存储早晚被日志填满。采样:访问日志这类高流量日志按比例采样,保留全量没意义,占资源却实打实。敏感信息脱敏:日志链路里加过滤,密码、token 打码再落库,这条和 4.2 的"日志不打密钥"呼应。
七、监控指标与告警思路
采集链路搭好之后,指标选什么、告警怎么定,决定监控系统是资产还是噪音。容器层看四个黄金信号:延迟,请求响应时间;流量,每秒请求数;错误,错误率与 5xx 比例;饱和度,CPU、内存、磁盘使用率。cAdvisor 给的 CPU、内存、网络、磁盘指标对应饱和度,应用层的延迟、流量、错误需要业务侧暴露 metrics 端点,Prometheus 定期抓取。
告警规则我们建议从三条起步,别贪多。容器反复重启:重启次数在时间窗内超过阈值,说明服务在崩溃循环。资源持续高水位:CPU 或内存持续 15 分钟超过 80%,限额可能定低了。健康检查失败:容器进入 unhealthy 状态。每条规则都要配好阈值、持续时间与通知渠道,误报率高的规则宁可删掉——告警疲劳比没有告警更危险,团队会习惯性忽略通知。
Grafana 面板遵循"从总到分":总览页看全栈状态,点进服务看单服务指标,再下钻到容器级。面板和告警规则都放进版本库,跟代码一起评审,改告警也要走提交记录。
通知渠道的选择也有讲究:值班群、邮件、短信按告警级别分——error 级进值班群并电话,warn 级只进群。监控数据本身要设保留策略,Prometheus 的本地存储默认保留 15 天,超过这个窗口的趋势对比要么扩展远程存储,要么接受限制。这些细节写进监控文档,团队值班时照着执行,别让告警到了人却不知道下一步该干嘛。
⚠️ 容器内应用写到文件里的日志,docker compose logs 永远看不到。日志必须打标准输出,否则驱动层捕获不到——这个坑在容器化第一天就要避开。
💡 监控先搭链路再谈告警。把 cAdvisor 加 Prometheus 加 Grafana 跑通、能查到指标,再逐步加 Alertmanager 规则;反过来先配一堆告警规则却没人看得懂面板,告警就变成狼来了。
要点速记
- json-file 默认无限增长:max-size 与 max-file 是生产配置底线,把单服务日志锁在固定大小内。
- 驱动切换改一行配置:syslog 接现有体系,journald 配 systemd,fluentd 走集中式。
- docker compose logs 按服务聚合:--tail、--since、-f 三个参数覆盖日常排障。
- 日志必须打标准输出:写到文件里的日志驱动捕获不到。
- 集中式日志两流派:ELK 重索引与检索,Loki 轻标签过滤,按日志量和团队选择。
- cAdvisor 管容器,node_exporter 管宿主机:两个采集器互补。
- 监控链路四件套:cAdvisor 采集、Prometheus 存储、Grafana 展示、Alertmanager 告警。
- 先有面板后有告警:链路通了再定规则,告警才有意义。
下一节处理最坏情况——备份与恢复策略,数据丢了怎么捞回来。