8.2 安全加固与清理命令:prune 全家桶与四件工事
8.2 安全加固与清理命令:prune 全家桶与四件工事
本节摘要:清理从来不是敲下某条 prune 就完事——Docker 的可回收对象有镜像、容器、卷、网络、构建缓存五大类,各有专属词条,影响面与危险等级完全不同。本节给一张清理矩阵与分级执行法,再补齐治理的四件工事:资源限额、健康检查、日志轮转、最小权限。治理的目标不是"清得狠",而是"清得准、防得住"。
本部收官讲治理。清理词条在前七部各露过面(image prune、container prune、volume prune),这里收拢成一张矩阵,按"动谁、删什么、多危险"对账;加固工事则是把事故苗头掐灭在配置里。两者的共同纪律:定期、有边界、可验证。
影响面矩阵:prune 全家桶对账
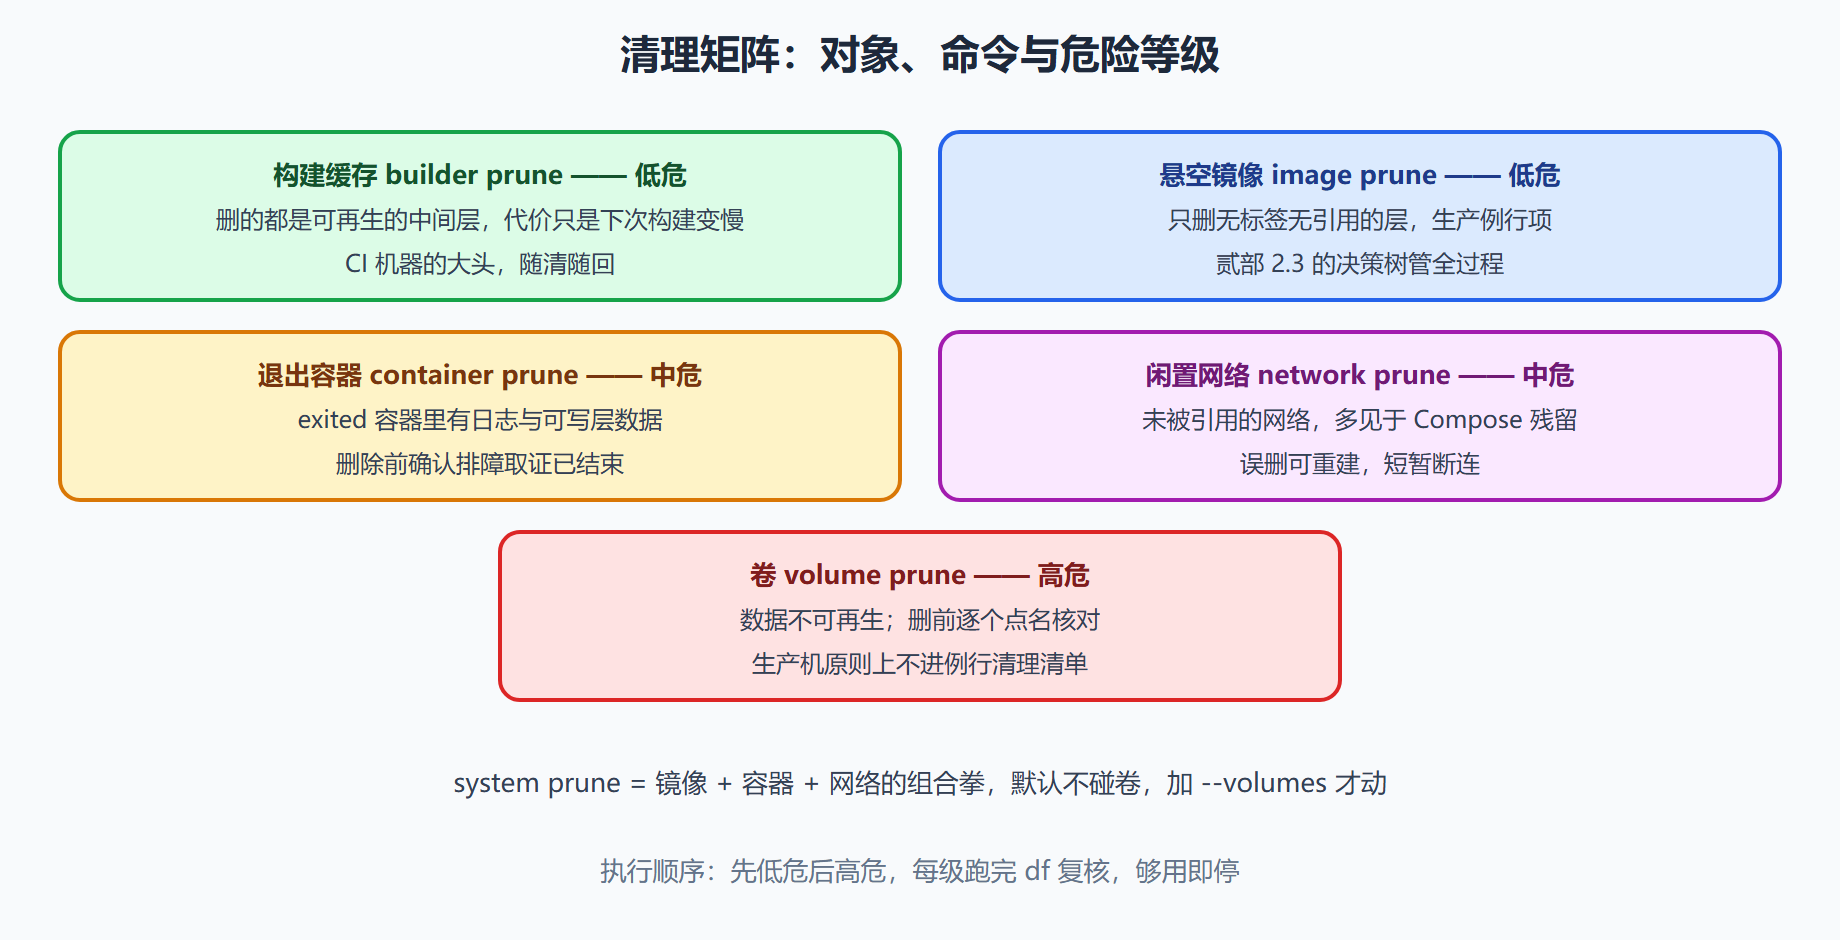
现场:一次分级清理的完整会话
$ docker system df TYPE TOTAL ACTIVE SIZE RECLAIMABLE Build Cache 214 0 6.2GB 6.2GB (100%) Images 42 12 18.4GB 12.1GB (65%) $ docker builder prune -f Total reclaimed space: 6.2GB $ docker image prune -f Total reclaimed space: 1.4GB $ docker container prune -f --filter "until=72h" $ df -h /var/lib/docker | tail -n 1 /dev/vda1 98G 55G 40G 58% /
分级纪律逐条兑现:先打最肥且可再生的构建缓存,再清悬空镜像,容器尸体限定"退出超过三天"(until 过滤),卷完全没动——58% 的水位已经健康,见好就收。system prune 一把梭的写法不建议在生产用:它把多个决策压缩进一条命令,影响面反而失控;分级执行的每一步都可停下、可解释。docker system prune --volumes 里那个 --volumes 是高危动作的显式确认位,看到它就该想起卷不可再生。
💡 把分级清理写成脚本进 cron,比每次手敲可靠:低危项每日,中危项每周带 until 过滤,高危项永远留给人肉。
加固工事:四件
工事一:资源限额。 叁部 3.2 的 --memory 与 --cpus 在治理视角下是防爆炸的围栏:
$ docker run -d --name api --memory 512m --cpus 1.5 myapi:2.0 $ docker inspect api --format '{{.HostConfig.Memory}} {{.HostConfig.NanoCpus}}' 536870912 1500000000
没有限额的容器可以把宿主机吃穿,拖死同机的所有邻居——限额不是性能调优,是隔离纪律。单机多服务一律配额。
工事二:健康检查。
$ docker run -d --name api --health-cmd "curl -fs localhost:9000/health || exit 1" \ --health-interval 30s --health-retries 3 myapi:2.0 $ docker inspect api --format '{{.State.Health.Status}}' healthy
进程活着不等于服务可用——健康检查把"可用"变成可观测状态(ps 里的 healthy 列、柒部的 service_healthy 依赖都消费它)。探针命令要轻、要打真实依赖,别写成永远成功的 echo。
工事三:日志轮转。 叁部 3.3 提过日志无声吃满磁盘的隐患,解药是守护进程配置:
{ "log-driver": "json-file", "log-opts": { "max-size": "10m", "max-file": "3" } }
每个容器最多保留三份十兆的日志段,超出自动滚动。改完要重启守护进程且只对新起的容器生效——存量容器要重建才享受轮转,这一点在上线配置时就得排进计划。
工事四:最小权限。 run 时把可给的权限都收回来:
$ docker run -d --name proxy --read-only \ --cap-drop ALL --cap-add NET_BIND_SERVICE \ --tmpfs /var/cache/nginx:size=64m \ --user 101:101 nginx:1.25
根文件系统只读(写入点用 tmpfs 单独开)、Linux 能力全部收回再按需加回(nginx 绑低端口需要 NET_BIND_SERVICE)、以非 root 用户运行。这套组合把容器被攻破后的行动半径压到最小。安全加固的词条逻辑与清理一致:影响面能小则小,每一步都可解释。
⚠️ 常见坑:--read-only 后应用写日志或临时文件直接报错——只读不是免检通行证,先盘点应用的全部写入点(日志、缓存、上传目录),逐个用卷或 tmpfs 开白名单,再切只读。
收尾现场:一次磁盘告警的完整处置
凌晨告警:宿主机磁盘用量过九成。按本节工事顺序走一遍:
$ docker system df TYPE TOTAL ACTIVE SIZE RECLAIMABLE Images 42 12 18.3GB 9.7GB (53%) Containers 15 3 2.1GB 1.9GB (92%) Local Volumes 28 9 30.6GB 0B Build Cache 210 0 6.4GB 6.4GB (100%)
读数定级:镜像可回收近十吉、构建缓存全可回收;卷的 RECLAIMABLE 是 0——因为存活容器都引用着卷,这个 0 正是"清理不会误伤业务数据"的机器背书。处置从最安全的层级开始:
$ docker builder prune -f $ docker container prune -f $ docker image prune -f $ docker system df TYPE TOTAL ACTIVE SIZE RECLAIMABLE Images 18 12 11.2GB 1.1GB (9%) Build Cache 0 0 0B 0B
三级下来磁盘回到六成半,全程没碰卷的选项——卷的处置永远走人工点名(伍部备份词条出清单,确认后再清)。复盘写进值班手册:告警阈值、清理顺序、每级的预期回收量,下次同类告警就是照单抓药。
本节要点回顾
- 五大类对象各有专属 prune:危险等级从构建缓存到卷依次升高,按级执行、够用即停。
- system prune 不等于清理规范:一把梭省的事故赔不起,高危的卷永远人工点名。
- 限额是隔离纪律:单机多服务必配 --memory 与 --cpus。
- 健康检查让"可用"可观测:探针打真实依赖,柒部的启动编排消费它。
- 轮转与最小权限是复发预防针:日志限幅、只读根、收能力、降用户。
诊断与治理都齐了。下一部把全书词条压成速查表——工位墙上贴的那种。