8.1 故障排查命令词条:inspect、events、system df 与五步问诊
8.1 故障排查命令词条:inspect、events、system df 与五步问诊
本节摘要:排错的本质是按固定顺序取证据。本节先立一条五步问诊路径(分类、遗言、档案、录像、盘点),再把三个核心词条讲透:docker inspect 按 format 抽字段、docker events 听守护进程的事件流、docker system df 盘点磁盘。异常容器反复重启与磁盘爆满两个综合症状全程示范。
运维群里的告警又响了:容器反复重启,原因不明。排错词条个个都在前文露过面,没有冷门货,难的是顺序——乱翻命令只会浪费时间。本节先把问诊路径立起来,再给核心词条,最后用两个综合症状走全程。
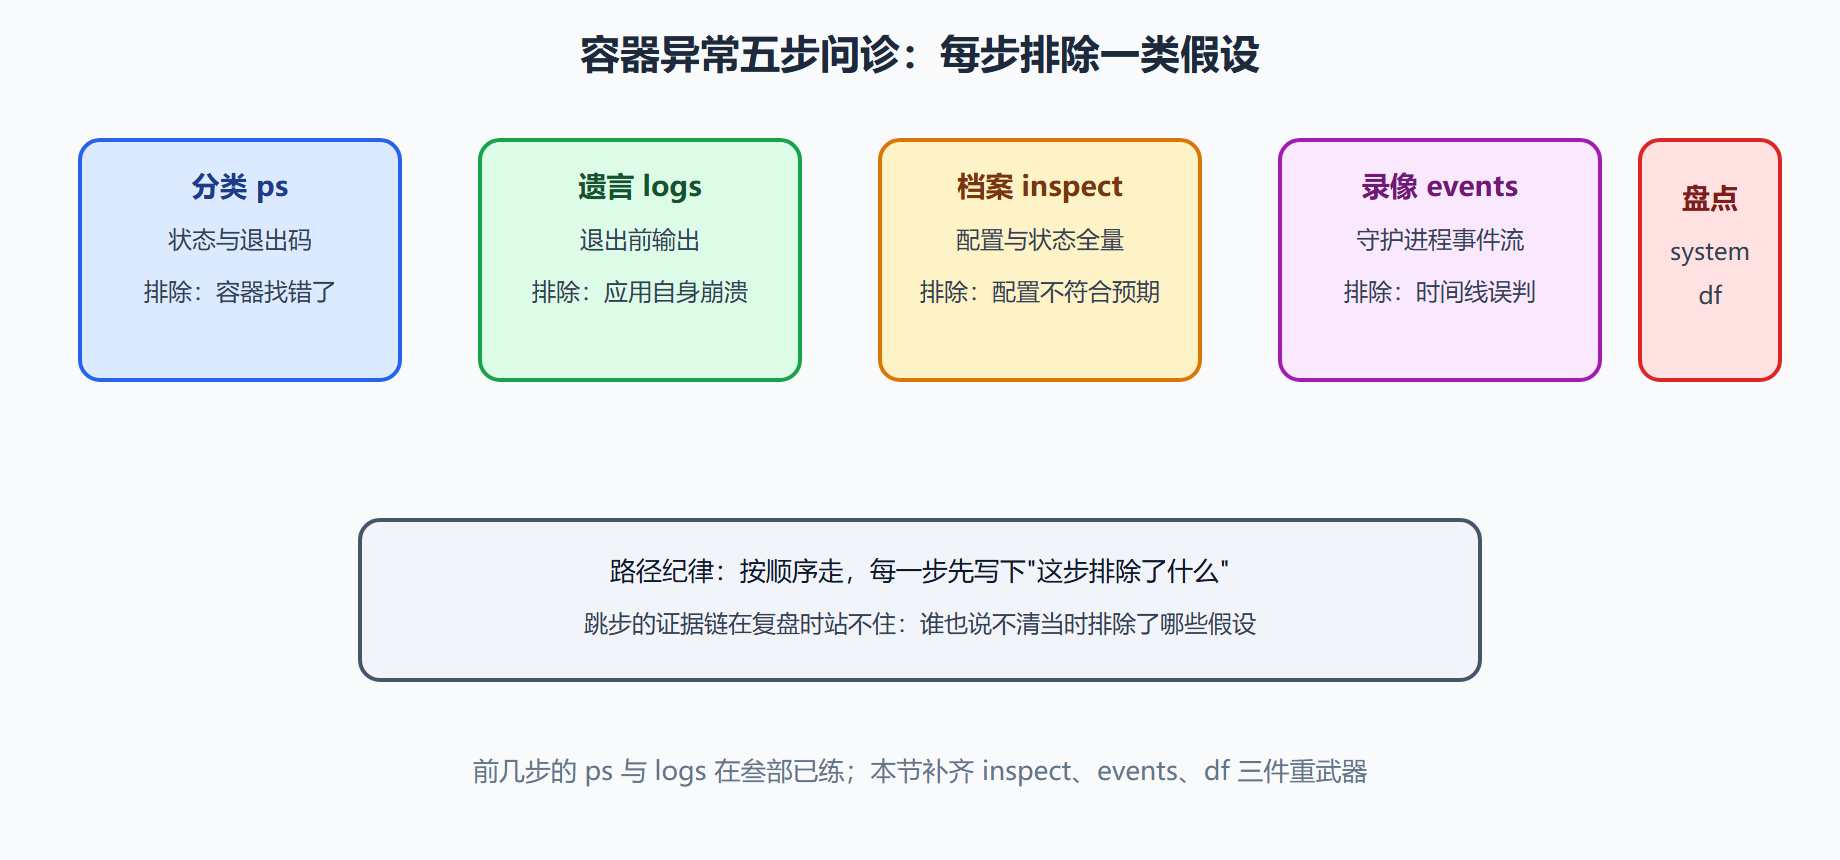
取证清单:五步问诊路径
词条卡:docker inspect
docker inspect [OPTIONS] 对象 [对象...]
容器、镜像、网络、卷通吃——inspect 是多态词条,给什么对象就回什么档案。全量 JSON 几百行没法肉眼读,--format 才是它的正确打开方式:
$ docker inspect web --format '{{.State.Status}} restarts={{.RestartCount}}' restarting restarts=7 $ docker inspect web --format '{{.State.ExitCode}} {{.State.Error}}' 137 $ docker inspect web --format '{{json .HostConfig.PortBindings}}' {"80/tcp":[{"HostIp":"","HostPort":"8080"}]}
抽字段的套路:先 docker inspect 全量输出里肉眼找到目标字段,再把路径写进 format 模板。State 区块看生死(Status、ExitCode、RestartCount、OOMKilled),HostConfig 区块查配置(端口、重启策略、资源限额),Mounts 与 NetworkSettings 查挂载与网络。OOMKilled 值得一提——它直接告诉你进程是不是被内存限额处决的,与叁部退出码 137 的判断互相印证。
词条卡:docker events
docker events [OPTIONS]
义项:--filter 按类型或对象过滤,--since 与 --until 取历史窗口。events 是守护进程的事件流水:容器生、死、重启、镜像推送、卷挂载,全部实时播报。
$ docker events --filter type=container --since 10m 2026-09-03T21:14:02 container die ... exitCode=137 image=myapi:2.0 name=api 2026-09-03T21:14:02 container kill ... signal=9 image=myapi:2.0 name=api 2026-09-03T21:14:03 container start ... image=myapi:2.0 name=api 2026-09-03T21:14:05 container oom ... image=myapi:2.0 name=api
这份回放把重启风暴的机制拍得明明白白:oom 事件(内存超限)在 die 与 start 之前反复出现——真相不是应用 bug,而是 3.2 给的 --memory 512m 限额被实际负载击穿。events 的价值就在时间线:logs 告诉你进程说了什么,events 告诉你守护进程做了什么,两相对照才能还原现场。
词条卡:docker system df
$ docker system df TYPE TOTAL ACTIVE SIZE RECLAIMABLE Images 42 12 18.4GB 12.1GB (65%) Containers 57 9 2.3GB 2.1GB (91%) Volumes 31 14 9.8GB 4.2GB (42%) Build Cache 214 0 6.2GB 6.2GB (100%)
磁盘问题的总账本。RECLAIMABLE 列是重点:镜像十几 GB 可回收多半是悬空与旧版本堆积;Build Cache 六个多 GB 全可回收是 CI 机器的常态;卷的可回收要格外谨慎——"未被引用"不等于"没价值",对照伍部的提醒先点名再删。加 -v 出明细账,按镜像逐个列体积。
⚠️ 常见坑:把"重启"当成应用故障死磕代码,而 events 里明晃晃一行 oom——配置问题装成应用问题,是排错里最贵的弯路。问诊路径把 events 放在 inspect 附近,就是为了尽早让基础设施自己开口。
综合:两个症状的完整问诊
症状甲:容器反复重启。ps -a 看退出码(137 疑似 OOM 或强杀)→ logs -n 看遗言 → inspect 的 State 区块核 OOMKilled 与 RestartCount → events --since 回放时间线 → 处置:调限额或修泄漏。
症状乙:磁盘爆满。df 确认是 Docker 根目录 → system df 分类盘点 → 按 RECLAIMABLE 从高到低:builder prune 清构建缓存、image prune 清悬空、container prune 清尸体 → 卷逐个点名后才动 → 配日志轮转与定期清理防复发(词条在下一节)。
症状丙:服务"活着但不对"
进程在、也不重启,但接口超时、响应变慢。这类最棘手,因为三条取证命令都读不出异常:logs 里没报错、退出码是 0、OOMKilled 为 false。此时按序补充取证:stats 看实时资源(CPU 顶满?内存贴着限额爬?)→ inspect 核对限额本身(限额给太低,应用在节流下挣扎)→ health 状态与探针输出(应用自认不健康多久了)→ events 里搜 restart 与 oom。慢病多数是资源账:限额、连接池、邻容器挤占,逐项对账才见底。
本节要点回顾
- 问诊按序走:分类、遗言、档案、录像、盘点,每步写下排除了什么。
- inspect 配 format 用:State 查生死、HostConfig 查配置,OOMKilled 是处决证据。
- events 是守护进程的行车记录仪:oom、die、start 的先后即真相。
- system df 先看 RECLAIMABLE:镜像与构建缓存通常是大头,卷要逐个点名。
- 配置问题常伪装成应用故障:让基础设施的事件先说话。
病看完了,该上治本的工事:分级清理矩阵与四件加固装备,下一节交底。