第5章 · 性能扩展与实践
第 5 章 · 性能扩展与实践
章节摘要:原 SOURCE 第 5–7 章合并为本章三节:内存/CPU 与大数据策略、nbextensions 与远程资源、项目结构与模块化/automation。读完应能 downcast 降内存、装 Table of Contents 等扩展、把重复逻辑
%run进模块,并用 papermill/nbconvert 思路批处理。
本节导航
阅读完本章,你应当能够:
- 用 downcast、del、生成器与 gc.collect() 控内存
- 用向量化与 multiprocessing 加速 CPU 密集段
- 安装 jupyter_contrib_nbextensions 并启用 TOC、ExecuteTime 等
- 组织项目目录、相对导入与 init.py 包结构
- 了解 papermill 参数化跑 Notebook 的方向
核心概念速览
金句:Notebook 性能 = 少占内存 + 少做 Python 循环 + 重活放模块里并行。
子章节导航
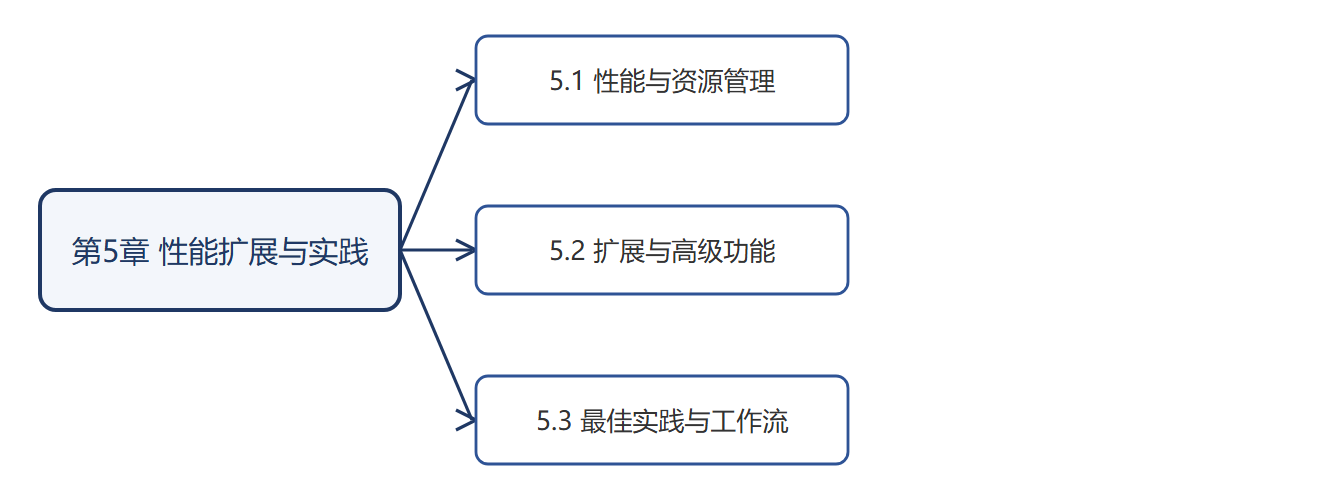
5.1 性能与资源管理
int8/downcast、del/gc、生成器、numpy 向量化、Dask、远程服务器要点。
5.2 扩展与高级功能
contrib nbextensions 安装、TOC/Codefolding/Variable Inspector/Notify。
5.3 最佳实践与工作流
项目结构、模块化 import、文档化、nbconvert 批处理与 papermill。
子章节之间的逻辑关系
资源不够 → 优化内存/CPU → 扩展提效 → 模块化防 Notebook 膨胀 → 自动化重复跑
前置知识与后续延伸
- 前置:第 1–4 章完整工作流
- 延伸:MLOps 可把 papermill + 调度器纳入 pipeline(超出本教程范围)
本章学习建议
本章是收尾章,把前三章的"快"升级为"稳":5.1 用 downcast、del、生成器和 %timeit 把内存和 CPU 控制在可控范围;5.2 通过 nbextensions 把长 Notebook 的导航、折叠、耗时统计补全;5.3 把可复用逻辑移进 src/ 模块,用 nbconvert/papermill 让重复任务自动化。建议用一个你已经做过 EDA 的 Notebook 做改造:先看 memory_usage 找最耗内存的列并 downcast,再装 Table of Contents 体验长文档导航,最后把清洗函数抽进 .py 用 %run 调回来。改造前后对比运行时间与内存数字,比任何口头建议都有说服力。
本章结构图
本章收尾自测
读完本章,请用你最近做过的一份分析来对照:内存是否优化过、长 Notebook 是否有目录导航、可复用代码是否已下沉到模块、重复任务是否已自动化。四项里做到三项,本章的"性能、扩展、实践"三块才算落地。本章结束后,建议回 00 导读对照"章节地图"做一次完整自查,缺哪补哪。
本章与全书的串联
第 5 章的每项技术都能在全书找到对应:downcast 依赖 3.2 的类型意识,模块化承接 2.4 的代码风格,nbconvert 复用第 4 章的导出经验。收尾时把全书五章串成一条线——环境做对、代码写好、数据探索快、协作干净、性能可控——你得到的不再是零散技巧,而是一套可复现的分析工作流。