5.3 最佳实践与工作流
5.3 最佳实践与工作流
本节摘要:合并 SOURCE 第 7 章(项目结构、模块化、文档化、自动化)与 6.3 集成工具要点:Notebook 做叙事与实验,重复逻辑进
.py包;用 nbconvert/papermill 批跑;Mermaid 在 Markdown 格记录 pipeline。本节给出可复制的目录约定与%run导入模式。
本节导读
阅读完本节,你应当能够:
- 设计「notebooks/ + src/ + data/」项目结构
- 把函数移到模块并在 Notebook 中 import 或 %run
- 用 Markdown 与 docstring 双层文档化
- 了解 papermill 参数化执行与 nbconvert 批量导出思路
一、项目结构(SOURCE 7.1)
推荐 ASCII 布局:
project/ ├── data/ # 原始与中间数据(大文件不进 Git) ├── src/ # 可复用 Python 包 │ ├── __init__.py │ └── features.py ├── notebooks/ # 叙事型 ipynb ├── requirements.txt └── README.md
Notebook 只保留「假设→实验→结论」;features.py 放清洗与特征函数——Git diff 友好。
二、模块化(SOURCE 7.2 / 9 节)
SOURCE intro 第 9 节:
- 相关函数放同一 .py 模块
- Notebook 里
from src.features import clean_df或%run ../src/setup.py - 包目录加
__init__.py标记 Python package - 相对导入避免硬编码绝对路径(包内
from .utils import foo)
三、文档化(SOURCE 7.3)
- Markdown 格:业务背景、结论、限制
- 代码 docstring:Args/Returns(2.4 节 calculate_average 范例)
- 00 导读级 requirements:Python/pandas 版本
SOURCE intro 第 8 节 Mermaid 可在 Markdown 格画 pipeline——与数据图分工(3.3 节)。
四、自动化与批处理(SOURCE 7.4)
方向性工具(不写安装脚本路径):
| 工具 | 用途 |
|---|---|
| nbconvert | 批量 ipynb → HTML/脚本 |
| papermill | 参数化注入后顺序执行 Notebook |
| Makefile/CI | 定时 Run All 回归 |
示例 papermill 概念:
papermill input.ipynb output.ipynb -p start_date 2024-01-01
Notebook 内用 parameters 标签格接收 start_date——适合日报型分析。
五、收尾习惯清单
SOURCE 第 10 节与其它章交叉:
- Restart & Run All 交付前验收
- Clear All Output 再 commit
- Kernel 与 requirements 写进导读
- 巨型输出用 Cell → Current Outputs → Clear
⚠️ 常见坑:%run 的模块改完后需 重新 %run 或 importlib.reload——否则仍用旧函数定义。
💡 关键直觉:成熟项目里 Notebook 是「论文草稿」,模块是「正式 API」——别让草稿变成唯一真相源。
本节速览
- notebooks/ + src/ 分离
- import / %run + init.py
- Markdown + docstring 双文档
- papermill / nbconvert 批处理
- Run All + Clear Output 交付
全教程完结。回到 00 导读 用四层栈自查:内核、单元格、Magic/数据、协作导出是否都已实践。
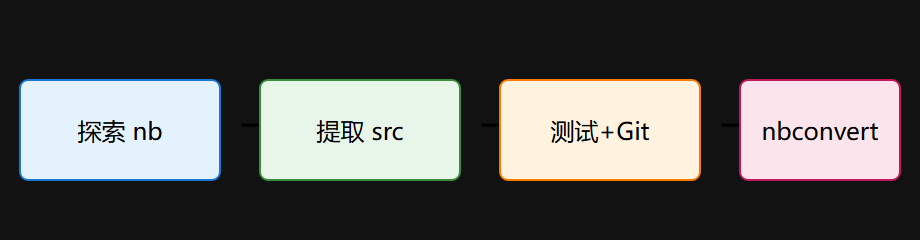
从探索到交付的完整路线
一次典型项目在 Notebook 里的生命周期:
1. 数据进来:read_csv + head/info/describe 摸底(第3章) 2. 清洗与特征:可复现脚本沉淀到 src/features.py(第5章) 3. 实验与验证:Notebook 里写短代码格,%run 调用 src 模块 4. 结论输出:Markdown 格写结论 + Mermaid 画流程 5. 交付:nbconvert 导出 HTML 给业务,Git 提交无输出 ipynb
模块与 Notebook 的同步技巧
用 %run 拉进 Notebook 的模块,改完必须重新 %run 才能生效,因为普通 import 会命中缓存。开发期可以在笔记本顶部统一放一个"加载模块"单元格,每次改动后重跑这一格。正式代码仍建议用 from src.features import clean_df 的常规 import,配合 importlib.reload 做开发期热加载。
papermill 参数化的适用边界
papermill 适合"同一套逻辑、不同参数反复跑"的场景,比如日报、多市场报表。它在 Notebook 开头注入 parameters 单元格,输出到指定文件。过度使用会引入 Notebook 模板的维护成本——如果你的参数组合超过两位数,直接把逻辑抽成 Python 函数加命令行参数更干净。
目录约定示例
project/ ├── data/raw/ # 原始数据,只读不写 ├── data/processed/ # 清洗后中间数据 ├── src/ # 可复用 Python 包 ├── notebooks/ # 探索与汇报 Notebook ├── reports/ # nbconvert 导出的 HTML/PDF ├── requirements.txt └── README.md
关键约定有两条:原始数据只读,processed 可重建。前者防止误改源头,后者保证任何中间结果都能从 raw + 脚本重跑出来,这是"可复现"的最低标准。
每周复盘清单
建议每两周做一次复盘,检查自己的 Notebook 习惯是否在退化:
- 是否每份交付的 Notebook 都能 Restart & Run All 一次通过?
- 是否还有超过一屏的巨型代码格没拆?
- 可复用的清洗/特征函数是否仍散落在 Notebook 里,没进 src/?
- 是否记得 Clear Output 再提交?
把复盘结果记在团队共享文档,比一次大整改更容易坚持。
从"能跑"到"可维护"
效率的终点不是把单次运行跑得最快,而是让下一份分析不用重头踩坑。每份 Notebook 多花十分钟做的 schema 记录、清洗函数下沉、结论格标注,会在三个月后、十份 Notebook 之后,成倍地省回时间。这也是本教程贯穿始终的"动手优先"的落点。
工作流中的文档接力
Notebook 是探索载体,但最终要变成团队资产。每次结项,把三样东西写进 README:数据怎么来、环境怎么搭、结果怎么看。这三段接力文档比 Notebook 本身更能让下一个人快速上手,也避免了"源码在、文档没"的常见结局。
收尾:让下次更轻松
做完一个项目别急着清空目录。留一份"复盘格"记录:哪些步骤这次走了弯路、哪些函数值得沉淀、下次同样的任务有哪些现成资产可用。积累三五个项目后,这套模板会显著压缩你下一次从零开始的时间,这也是本章"最佳实践"最实在的回报。
小型团队的协作约定
两三个人的小团队不需要复杂流程,但要守住三条约定:Notebook 目录按项目分、提交前跑一次 Run All、可复用函数必须进 src/。三条约定一旦破例,混乱会很快扩散到所有项目。约定越简单,越容易长期坚持。
完结后的清单归档
项目收尾时,把"用什么数据、跑什么脚本、出什么结果、结论是什么"整理进项目 README,并保留一份可运行的版本号记录。归档的意义在于:半年后同事问起"那个结论怎么来的",你能在十分钟内给出完整链路,而不是靠回忆。