堆与TopK问题
3.2 堆与 TopK 问题
本节摘要:堆是为"反复取最值"定制的结构。本节从完全二叉树的数组表示讲起,掌握上浮与下沉两个基本操作,然后用"最大的前 k 个数"对比全排序、小顶堆、快速选择三种方案的复杂度与适用场景,最后讨论堆在动态数据流里不可替代的地位。
为什么排序解决不了这个问题
上一章末尾的双指针一节教我们先看问题结构;本节的问题是种很特殊的结构:数据不断流入,随时要当前的最大的前几个。静态地看,可以攒够一把全部排序再取前 k;可数据流不停,每来个新元素就重排一次,代价无法承受。真正的瓶颈被锁定在两个操作上:插入新元素、取出当前最值。排序对这两个操作的支持都是灾难性的,而堆把插入与取最值都做到 O(log n)、查看最值 O(1)。这就是堆的全部存在理由——它不追求全局有序,只保证堆顶是最值,用最小代价维护这个局部事实。
一、数组里的完全二叉树
堆是一棵完全二叉树(除最后一层外全满、最后一层左对齐),而完全二叉树有个妙处:可以直接装进数组,不需要任何指针。下标 i 的元素,左孩子在 i 乘 2 加 1,右孩子在 i 乘 2 加 2,父节点在 i 减一整除 2。小顶堆要求每个父节点不大于其孩子,于是最小值永远在下标处;大顶堆反之。
class MinHeap: def __init__(self): self.a = [] def push(self, x): self.a.append(x) self._sift_up(len(self.a) - 1) def pop(self): top = self.a[0] last = self.a.pop() if self.a: self.a[0] = last self._sift_down(0) return top def _sift_up(self, i): # 上浮:和父节点比,小就换 while i > 0: p = (i - 1) // 2 if self.a[i] < self.a[p]: self.a[i], self.a[p] = self.a[p], self.a[i] i = p else: break def _sift_down(self, i): # 下沉:和较小的孩子比,大就换 n = len(self.a) while True: l, r, m = 2 * i + 1, 2 * i + 2, i if l < n and self.a[l] < self.a[m]: m = l if r < n and self.a[r] < self.a[m]: m = r if m == i: break self.a[i], self.a[m] = self.a[m], self.a[i] i = m h = MinHeap() for x in [5, 3, 8, 1, 9]: h.push(x) print([h.pop() for _ in range(5)]) # 输出 [1, 3, 5, 8, 9]
上浮与下沉的路径都是树高,即 O(log n)。日常工程直接用标准库:Python 的 heapq(小顶堆,大顶堆靠取负模拟)、Java 的 PriorityQueue。面试手写堆的概率不高,但上浮下沉必须能讲清,因为堆化思想常被嵌进别的题。
二、TopK 三方案的对比
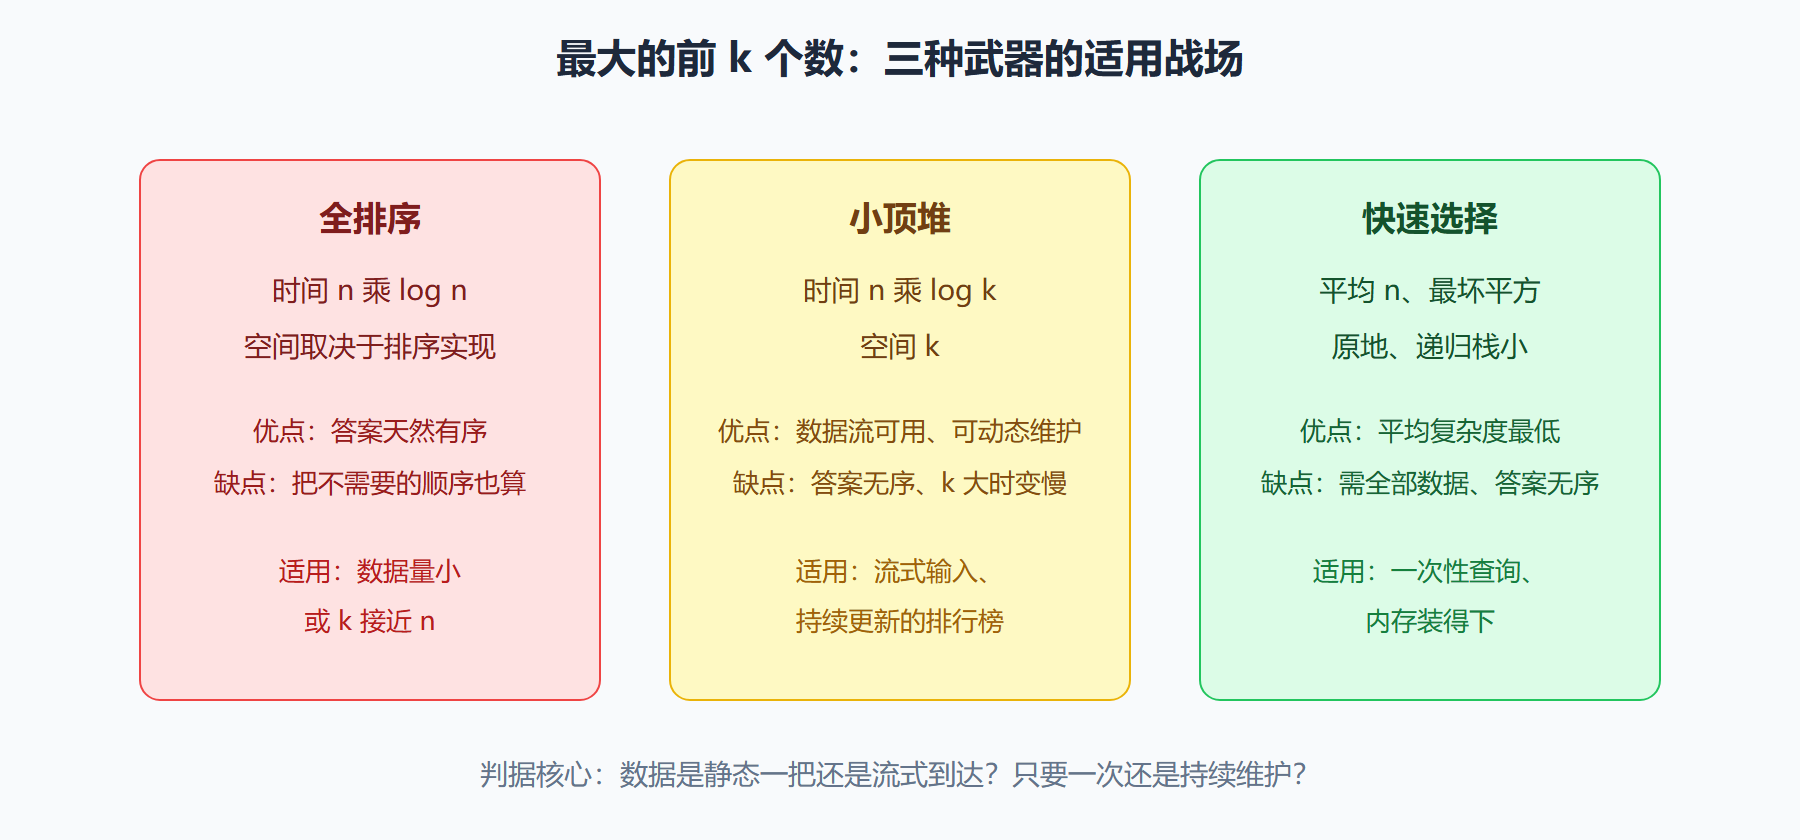
问题:从 n 个数里找最大的 k 个。方案一,全排序取前 k:O(n log n) 时间,简单粗暴,k 接近 n 或只需答次时反而合理。方案二,维护大小为 k 的小顶堆:扫一遍数组,堆不满就放,堆满且当前数大于堆顶才替换堆顶并下沉;结束时的堆就是答案。时间 O(n log k),空间 O(k)——注意是"最大的 k 个用小顶堆",堆顶是这 k 个里最小的、最先被淘汰,逻辑上自洽却最反直觉,务必亲手推一遍。
import heapq def top_k(nums, k): heap = [] for x in nums: if len(heap) < k: heapq.heappush(heap, x) elif x > heap[0]: heapq.heapreplace(heap, x) # 弹堆顶、放新值,一趟下沉 return heap print(top_k([3, 1, 7, 5, 9, 2, 8], 3)) # 输出 [7, 8, 9](堆内无序,但都是前三)
方案三,快速选择:借用快排的分区思想,基准就位后看它的下标与第 k 大位置的关系,只递归需要的那一半。平均 O(n),最坏 O(n 的平方)(随机化基准后最坏概率极低),代价是答案无序且必须一次性持有全部数据。选择口诀:数据能全放内存、只问次 → 快速选择最快;数据流式到达或要动态维护 → 小顶堆;数据量小或 k 接近 n → 直接排序别折腾。
TopK 三方案复杂度与场景对比
三、堆的变式与边界
堆题的变式路线很清晰:频率类(前 k 个高频元素,先哈希计数再对小顶堆按频率比较);双堆类(数据流中位数,大顶堆放较小半边、小顶堆放较大半边,两堆大小差不超过一,中位数从堆顶取);归并类(合并 k 个有序链表,k 路归并用小顶堆维护 k 个当前头节点)。边界上注意三处:堆空时取顶是错误源,先判空;k 大于元素个数时按题意返回全部还是报错要确认;自定义比较对象(按频率、按距离)时 Python 用 heapq 传元组、Java 用比较器,比较键写成元组时注意第二键的排序方向。堆的中位数双堆解法建议完整手写一遍,它是"堆维护动态最值"这一存在理由的最佳注脚。
四、堆在工程中的真实落点
面试官常追问"工业界哪里用堆",有几个现成答案值得备好。延迟队列:消息队列里"这条消息十分钟后投递"的需求,底层就是按执行时间组织的小顶堆或时间轮,堆顶即下一个到期的任务。合并 k 个有序日志文件:k 路归并,小顶堆维护 k 个文件的当前行,每次弹最小写输出、补对应文件的下一行,总耗时 n 乘 log k——这题既是 LeetCode 第 23 题也是日志归并的真实实现。中位数维护:数据流场景双堆方案,大顶堆存较小一半、小顶堆存较大一半,两堆大小差恒不超过一,中位数随时可从堆顶读出,插入 O(log n)、查询 O(1),是数据库分位数近似统计的雏形。
import heapq def merge_k_sorted(lists): heap = [(lst[0], i, 0) for i, lst in enumerate(lists) if lst] heapq.heapify(heap) out = [] while heap: v, i, j = heapq.heappop(heap) out.append(v) if j + 1 < len(lists[i]): heapq.heappush(heap, (lists[i][j + 1], i, j + 1)) return out print(merge_k_sorted([[1, 4, 7], [2, 5, 8], [3, 6, 9]])) # 输出 [1, 2, 3, 4, 5, 6, 7, 8, 9]
注意 Python 元组入堆时比较键的顺序:先比值、再比列表编号、再比下标,编号充当初值保证不会去比较无法比较的对象——这个细节在自定义堆题里极易翻车,值得记住。手写堆的场景下还要注意下沉时"与较小的孩子交换"而不是"与任意较小的孩子交换",选错孩子会破坏堆序,这是手写堆最常见的错误。
本节要点回顾
- 堆的存在理由:插入与取最值都是 O(log n)、看最值 O(1),专治动态最值场景;
- 数组表示完全二叉树:父子下标靠乘二加一、减一整除二,指针都不需要;
- 上浮与下沉是堆仅有的两个基本动作,所有堆操作都是它们的组合;
- TopK 选型:静态一次性用快速选择,流式或动态用小顶堆,量小直接排序;
- 最大的 k 个用小顶堆反直觉但自洽,堆顶是候选区里的守门员。
下一节前缀树:当查询从"找值"变成"找前缀",哈希表也束手无策,公共前缀的共享路径成了新武器。