2.4 数据库服务:关系型与 NoSQL
2.4 数据库服务:关系型与 NoSQL
本节摘要:数据库服务(DBaaS)让你"租用"数据库而不是自己搭建维护,核心形态分三类:关系型数据库保一致性强、支持 ACID 事务,适合订单、账务等强一致场景;NoSQL 数据库牺牲一部分一致性换取扩展性与性能,适合高并发、灵活结构的数据;数据仓库专为分析查询设计,读写分离、按列存储。本节给出三类数据库的对比与选型路径,帮你不再被"MongoDB 还是 MySQL"这类问题困住。
本节导读
阅读完本节,你应当能够:
- 解释数据库即服务(DBaaS)替你管了什么、没替你管什么。
- 对比关系型、NoSQL、数据仓库三类数据库的一致性、扩展性与典型用途。
- 说出关系型数据库支持 ACID 事务意味着什么,以及它的扩展代价。
- 针对订单系统、用户会话缓存、经营分析报表三种场景,各选一类合适的数据库。
一、问题与直觉
以前搭一套系统,数据库是要"养"的:买服务器、装软件、调参数、做备份、处理故障,一整套脏活累活。云上的数据库服务(DBaaS,Database as a Service)把"养数据库"这件事外包给了云厂商——你提交一个申请,平台给你一个可用的数据库连接地址,补丁、备份、高可用它管,你只管用。
但"替你管服务器"不等于"替你设计数据库"。库表结构、索引、SQL 写得烂,云厂商也救不了你。而且数据库选型比计算选型更纠结,因为它的切换成本极高——数据迁移是把整个历史搬一遍,几乎没人愿意轻易换库。所以这一节的目标很直接:让你在"下单之前"就选对数据库类型,少走一次大工程。
二、核心原理
2.1 关系型数据库:强一致的"台账本"
关系型数据库(如 MySQL、PostgreSQL、SQL Server)基于关系模型,用表和表之间的关系组织数据,支持结构化查询语言 SQL。它的看家本领是 ACID 事务——原子性、一致性、隔离性、持久性——保证多步操作要么全成功要么全回滚,不会出现"扣了钱但订单没建"这种中间态。
ACID 的代价是扩展性受限:关系型数据库的分布式改造复杂,读写分离和分库分表都要付出不小的心智成本。对大多数中小系统来说,一台主库 + 若干只读从库已经够用。
2.2 NoSQL:扩展优先的"便签本"
NoSQL 是非关系型数据库的总称,家族成员众多:文档型(MongoDB)、键值型(Redis)、列族型(Cassandra、HBase)、图数据库(Neo4j)等。它们共同点是弱化强一致性,换来自动分片、横向扩展和高吞吐。Redis 这类键值库还能把数据放内存里,读写性能达到微秒级。
NoSQL 适合:高并发读写(如会话缓存、计数器)、数据模型灵活多变(如用户自定义字段)、海量数据需要横向扩展(如日志流水)。代价是:通常不支持多表关联事务,数据一致性要靠应用层补偿。选择 NoSQL 意味着你接受"用应用逻辑换数据库扩展性"。
2.3 数据仓库:给分析用的"图书馆索引"
数据仓库(Data Warehouse)不是给在线业务写的,而是给"分析"读的:它把来自多个系统的数据清洗、建模后集中存放,支撑报表、BI、经营分析。关系型数据库也可以跑分析,但面对海量历史数据、复杂聚合查询,列式存储的数据仓库明显更高效。
数据仓库的典型特征是"写入低频、查询复杂、按主题组织"。它和在线业务库(OLTP)是两种物种:OLTP 管"当下这笔交易",数据仓库管"过去所有交易的规律"。典型产品如 AWS Redshift、Google BigQuery、Azure Synapse,以及很多开源方案。
2.4 数据库即服务替你做与不替你做
DBaaS 替你管:数据库服务器的部署、补丁、备份、高可用切换、基础监控。它不替你管:库表结构设计、索引设计、慢查询优化、容量规划、数据模型与业务逻辑的匹配。一句话:它把"养数据库"外包了,"用数据库"还是你的手艺活。
三、工程实践要点
3.1 三类数据库对比
| 维度 | 关系型 | NoSQL | 数据仓库 |
|---|---|---|---|
| 一致性 | 强(ACID) | 较弱(最终一致) | 分析用途 |
| 扩展方式 | 主从/分库分表 | 自动分片、横向扩展 | 节点扩展 |
| 读性能 | 中 | 高(尤其键值型) | 聚合查询快 |
| 典型场景 | 订单、账务、ERP | 缓存、会话、日志、灵活结构 | 报表、BI、分析 |
| 典型产品 | MySQL、PostgreSQL | MongoDB、Redis、Cassandra | Redshift、BigQuery |
3.2 选型路径
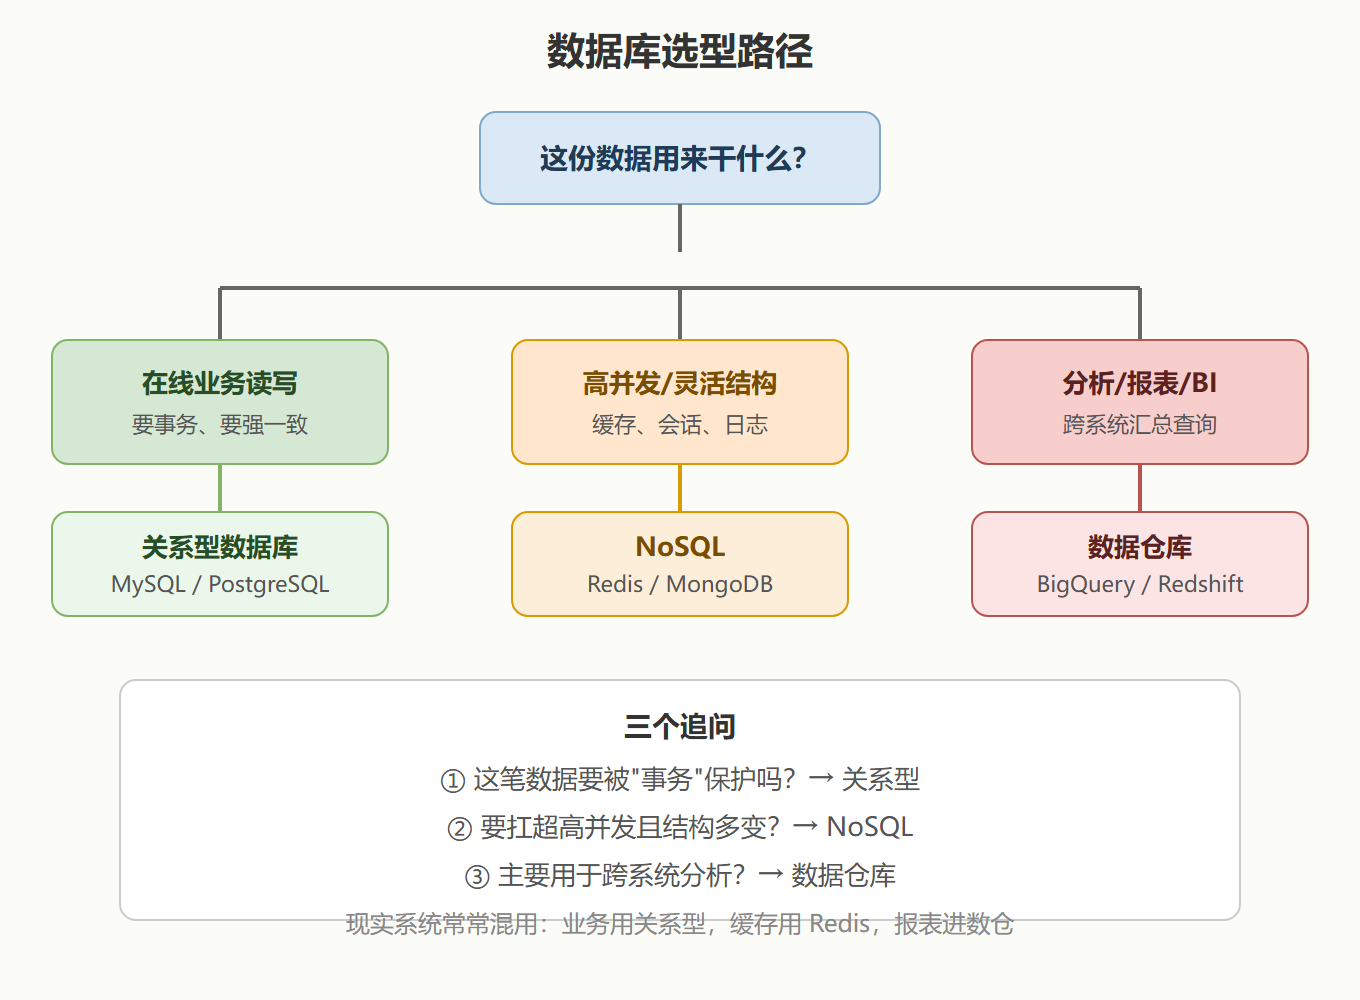
⚠️ 常见坑:把"关系型最稳"当成万金油。高并发缓存场景硬用关系型,会发现它扛不住读写压力;反过来,拿 NoSQL 存账务,又会在"钱对不上"时追悔莫及。先想清楚数据的一致性要求,再选技术。
💡 关键直觉:数据库选型的本质是"用一致性换性能"的交易。对账务这类"一分钱都不能错"的数据,用关系型;对点赞数、在线状态这类"晚一秒看到也没关系"的数据,用 NoSQL。
3.3 缓存的特殊地位
提到 NoSQL,Redis 几乎必被点名,因为它在几乎所有互联网架构里都以"缓存"身份出现。它的价值不是存储而是"把热数据放内存里,让读请求不再打到数据库"。一个典型做法是:业务读写先走 Redis,命中直接返回;未命中再查数据库并回填缓存。缓存能挡住 90% 以上的重复读请求,数据库的压力立刻降下来。
但缓存也带来经典难题:缓存与数据库的一致性。删缓存还是更新缓存、先更新库还是先删缓存,都有讲究,处理不当会出现"数据库是新值、缓存是旧值"的脏读。第 5 章讲分布式时会再碰这个问题,这里先记住一句话:缓存是性能的加速器,也是一致性的放大器,别在无必要时引入。
四、常见问题(FAQ)
Q1:MySQL 和 PostgreSQL 怎么选?
两个都是优秀的关系型数据库。简单判断:MySQL 生态更普及、运维资料多,PostgreSQL 功能更全(JSON、空间、全文检索内置),对复杂查询更友好。选你团队更熟的,比选"理论上更优"的更实际——数据库的坑往往出在人不熟的地方。
Q2:NoSQL 是完全不用 SQL 吗?
不是。现在的趋势是"NewSQL"——NoSQL 数据库也在提供 SQL 兼容接口(如 MongoDB 的聚合框架、Cassandra 的 CQL),方便开发者上手。分类的意义在于数据模型与一致性模型,而不在于"用不用 SQL"这个表面问题。
Q3:数据仓库能直接用关系型数据库替代吗?
小规模可以,规模大了不行。关系型数据库按行存储,做跨表聚合要全表扫描,数据量一大查询就慢;数据仓库按列存储,聚合查询只读需要的列,配合分区、压缩,性能差距随数据量拉大。分析场景从第一天上数据仓库,比后来迁移省事得多。
Q4:DBaaS 的备份我不用管了吗?
备份动作平台做,但"备份策略要你定":备份频率、保留时长、是否异地复制,都影响恢复点目标(RPO)。平台默认值不一定适合你的业务。第 3.5 节容灾会展开讲 RPO 和恢复时间目标(RTO),这里先记住:备份是共担责任,策略得自己拍板。
Q5:图数据库算什么?
图数据库是 NoSQL 的分支,专门建模"实体与关系",适合社交关系、推荐、权限网络这类"关系即数据"的场景。它是"给关系建模的专门工具",不是通用替代品,用的时候要问自己:我真的需要关系遍历性能吗?
五、数据库性能的三个基本动作
选对了类型只是起点,运行中的数据库还要面对性能问题。云上数据库最常见的三类问题与应对,值得在选型阶段就建立意识。
第一个动作是索引。没有索引的查询是"把整本台账从头翻到尾",加了索引就像给台账建了目录。索引设计的原则是"查询驱动":看慢查询日志里哪些 WHERE、JOIN 条件高频出现,给这些列建索引;索引也不是越多越好,每个索引都占用写入成本,建得多反而拖慢写性能。索引调优是性价比最高的数据库优化,没有之一。
第二个动作是读写分离与连接池。读多写少的业务,把读流量引到只读从库,主库只扛写入;应用侧用连接池管理数据库连接,避免频繁建连的开销。这两件事做对,数据库压力通常能降下一大截,而它们恰好都是 DBaaS 平台的基础能力,配置即可用。
第三个动作是慢查询治理。开启慢查询日志,定期分析耗时排名靠前的语句,逐个优化:改写低效 SQL、补索引、拆大事务。很多"数据库性能差"的案子,最后都落在几条写得糟糕的 SQL 上,而不是数据库本身不行。所以别急着给数据库加规格——先看慢查询,钱可能白花。
一句话总结数据库运维的投入优先级:索引 > 读写分离 > 慢查询治理 > 加配置。云厂商替你管了服务器,这四件事却永远是自己的功课。第 3.2 节监控会告诉你这些指标从哪里看。
顺带一提:选择数据库服务时,别只看"免费额度"或"最便宜的套餐"。数据库成本的主体往往在运行后的"存储增长"与"IOPS 消耗"上,前期估算时把三年数据量画一条增长曲线,比省那点起步价更实在。这也是为什么第 3.4 节成本管理会反复强调"把账单拆到资源与时间两个维度"。
要点速记
- 关系型:ACID 事务保证强一致,适合订单、账务,扩展代价高。
- NoSQL:弱一致换扩展与性能,适合缓存、会话、灵活结构数据。
- 数据仓库:列式存储、专为分析设计,适合报表与 BI,与在线库是两种物种。
- DBaaS 边界:平台管"养库"(补丁/备份/高可用),你管"用库"(建模/索引/调优)。
- 选型路径:要事务用关系型,要扛并发结构多变用 NoSQL,要跨系统分析用数据仓库。
- 缓存地位:Redis 类缓存挡重复读,但引入一致性复杂度,按需引入。
- 切换成本:数据库迁移是大工程,选型务必下单前想清楚。
业务运行的核心四件套讲完了。但一座城市只有房子和路还不够,还要有安保系统——下一节讲安全与身份管理服务,看看云上的"门禁"由哪些组件构成。