2.6 大数据与分析服务
2.6 大数据与分析服务
本节摘要:大数据与分析服务是一条"数据进来到结论出去"的流水线:数据湖先把所有原料收进来,数据仓库存放清洗建模好的成品,批处理与流处理引擎完成计算,可视化与 BI 工具把结果呈现给决策者。本节拆解这条流水线的每个环节,讲清数据湖与数据仓库的差别、批处理与流处理的取舍,帮你理解"数据分析上云"到底在买什么。
读前必看
阅读完本节,你应当能够:
- 描述数据湖、数据仓库、处理引擎、可视化工具在数据流水线中的各自位置。
- 对比数据湖与数据仓库在数据结构、用途、治理复杂度上的差异。
- 解释批处理与流处理的不同场景,并举例。
- 说出大数据项目最常见的失败原因:数据治理与需求错配。
一、问题与直觉
业务跑起来了,数据攒了一大堆——订单、日志、用户行为、设备上报。这时候老板问:这些数据能告诉我们什么?你突然发现,数据躺在各个系统的数据库和存储桶里,格式五花八门,要回答"上周各渠道转化率"都得手动导好几张表再拼。
大数据与分析服务解决的就是这个:让"一堆散落的数据"变成"一个能回答问题的数据平台"。它不只是一套存储,而是一条完整流水线——从收集、存储、处理到呈现。上云的好处是这条流水线不用自己从零搭:云厂商提供现成的数据湖、仓库、计算引擎、BI 工具,你按需组合。
但要泼一盆冷水:数据平台最大的坑不是技术,是"先有了数据,才想要答案"还是"先有答案,再找数据"。后者能跑通,前者大概率烂尾——数据收了一大堆,根本没人知道拿来干什么。所以读本节时,先把"我的问题是什么"放在脑子里,再看流水线怎么搭。
二、核心原理
2.1 数据湖:原料仓库
数据湖(Data Lake)把各种来源、各种格式的数据"原样"集中存放——结构化的表、半结构化的 JSON、非结构化的图片日志,全部先进来再说。它的底座几乎都是对象存储(呼应第 2.2 节),因为只有对象存储的容量与成本扛得住"什么都存"。
数据湖的优点是"先存后想",缺点是"先存后想"——如果不做治理,湖很快就会变成"数据沼泽":数据在,但没人知道里面是什么、能不能信、谁在用。所以数据湖不是"往里面扔数据",而是配套元数据管理、数据目录、访问控制一起用。
2.2 数据仓库:成品仓库
数据仓库(Data Warehouse)存放"已经清洗、建模、按主题组织"的结构化数据,专为查询与分析设计。它的数据来自数据湖(或直接来自业务系统),经过抽取、转换、加载(ETL)后落仓。数据仓库支持复杂的聚合查询,配合列式存储,分析性能远优于直接在业务库里跑。
数据仓库与数据湖的分工可以记成一句话:湖存原料,仓存成品;湖里先存起来,仓里洗好待用。 数据工程师的工作,就是不停地把湖里的原料洗成仓里的成品。
2.3 批处理与流处理:两种烹饪方式
处理引擎分两大类。批处理(Batch):把积累的数据按批统一处理,适合"跑一次全量报表、算一次全量指标",代表作如 Hadoop MapReduce、Spark。流处理(Streaming):数据一条条实时处理,适合"实时监控、实时推荐、异常检测",代表作如 Kafka Streams、Flink。
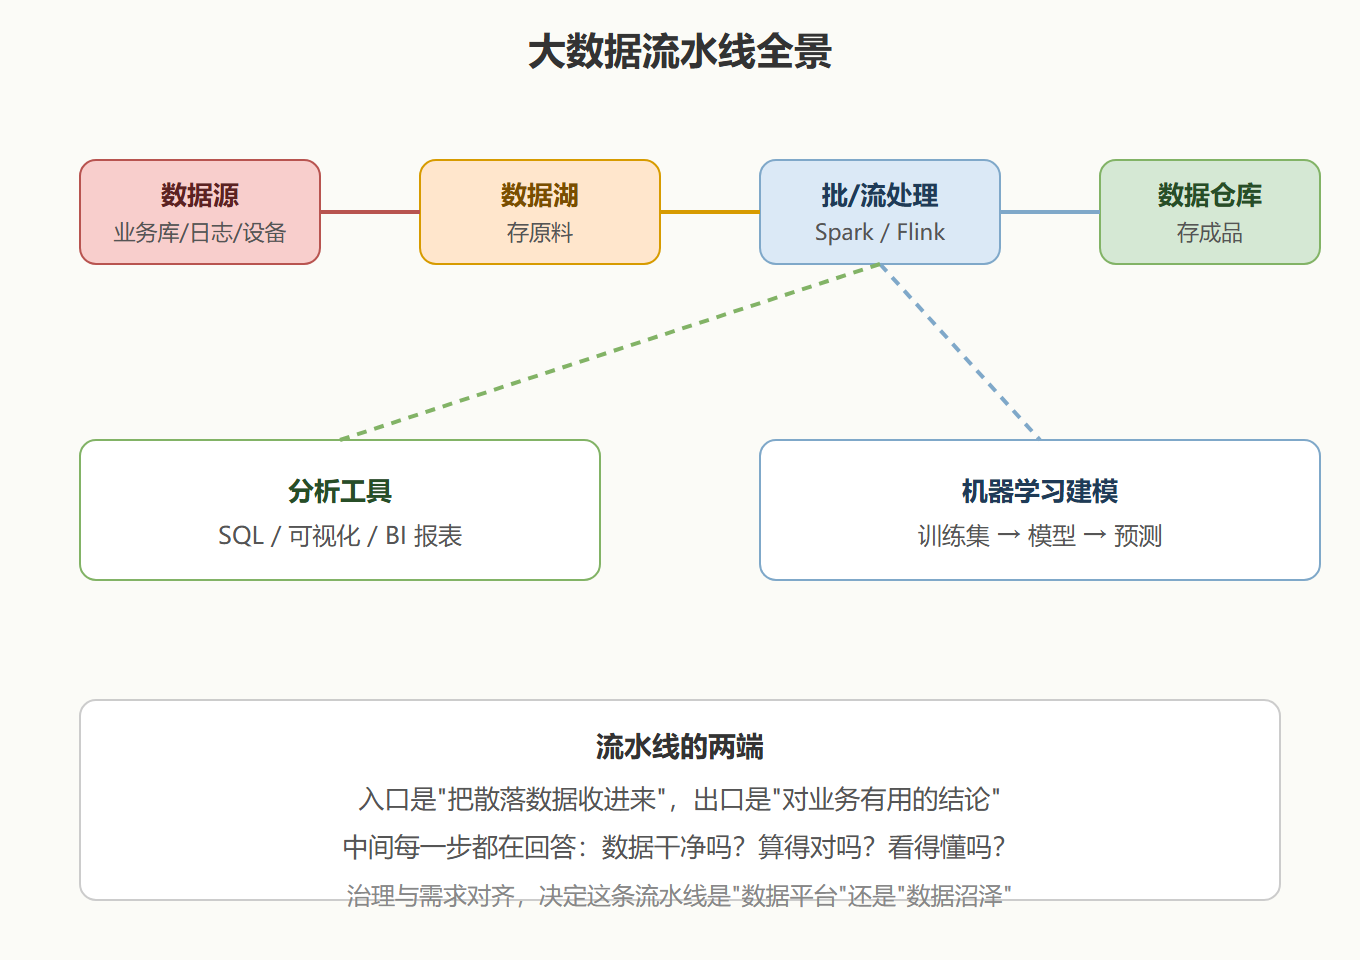
批处理与流处理的选择没有对错,只有场景:日报、月度经营分析用批处理足够;实时风控、实时大屏必须用流处理。很多系统是"混合架构"——流处理算实时指标,批处理算历史全量,各管一段。
三、工程实践要点
3.1 流水线各环节对比
| 环节 | 干什么 | 典型产品 | 常见误区 |
|---|---|---|---|
| 数据湖 | 集中存放原始数据 | S3/OSS + 元数据服务 | 不治理 → 变数据沼泽 |
| 数据仓库 | 存放建模后的结构化数据 | BigQuery、Redshift | 当业务库用 → 写入性能差 |
| 批处理 | 全量数据统一计算 | Spark、MapReduce | 实时性要求高的场景硬用 |
| 流处理 | 数据实时逐条处理 | Flink、Kafka Streams | 数据量小也上流 → 复杂度浪费 |
| 可视化 | 把结果画成图 | Tableau、Power BI | 只做图不建指标口径 |
⚠️ 常见坑:数据湖当成"垃圾桶",什么东西都往里扔却不登记元数据。三个月后没人知道湖里有什么、哪份数据可信,湖就废了。数据湖的成败在治理,不在容量。
💡 关键直觉:大数据项目 70% 的问题出在"数据质量和需求理解",只有 30% 是技术问题。先想清楚"要回答什么问题",再决定用什么工具,顺序不能反。
3.2 上云 vs 自建大数据平台
自己搭一套 Hadoop 集群,从采购、部署、调优到运维,动辄需要专职团队;用云上托管的大数据服务,集群开箱即用、按量付费、自动扩容。对多数企业,自建的价值只在"数据完全不出内网"这类硬约束下才成立。上云不是偷懒,是把稀缺的工程师时间从"搭平台"挪到"用平台解决业务问题"上——后者才是数据的真正价值。
四、常见问题(FAQ)
Q1:数据湖和数据仓库能不能二选一?
能,小规模场景可以只要一个。数据量小、来源单一、分析需求固定,直接上数据仓库;数据来源杂、形态多、还不知道将来要问什么问题,先建数据湖。成熟团队通常是"湖仓一体"或"湖 + 仓"两层结构。
Q2:数据清洗为什么这么花时间?
因为现实数据脏得超乎想象:字段缺失、格式不一、重复记录、单位混乱、历史口径变更。清洗(数据质量治理)常常占整个数据项目 60% 以上的工作量。这不是效率问题,而是数据的自然属性——机器生成的数据从来不"干净"。
Q3:Spark 和 Flink 怎么选?
一句话:Spark 擅长批处理和准实时,生态成熟;Flink 擅长真正的流处理,低延迟更强。数据更新频率不高、按小时或按天算,用 Spark 足够;要秒级响应(实时风控、实时监控),用 Flink。
Q4:BI 工具和直接写 SQL 有什么区别?
BI 工具的核心价值是"把查询变成自助":业务人员不用写 SQL,拖拽就能看报表。它适合常规指标的日常监控。复杂的、探索性的分析,仍然要靠分析师写 SQL 或代码。两者是互补关系,不是替代关系。
Q5:大数据分析一定要配机器学习吗?
不一定。大量有价值的数据分析是描述性的:转化率、留存率、收入构成,这些用统计和报表就能回答。机器学习是在"描述"之上的"预测与推荐",属于进阶。先打好报表与分析的基础,再谈机器学习,是更稳的路径。
五、数据团队的角色分工
看懂流水线之后,还要看懂"谁在跑这条流水线",否则买再好的服务也没人用。一个标准的数据团队通常有四种角色,各管一段。
数据工程师负责"搬数据":搭管道、做清洗、管仓库,保证数据按时按质到位。数据分析师负责"看数据":用 SQL 和 BI 工具回答业务问题,产出报表与洞察。数据科学家负责"用数据建模":训练预测模型、做推荐、做风控。数据产品经理负责"对齐需求":搞清楚业务到底要什么指标、什么口径,避免工程师做了没人要的东西。
这四种角色对应流水线的不同环节:工程师管湖仓与管道,分析师管出口的报表,科学家管建模,产品经理管需求。很多数据项目失败,不是工具不行,而是角色缺位——最常见的是"工程师和数据科学家有了,分析师和产品经理没有",于是平台建好了,却没人把它翻译成业务语言。云上托管服务降低了"搬数据"的门槛,但"把数据翻译成决策"这个环节,永远需要人来完成。
六、数据安全与合规的底线
数据分析把大量数据集中到一起,安全问题随之放大:一个存储桶权限配错,可能把所有用户数据暴露在公网。数据平台的底线要求包括:湖和仓的访问控制按角色最小授权;敏感字段脱敏后再进分析环境;数据访问留审计日志;遵守数据出境与隐私法规(如不得把境内个人数据随意转移到境外)。这些不是"以后再说"的事,而是数据平台上线前就必须定的规矩。第 4 章会系统讲数据加密与合规,这里先记住:数据越集中,越要先把闸门管好。
七、从分析到决策的闭环
最后补一个常被忽视的环节:数据分析的价值不在报表,而在"决策闭环"。一套成熟的数据体系,不是"出报表"就结束,而是"指标异常 → 定位原因 → 调整策略 → 再看指标",形成一个可以反复运转的循环。
为此,指标口径的统一是第一要务。同一个"用户数",业务部、市场部、运营部可能各有一套算法,口径不一致,任何对比都会失真。好的数据平台会建立统一的指标字典,谁取数都以它为准。其次是埋点与采集的规范——源头数据缺字段,后面所有分析都只能将就。这些工作听着琐碎,却是数据平台从"能用"走向"好用"的分水岭。工具可以买,口径与规范只能自己定。
核心回顾
- 数据湖:存原料、先存后想,成败在治理。
- 数据仓库:存成品、按主题建模,专为分析查询设计。
- 批处理 vs 流处理:全量离线算 vs 逐条实时算,按延迟需求选择。
- 流水线两端:入口收数据、出口出结论,中间每一步都在回答"干净吗、对吗、看得懂吗"。
- 治理为先:数据质量与需求对齐占项目成败的大头,技术反而是小头。
- 上云收益:托管服务把工程师从"搭平台"解放到"用平台解决业务问题"。
- 湖仓协同:湖存原料、仓存成品,成熟团队常是两层结构。
数据有了,怎么让机器自己从数据里"学"出规律?下一节讲人工智能与机器学习服务,看看云厂商把训练与推理的重活怎么托管。