3.5 灾难恢复与业务连续性
3.5 灾难恢复与业务连续性
本节摘要:灾难恢复(DR)回答"天灾人祸来了,业务怎么活",业务连续性(BC)回答"平时怎么保证不中断"。本节先讲 RPO 与 RTO 两个量化指标——最多丢多少数据、最快多久恢复——再讲备份、故障转移、容灾架构(多可用区、跨区域)三类手段,最后给出从风险识别到恢复演练的完整计划,帮你把"最坏情况"从恐怖片变成可控剧本。
上手前先明确
阅读完本节,你应当能够:
- 解释 RPO(恢复点目标)与 RTO(恢复时间目标)的含义与区别。
- 对比备份、故障转移、容灾架构三类手段的恢复能力与成本。
- 描述多可用区部署与跨区域部署在容灾能力上的差异。
- 为关键业务制定一份包含风险评估、恢复策略、演练计划的容灾方案。
一、问题与直觉
想象凌晨两点,机房所在区域突发断电或自然灾害,你的系统全挂了。用户访问不了,订单下不了,数据不知道丢没丢。这时候你最关心的两个问题只有一个答案能回答:什么时候能恢复?数据丢了多少?
这两个问题分别对应 RTO 和 RPO——容灾领域两个最重要的量化指标。很多团队平时从不想这两个数字,直到灾难发生才发现"原来我们没想过"。容灾的本质,就是把"最坏情况"从突发事件变成预先设计好的剧本:先定目标(恢复多快、丢多少可接受),再配手段(备份、冗余、容灾架构),最后定期演练验证剧本真的能演。
二、核心原理
2.1 两个数字:RPO 与 RTO
RPO(Recovery Point Objective,恢复点目标):灾难发生时,可接受的最大数据丢失量,通常用时间表示。RPO 为 1 小时,意味着最多丢 1 小时的数据;RPO 为 0,意味着数据零丢失(通常需要同步复制)。RTO(Recovery Time Objective,恢复时间目标):灾难发生后,系统恢复到可用状态所需的最长时间。RTO 为 1 小时,意味着 1 小时内必须恢复服务。
理解这两个指标的关键是"取舍":RPO 越小,要求数据复制越频繁,成本越高;RTO 越小,要求冗余与自动化越强,成本越高。容灾设计就是"在可接受的范围里定目标,在可承担的预算里选手段"。先定数字,再配方案——没有数字的容灾方案,只是一堆没有验收标准的动作。
2.2 三类手段:从低配到高配
备份(Backup):定期把数据复制到独立存储,灾难时用备份恢复。成本最低,但 RPO 受备份频率限制(上次备份到灾难之间的数据会丢),RTO 受恢复操作时间限制(要人工或脚本恢复)。适合数据重要性中等、恢复时间要求不苛刻的业务。
故障转移(Failover):为服务准备备用实例,主实例故障时自动切换到备用。通过健康检查与自动切换,RTO 可以做到分钟级。适合对可用性要求较高的核心服务。
容灾架构(DR Architecture):在多个可用区(AZ)或跨区域(Region)冗余部署整套环境。多可用区部署在同一个地域内的多个物理隔离机房之间冗余,应对"单机房故障";跨区域部署在多个地域之间冗余,应对"整个地域故障"。这是 RPO/RTO 最极致的形态,也是成本最高的形态。
2.3 从备份到容灾的阶梯
容灾能力是一个阶梯,不是非此即彼:本地备份 → 异地备份 → 多可用区冗余 → 跨区域容灾 → 双活。每上一级,数据安全与可用性提升一档,成本也升一档。设计时按业务重要性分配层级——核心支付系统上跨区域容灾,非核心的内部系统本地备份就够了。用分级而不是一刀切,才是理性的容灾设计。
三、工程实践要点
3.1 容灾方案对比
| 方案 | RPO | RTO | 成本 | 适用业务 |
|---|---|---|---|---|
| 本地备份 | 数小时~天 | 数小时 | 低 | 数据可容忍较大丢失 |
| 异地备份 | 数小时 | 数小时 | 中 | 防单点地域性灾难 |
| 多可用区部署 | 分钟级 | 分钟级 | 中高 | 核心在线业务 |
| 跨区域容灾 | 分钟~秒级 | 分钟级 | 高 | 金融、支付等关键系统 |
3.2 业务连续性计划的四步
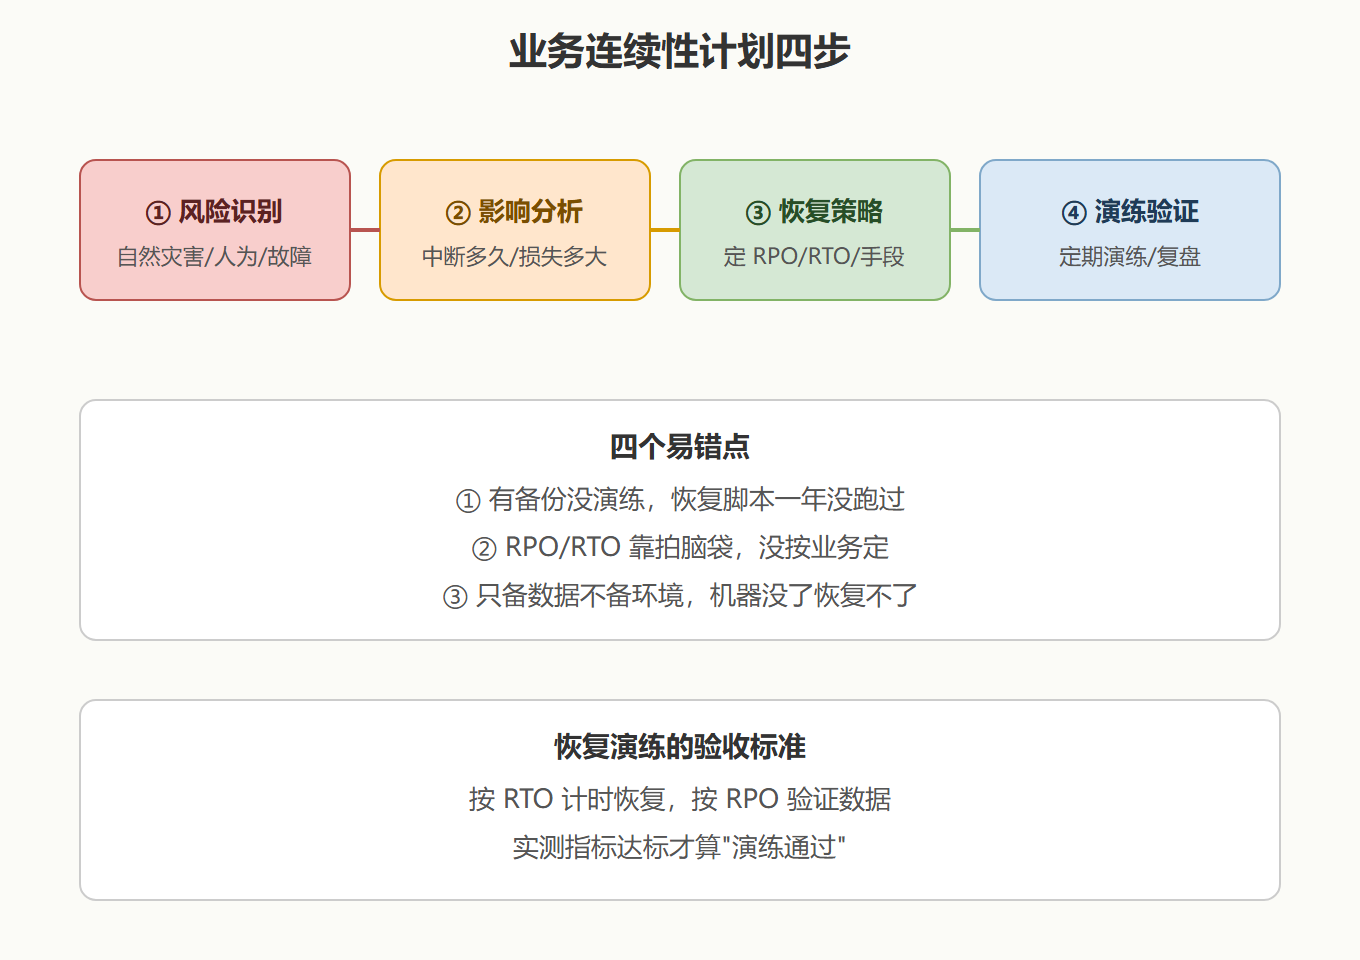
⚠️ 常见坑:只备份数据、不备份环境。机器丢了,数据在也起不来——要能"重建整套环境",IaC(第 3.1 节)在这里派上大用场:环境代码化,灾难时一键重建。
💡 关键直觉:容灾方案的价值不在"买了多贵的服务",而在"演练时能不能按时恢复"。没演练过的容灾方案,本质上是一份纸面承诺。
3.3 恢复演练:让方案变成能力
容灾方案不演练等于没有。演练的常见形式:备份恢复演练(定期用备份恢复一套环境,验证数据可用)、故障注入演练(人为制造故障,验证自动切换是否生效)、全流程演练(完整模拟灾难到恢复)。演练的目的不是"证明方案对",而是"暴露方案的问题"——发现备份坏了、脚本过时了、权限不够了,及时修补。每次演练都该当作一次真实的灾难来对待。
四、常见问题(FAQ)
Q1:RPO 和 RTO 哪个更重要?
没有绝对答案,取决于业务。支付类业务两者都敏感(钱不能丢、服务不能停);内部报表系统 RTO 可以长、RPO 可以大。关键是"先定数字再选方案",别拿"尽量快、尽量稳"这种模糊目标来设计。
Q2:多可用区部署就是容灾吗?
多可用区部署能应对"单机房故障",属于高可用(HA)范畴;跨区域容灾才应对"整个地域灾难"。两者能力不同、成本不同。日常高可用用多可用区,重大灾难兜底靠跨区域。理解这个差异,别把"双机房"说成"跨区域容灾"。
Q3:数据备份频率设多久合适?
由 RPO 倒推:RPO 1 小时,备份频率至少要小于 1 小时;同时要考虑"恢复点"的可操作性——事务日志、增量备份、持续复制都是缩短 RPO 的手段。别拍脑袋定"每天备份一次",先看 RPO 要求。
Q4:容灾要不要全业务都上?
不要。容灾按业务分级:核心业务(支付、登录)上最高级别容灾,重要业务(订单、库存)上中等级别,非核心业务(内部工具)备份即可。全业务统一上高级容灾,预算会先撑不住。
Q5:演练成本高,能省吗?
演练成本确实不低,但"灾难真来了才发现方案不能用"的成本更高。折中做法:高频低成本演练(备份恢复抽查)常态化,低频全流程演练(完整容灾演练)定期做。演练频率和业务重要性成正比——越核心的系统,演练越不能省。
五、容灾设计的三层思维
把容灾设计拆成三层思维,遇到具体问题就不慌。数据层:数据在哪儿、怎么复制、怎么恢复——这是容灾的地基,数据没了其他都是空谈。应用层:应用能否在恢复后的环境快速拉起,依赖配置与部署的可重复性,这正是 IaC 与 CI/CD 的用武之地。流量层:用户流量怎么切到恢复后的环境,涉及 DNS、负载均衡与流量调度,让"切换"成为可控动作。
三层各管一段,缺一层都不完整。很多容灾方案纸面上漂亮,实操翻车,往往就栽在"只设计了数据层,忘了应用层和流量层"——数据恢复了,应用起不来,流量切不过去,一样是灾难。设计容灾时把三层都过一遍,并用演练验证每一层,方案才算闭环。
六、容灾测试的三种玩法
把容灾演练再拆细一点,三种常见玩法对应不同的目的与成本,团队可以按需组合。
第一种是"文档演练":不真动系统,把恢复步骤在纸上过一遍,核对步骤有没有遗漏、依赖有没有缺失。成本几乎为零,适合新方案上线前的第一轮验证,能抓出"恢复流程里根本没写数据库密码从哪拿"这类低级但致命的问题。
第二种是"半模拟演练":在测试环境或影子环境里执行恢复流程,验证数据备份可恢复、环境脚本可重建,但不碰生产流量。成本中等,适合定期做的常规演练,验证"数据和环境都是真的能恢复"。
第三种是"生产级演练":在真实生产环境执行故障切换或降级演练(配合灰度流量,把部分用户切到容灾环境),验证切换链路与性能。成本最高、风险最大,但验证效果最真实,适合核心系统的定期大考。像金融行业常用的"混沌工程",本质就是生产级演练的自动化。
三种玩法没有谁更高级,只有谁更匹配当前阶段:新方案先做文档演练,常规周期做半模拟演练,核心系统定档做生产级演练。把三种玩法排进年度日历,容灾能力才不是"一次性表演",而是真正长在系统里的肌肉记忆。
七、业务连续性与人的因素
容灾方案最后还要过"人的因素"这一关——这是最容易被忽略、也最容易翻车的一环。
第一是"名单要新":故障发生时,谁在值班、谁有权限操作恢复环境、紧急联系人电话能不能打通。半年没更新的联系人名单,演练时才发现关键人物已经离职,恢复进度瞬间卡死。人员与权限清单要随组织变动同步更新。
第二是"决定要快":灾情上报后,由谁拍板"启动容灾"?如果决策链太长,等高层批复时业务已经凉透。要在预案里写清楚分级授权——什么级别的故障,哪个岗位有权直接启动恢复流程,不必层层请示。
第三是"通信要通":灾难时内网、办公网可能一起瘫痪,团队靠什么通信?微信群断了怎么办?预案里要有备用的对外沟通渠道,以及向客户、监管部门通报的标准话术。
容灾的本质,是"用预案对抗混乱"。技术方案解决"系统怎么恢复",人的预案解决"团队怎么指挥"。两者都准备到位,最坏情况才会从"灾难片"变成"有惊无险的演习"。
核心回顾
- RPO:最多丢多少数据,数据复制频率决定它。
- RTO:最快多久恢复,冗余与自动化程度决定它。
- 先定数字再选方案:RPO/RTO 由业务决定,成本随指标收紧而上升。
- 三类手段:备份(低配)、故障转移(中配)、容灾架构(高配)。
- 分级容灾:按业务重要性分级投入,别一刀切全上高级方案。
- 环境也要备:只备数据不备环境,机器没了恢复不了;IaC 在这里关键。
- 演练是验收:按 RTO 计时、按 RPO 验数据,达标才算演练通过。
- 三层思维:数据层、应用层、流量层各管一段,缺一层方案不闭环。
第 3 章的运营体系讲完了:资源、监控、自动化、成本、容灾。但运营的一切都建立在"系统没被入侵"的前提下——下一章进第 4 章,讲安全与合规,把防护的底裤穿上。