5.3 边缘计算
5.3 边缘计算
本节摘要:边缘计算(Edge Computing)把计算与存储搬到离数据源更近的地方,解决云计算"什么都往中心送"的三大痛点:延迟高、带宽贵、敏感数据不适合远传。本节讲清边缘的"快"与云端的"全"如何分工,拆解物联网、自动驾驶、工业控制等典型场景,并给出一张"该在边缘算什么、该在云端算什么"的分工图。
本节地图
阅读完本节,你应当能够:
- 说出边缘计算的三大价值:低延迟、省带宽、数据本地化。
- 解释"边缘管快、云端管全"的分工逻辑。
- 分析物联网场景中边缘与云如何配合。
- 判断一个业务是否需要引入边缘计算。
一、问题与直觉
想想自动驾驶:车以 120 公里时速行驶,每秒都在产生新的传感器数据,刹车决策必须在毫秒级完成。如果所有数据都传回千里之外的云端、等云端算完再传回来——光是网络往返就是几百毫秒,车早就撞了。有些决策必须发生在数据产生的地方,等不起"传回云端再回来"。
这就是边缘计算的起点。它不是一个全新的计算范式,而是对云计算的"空间修正":把一部分计算从中心搬到离数据源最近的地方——工厂车间里的边缘服务器、基站旁的边缘节点、甚至车上的计算芯片。边缘负责"快",云端负责"全",两者分工而不是替代。
还有一个现实的驱动因素:带宽与成本。一台工业摄像头每秒产生几十 MB 数据,如果全量传云端,带宽账单会吓死人。边缘先做本地过滤与预处理——只把"有异常的帧"或"聚合后的指标"传回云端,带宽立刻省下一大截。
二、核心原理
2.1 边缘计算的核心价值
低延迟:计算在数据附近完成,网络往返从"跨地域毫秒级"降到"本地微秒级",这是自动驾驶、工业控制的硬需求。高带宽利用率:本地先过滤、聚合,只传必要数据上云,大幅降低传输量与带宽成本。增强安全:敏感数据在本地处理,不上传,降低泄露面;即使断网,本地也能继续工作(离线操作)。这四个价值,本质上都是"把数据往中心传"这个默认动作的成本与风险。
2.2 边缘、云端与设备:三层分工
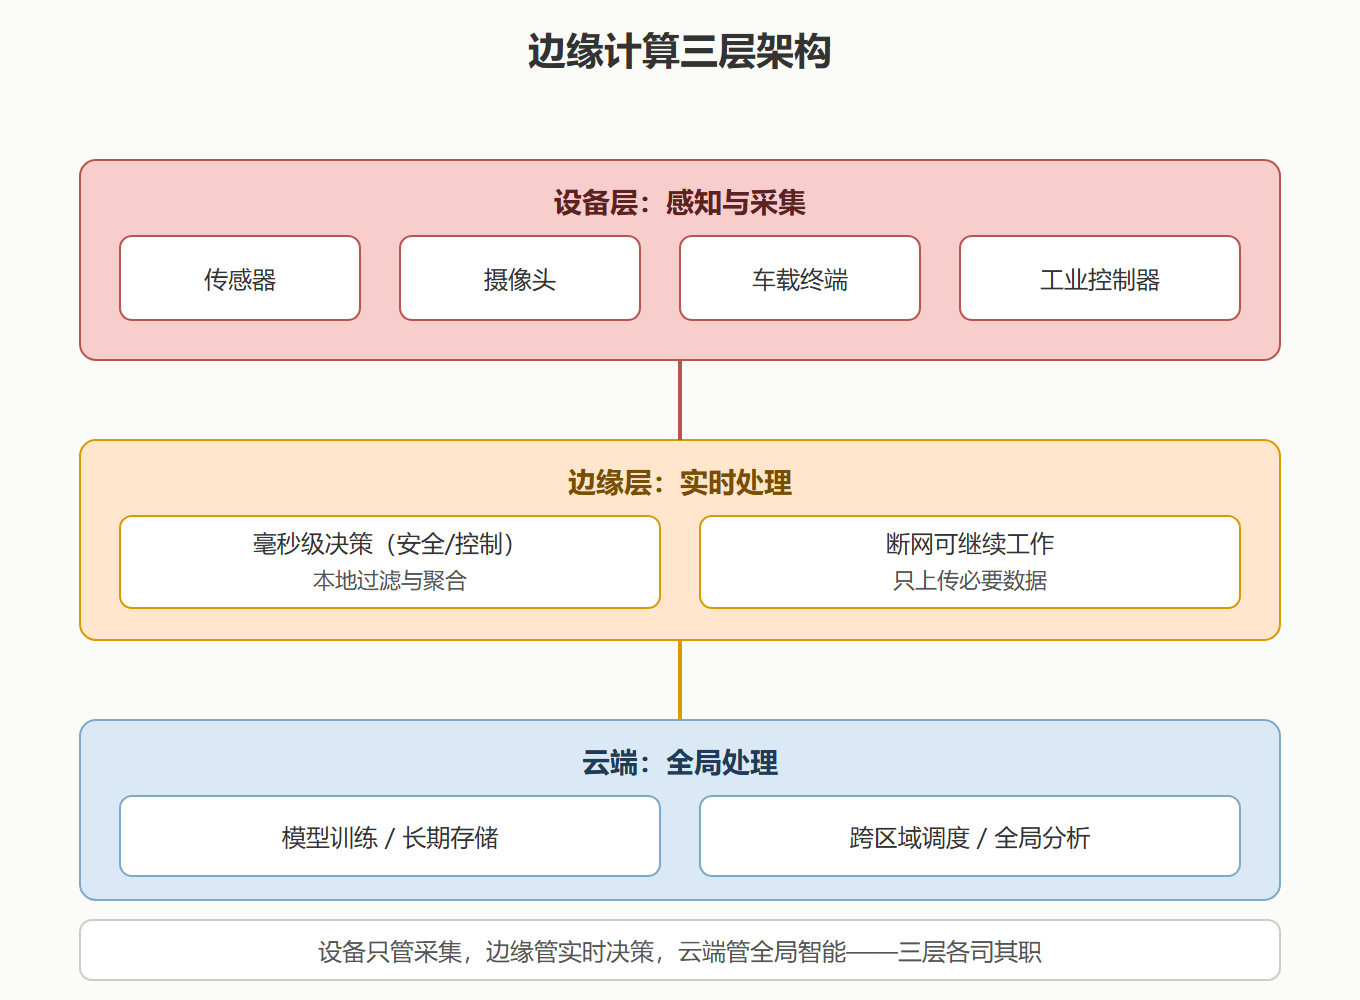
一套完整的边缘计算架构通常是三层:设备层(传感器、摄像头、终端——只负责采集与简单响应)、边缘层(边缘节点——做实时处理、过滤、初步分析,响应毫秒级决策)、云端(中心云——做全局训练、长期存储、跨区域调度)。
2.3 边缘与云端的分工原则
分工的核心原则就一句话:需要即时响应的,放边缘;需要全局视角的,放云端。 刹车、停机、熔断这类"本地就能判断"的决策放边缘;模型训练、全局报表、跨区域调度这类"需要全局数据"的放云端。边缘是"局部智能",云端是"全局智能",两者通过数据通道联动——边缘把聚合结果传云端,云端把更新后的模型下发给边缘。这个"边云协同"的模式,是现代物联网与工业互联网的底层逻辑。
用一个数据流的例子把"边云协同"具体化——比如智能工厂的预测性维护:
这条链路清楚地展示了分工:设备传感器不停产生数据,边缘网关先做"本地判断"——异常就立即停机(毫秒级,等不起云端);正常数据聚合成指标再上传云端(省带宽);云端用历史数据训练更优的模型,再下发给边缘(边云协同的闭环)。"边缘管实时、云端管进化"这个逻辑,在这条链路上看得一目了然。
三、工程实践要点
3.1 边缘 vs 云端处理对比
| 维度 | 边缘处理 | 云端处理 |
|---|---|---|
| 延迟 | 微秒~毫秒级 | 毫秒~秒级(含网络) |
| 带宽消耗 | 低(本地过滤) | 高(全量上传) |
| 数据范围 | 单点/局部 | 全局 |
| 计算能力 | 有限 | 强大(GPU 集群) |
| 典型决策 | 即时控制、异常停机 | 训练、分析、调度 |
⚠️ 常见坑:把边缘当"小型云计算"——在边缘塞了一堆重型框架,结果边缘设备性能吃紧、维护成本暴涨。边缘要的是"轻、快、专注",只跑必要的实时逻辑,重活留给云端。
💡 关键直觉:判断"该不该上边缘",先问"这笔决策等得起 500 毫秒吗"。等得起,走云端;等不起,才值得为边缘投入。延迟要求是边缘计算的唯一硬标准。
3.2 典型场景分析
物联网:智能工厂、智能家居,设备数据先在边缘网关聚合处理,再上传云端做长期分析(呼应第 2.8 节)。自动驾驶:感知、决策必须在车上完成,云端负责高精地图更新与远程监控。AR/VR:渲染与手势识别需要低延迟,边缘节点就近提供算力。工业自动化:设备控制要求毫秒级响应与离线可用,边缘是刚需。
3.3 什么时候不必上边缘
不是所有低延迟场景都值得上边缘。判断标准:数据量真的大到传不动吗?决策真的快到来不及传吗?敏感度真的高到不能出本地吗? 三个问题都是"否",老老实实走云端——边缘节点也是要部署、要运维、要花钱的。技术地图上的每一个选项,只有"业务需要"才值得动用。
四、常见问题(FAQ)
Q1:边缘计算和物联网是一回事吗?
不是。物联网是"把设备连上网"的体系,边缘计算是"在网络边缘做计算"的架构。物联网是边缘计算最大的应用场景之一,但边缘也用在自动驾驶、AR/VR、视频监控等非物联网场景。两者有交集,但不是包含关系。
Q2:边缘节点是什么?是服务器吗?
边缘节点可以是多种形态:工厂机房的边缘服务器、运营商基站的计算节点、商场里的边缘盒子,甚至汽车里的计算芯片。它们的共同点是"靠近数据源、提供本地计算",但硬件形态差异很大。部署形态取决于场景的规模与性能要求。
Q3:边缘计算会取代云计算吗?
不会。边缘算"局部快",云端算"全局全"——训练模型、长期存储、跨区域调度都离不开云端。边缘是云计算的补充与延伸,不是替代品。两者的关系更像"前台"与"后台":前台快速响应,后台深度计算,缺一不可。
Q4:边缘计算的安全性怎么样?
边缘更安全的一面是敏感数据不上传,泄露面减小;更脆弱的一面是边缘设备数量多、位置分散、防护参差,容易成为攻击入口。所以边缘设备要管好身份认证、固件更新与访问控制——它离业务近,离安全审计远,恰恰是需要更细致管理的一层。
Q5:小企业需要边缘计算吗?
通常不需要。小企业的数据量、延迟要求、敏感度往往云端就能满足。边缘计算是"规模与技术发展到一定程度"后的选择——设备数量足够多、数据处理量足够大、延迟要求足够硬,才值得投入。先好好用云,等这些条件出现再谈边缘。
五、边缘计算的技术栈
边缘计算不是单一技术,而是一套组合:边缘容器(把容器编排延伸到边缘,统一管理边缘与云端应用)、边缘 AI(把模型推理放到边缘,配合轻量化模型实现本地智能)、边缘网关(负责设备接入、协议转换、数据预处理)、5G/MEC(移动边缘计算,把算力下沉到网络边缘)。这套技术栈的共同方向,是让"边缘"像"云端"一样好管——统一编排、统一升级、统一监控。理解了这个方向,你就能理解边缘计算不是"另一套云",而是"云的延伸"。
六、边缘计算部署的工程挑战
纸上谈兵容易,真正把边缘计算部署起来,会撞上几堵真实的墙。提前知道,部署时就不至于措手不及。
第一堵墙是设备数量与位置分散。云端几十台机器集中在机房,边缘可能是分布在几十个厂区的上千台节点。升级、打补丁、故障排查,全部要远程进行——没有统一的设备管理与下发机制,运维会变成一场噩梦。这也是为什么"边缘容器 + 统一编排"会成为趋势:它让边缘节点像云端节点一样可管。
第二堵墙是网络不稳定。边缘节点与云端的链路可能时断时续,带宽也不保证。设计上必须假设"断网是常态":边缘要有本地缓存与降级逻辑,断网时继续工作、联网后补传数据。很多边缘方案翻车,就是没做好"离线优先"。
第三堵墙是安全边界模糊。云端安全集中在数据中心,边缘设备分散在物理可达的地方,设备可能被物理接触、被篡改、被伪造。边缘设备要上身份认证、固件签名、安全启动,防护等级要比云端设备更高——因为它物理上更"裸露"。
第四堵墙是调试复杂度上升。问题可能出在设备、边缘、云端任意一环,分布式排障的难度远高于集中式。可观测性(日志、追踪、指标)在边缘体系里不是加分项,而是必需品。
四堵墙都不是"能不能上边缘"的否定理由,而是"上之前必须想清楚"的规划清单。技术选型的成熟度,恰恰体现在你提前预见了多少这种工程成本。
重点提炼
- 三大价值:低延迟、省带宽、数据本地化,本质是修正"都往中心传"的成本。
- 三层架构:设备层采集、边缘层实时决策、云端全局智能,各司其职。
- 分工原则:即时响应放边缘,全局视角放云端,边云协同联动。
- 判断标准:等得起 500 毫秒就走云端,等不起才值得上边缘。
- 典型场景:物联网、自动驾驶、AR/VR、工业自动化。
- 非替代关系:边缘是云的补充延伸,不是替代。
- 技术栈:边缘容器、边缘 AI、边缘网关、5G/MEC,让边缘像云一样好管。
边缘解决了"离得近",但"选哪朵云"的问题还没答——下一节讲多云与混合云管理,看企业怎么在多朵云之间做选择、怎么把多朵云管住。