6.1 Layer 2 与分片:给流水线提速
6.1 Layer 2 与分片:给流水线提速
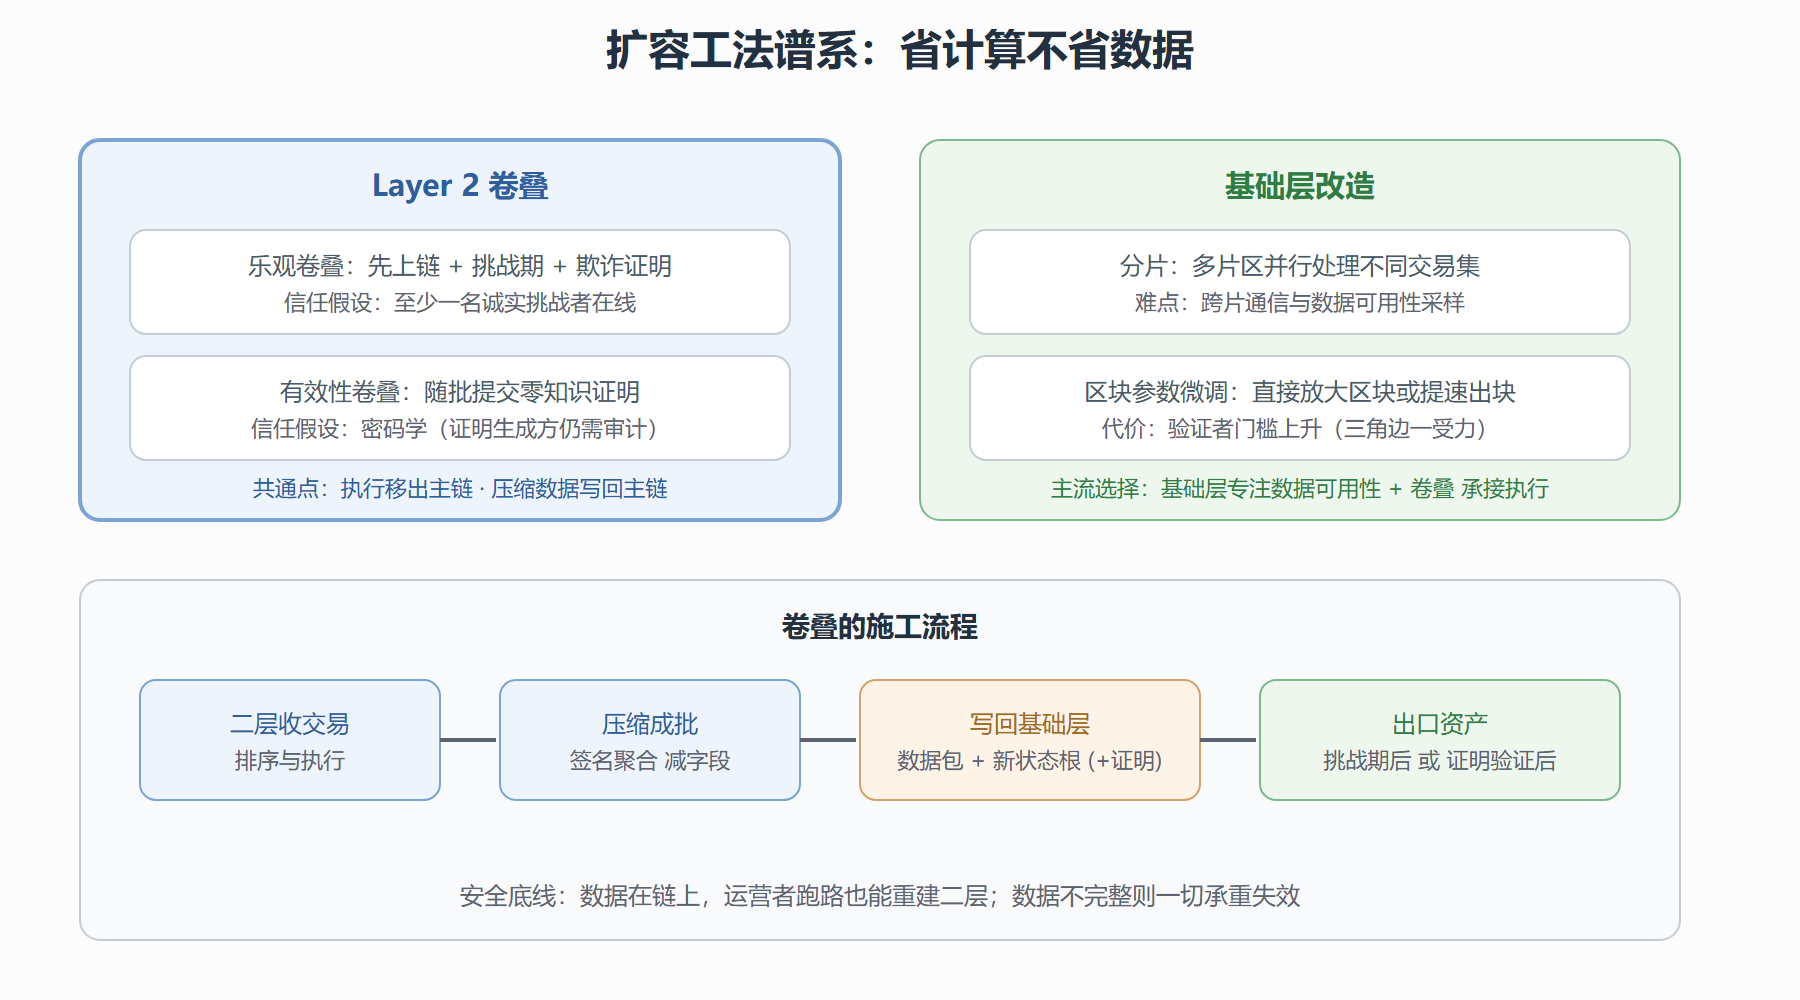
Layer 2(二层网络)是在基础链之外执行交易、把压缩后的结果或证明写回基础链的扩容工程,主流是卷叠(Rollup):乐观卷叠默认交易有效、设挑战期用欺诈证明纠错,有效性卷叠随批附带零知识证明主动自证。分片则把基础链本身切成并行处理的片区。两者共同遵守"不动承重墙"的施工纪律:共识层与数据可用性尽量留在基础层。
「Rollup」,把车间搬出主厂房
「Rollup」,卷叠——扩容工程的主力工法,名字取自"把一批交易卷起来上链"。施工逻辑针对第 4 章末节那个不可能三角的痛点:基础层慢,是因为每个节点都要重放每笔交易;那就让交易在一台或几台"二层车间"里先算完,把成千上万笔交易压缩成一捆数据与新状态根交回基础层。基础层节点不必重放交易——它们要么相信结果但保留一段挑战期(有人发现作弊可提交欺诈证明,作弊者的押金被罚没),要么要求随批附带一枚数学证明(零知识证明,验证毫秒级)。两种纠错哲学的差别,后面用代码演。
关键洞察藏在"数据也要上链"这个不起眼的细节里。卷叠省的是计算(不用重放),不敢省的是数据(原始交易的压缩包必须写进基础层)。原因:万一二层运营者作恶或跑路,任何人必须能拿链上数据独立重建二层状态——数据在,就能换一批运营者继续开工;数据丢了,二层就成了一座只能看不能进的仓库。这就是"数据可用性"问题的直观版:交易数据的可获取性是安全底线,计算的正确性反而可以用证明与挑战兜底。
图 6-1 扩容工法谱系:卷叠与分片的施工图
卷叠上机:批处理与两种纠错哲学
把卷叠的车间流程写成代码——批量执行、压缩上链、按两种哲学纠错:
import hashlib class RollupNode: def __init__(self): self.l2_ledger = {} self.batches = [] def execute(self, txs): """二层本地执行:顺序处理交易""" for tx in txs: f, t, amt = tx["from"], tx["to"], tx["amount"] assert self.l2_ledger.get(f, 0) >= amt + tx["fee"], "二层余额不足" self.l2_ledger[f] -= amt + tx["fee"] self.l2_ledger[t] = self.l2_ledger.get(t, 0) + amt return self.state_root() def state_root(self): blob = "".join(f"{a}:{b}" for a, b in sorted(self.l2_ledger.items())) return hashlib.sha256(blob.encode()).hexdigest()[:12] def submit_batch(self, txs, mode): data = self.compress(txs) # 数据必须完整上链 root = self.execute(txs) self.batches.append({"data": data, "root": root, "mode": mode}) return self.batches[-1] @staticmethod def compress(txs): """压缩示意:签名聚合与字段裁剪后每笔仅数十字节""" packed = [f"{t['from'][:4]}>{t['to'][:4]}:{t['amount']}+{t['fee']}" for t in txs] return ";".join(packed) node = RollupNode() node.l2_ledger = {"alice": 1000, "bob": 100, "carol": 50} batch = node.submit_batch([ {"from": "alice", "to": "bob", "amount": 30, "fee": 1}, {"from": "bob", "to": "carol", "amount": 5, "fee": 1}, {"from": "alice", "to": "carol", "amount": 20, "fee": 1}, ], mode="validity") print("上链批次:", batch["data"][:50], "...") print("新状态根:", batch["root"], "| 数据字节:", len(batch["data"]))
再看两种纠错哲学的分岔代码——同样的批次,主链侧如何验收:
def l1_accept(batch, watcher_online=True, proof_valid=None): """基础层对卷叠批次的验收分岔""" if batch["mode"] == "optimistic": # 乐观:先收下,开挑战期 if not watcher_online: return "无人挑战 -> 批次生效(风险:挑战者缺席则作弊得逞)" fraud = batch.get("fraud_proof") if fraud: return "欺诈证明成立 -> 回滚该批,罚没排序者押金" return "挑战期满无异议 -> 生效(提款需等满期)" else: # validity if proof_valid is None: return "缺少有效性证明 -> 拒收" return ("证明验证通过 -> 立即生效(提款分钟级)" if proof_valid else "证明无效 -> 拒收并罚没") ok = {"mode": "validity"} print(l1_accept(ok, proof_valid=True)) opt = {"mode": "optimistic"} print(l1_accept(opt, watcher_online=False))
两段输出对照出工程选型的核心权衡:乐观卷叠省掉了证明生成的算力,代价是挑战期的等待(资产退出慢)与"必须有人盯梢"的社会假设;有效性卷叠用密码学换掉了盯梢与等待,代价是证明生成的计算成本与电路复杂度。两者吞吐都受"基础层数据容量"的顶板约束——这正是"扩容不省数据"的又一佐证。
工程现实:状态增长与运营者集中
卷叠落地后的两张账单。状态账单:二层执行快了,但状态(余额表、合约存储)照单全收地增长,二层的状态租金与无状态化(用证明替代本地状态查询)仍在演化。运营者账单:排序交易的角色天然有中心化引力(要在线、要垫付、要抢先后),主流设计用"排序者押金 + 强制交易包含机制 + 多排序者轮换"给这个引力上笼头;激进派干脆做去中心化排序网络。评估任何卷叠项目,检查表固定六项:数据是否完整上链(否则是侧链不是卷叠)、挑战或证明机制是否真实可用、排序者作恶的代价、退出通道是否无需许可、合约是否可升级(升级权限即新攻击面)、历史故障与处理。
⚠️ 最容易被忽视的一条:桥与卷叠是两种东西。把资产从一层存入二层,走的若是第三方桥(见下一节),安全性按桥算;原生卷叠的存取走合约内置通道,安全性按卷叠算。用户在钱包里点"充值"时很少意识到自己在两种安全模型间切换。
💡 判词:卷叠省计算不省数据,提速靠搬不靠删;挑战期是乐观者的耐心税,证明费是谨慎者的保险费。
分片:把流水线本身并行化
分片是更彻底的改造:把全网节点分组,每组(片区)处理各自的交易子集,片区间用跨片消息协议结算——吞吐按片区数近似线性放大。难点集中在两处:跨片一致性(一笔交易同时动两个片区的状态,需要两阶段式的锁定与结算,分布式数据库的老板难题换了个马甲);数据可用性采样(节点如何在不下载全部片区数据的前提下,确信"所有数据都可得"——抽样 + 纠删码是主流答案:数据编码成冗余块,随机抽查若干块即可高置信度确认整体可得)。工程现实里,分片路线的落地比预期慢:跨片复杂度与抽样安全性都难啃,主流生态把"分片执行"后撤为"分片数据"——基础层先只做数据分片(扩数据容量,服务卷叠),执行分片留作长线。这与卷叠的兴起互为因果:与其改造厂房并行化,不如把执行外包给二层车间,厂房专注当数据仓库。
提速的工法谱系到此完整。下一节处理第二张工单:多台机器之间的价值与消息如何安全过河——跨链桥,历史上最贵的学费账单就记在这个科目上。