1.1 案发现场勘查:图数据与GNN的破案价值
1.1 案发现场勘查:图数据与 GNN 的破案价值
本节摘要:图数据是由节点集合与边集合构成的关系型数据,节点承载实体属性,边承载关系语义。本节是全册的立案起点:盘点社交网络、化学分子、交通路网、推荐系统四类典型"案发现场",说明为什么关键证据藏在关系而非个体里;随后梳理图神经网络从循环图模型、谱方法到空间方法的兴起脉络,并给出它相对传统方法的破案优势清单。
从一桩刷单案说起
深夜的事务所接到平台委托:某些账号疑似协同刷单。实习生把账号行为流水翻了个底朝天——发帖频率正常、内容原创、设备干净,单看谁都不像坏人。老侦探的处置很朴素:把账号之间的转发、评论、共同登录设备画成关系网,紧密互捧的小团体立刻浮现,团伙结构一目了然。这就是本册教程反复强调的核心事实:在关系型数据里,个体特征再丰富也可能掩盖真相,结构本身就是证据。本节作为立案第一步,先把"这类卷宗长什么样、为什么值得专门立案、谁来接手"讲清楚,后续各节再逐步展开建档与编码。
四类高频案发现场
图数据的身影远比想象中普遍。下面这张勘查图列出了四类最常见的现场,每一类都标注了节点与边在业务里的真实语义——读图时请留意:节点与边的语义完全由业务定义,同样的算法骨架可以跨现场复用。
图:图数据的四类典型案发现场
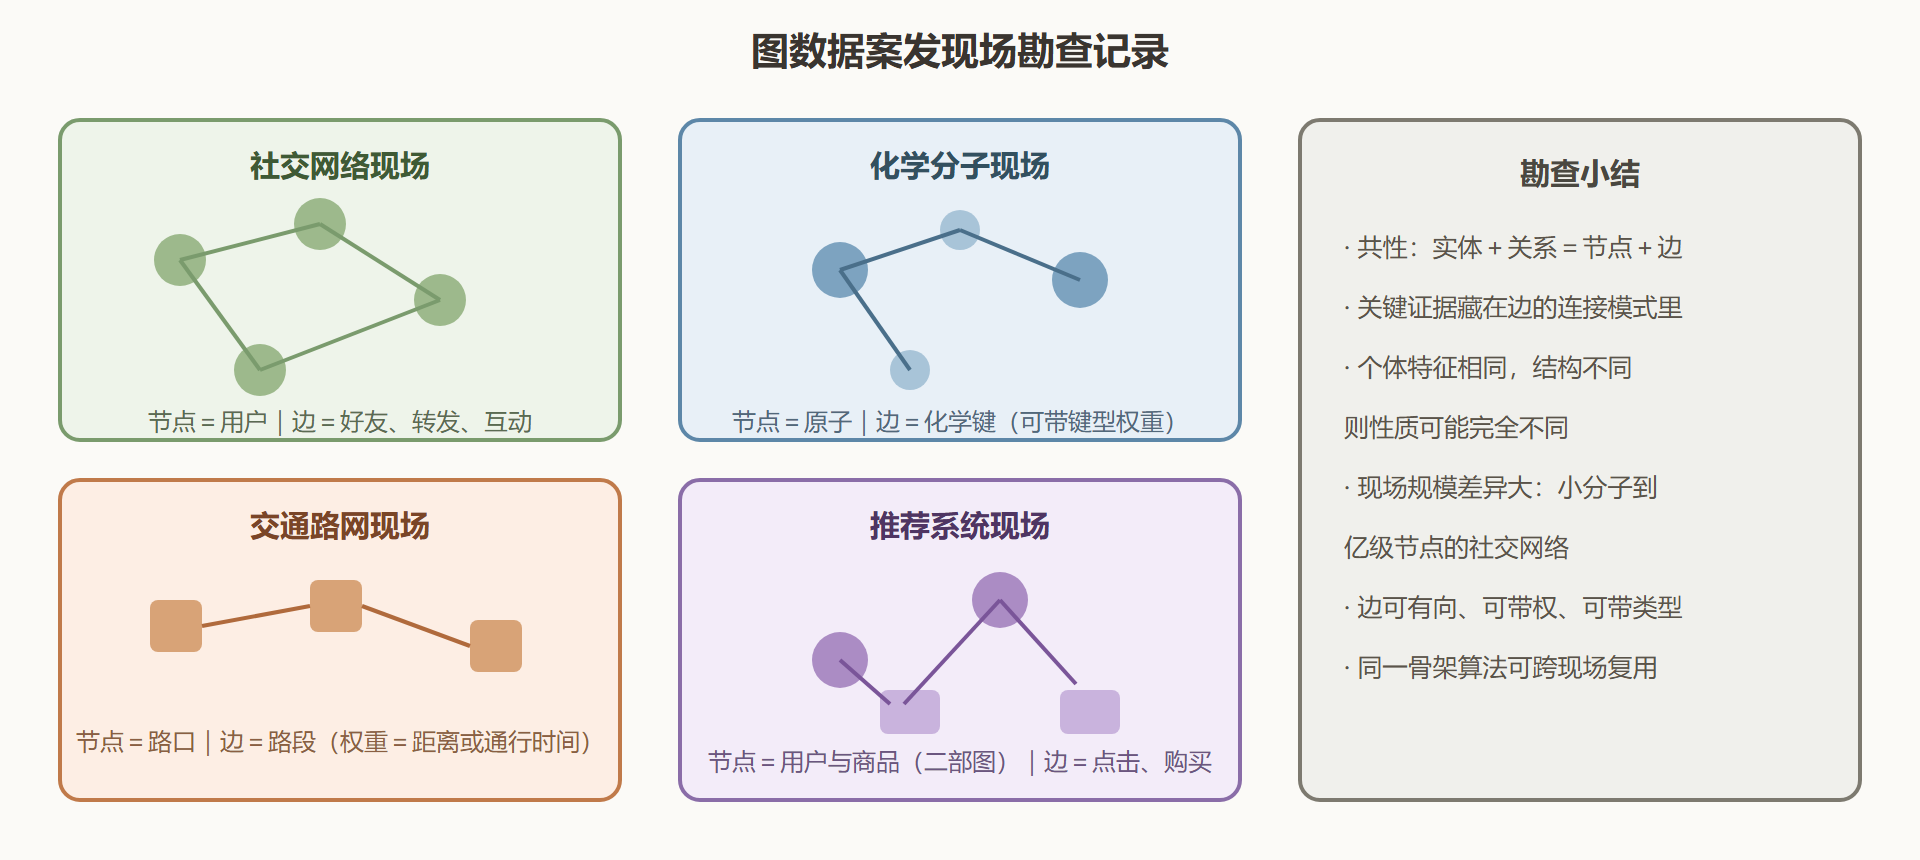
社交网络是图数据最直观的现场:用户是节点,好友关系、转发行为是边,社区发现、谣言溯源、异常账号检测都是典型案件。化学分子现场里原子是节点、化学键是边,分子毒性预测、药物性质筛选本质上是给整张小图定性。交通路网现场把路口当作节点、路段当作带权边(权重可以是距离或通行时间),预测任意路段的未来流量要同时参考相邻路段的当前状态——这正是图上空间相关性最纯粹的表达。推荐系统现场则常以二部图出现:一侧是用户、一侧是商品,点击与购买记录连成边,"你还可能喜欢什么"等价于"哪些尚未存在的边最可能出现",这个视角会在第四章的链接预测里正式展开。
邻接关系侦探社的接案历史
图神经网络不是横空出世的新装备,它的办案资格是逐渐挣来的。早期探索可以追溯到本世纪初提出的图神经网络雏形:研究者把节点状态建模为递归方程,通过迭代收敛求得不动点,用于处理外链网页排名之类的任务,这是"循环图模型"阶段。真正的转折发生在谱图理论入场之后——研究者把图信号处理里的谱滤波想法搬到神经网络上,用拉普拉斯矩阵的特征分解定义图上的卷积,谱方法路线由此确立。随后空间方法路线兴起:直接在每个节点的邻域上定义聚合操作,绕开了昂贵的特征分解。当简化后的图卷积网络(GCN)以清晰的"邻域均值聚合"形式发布,并在多个基准上取得强表现后,图神经网络从少数实验室的玩具变成工业界可用的办案工具,GraphSAGE、GAT、GIN 等手段在短短数年内相继登场,覆盖了从归纳式学习到注意力加权再到表达能力分析的各种办案需求。
办案直觉:谱方法与空间方法看似两条路,最终汇合于同一个事实——在图上做卷积,等价于对邻域信息做加权聚合;区别只在于"权重从哪来"。
GNN 的破案优势清单
把图神经网络与传统做法对照,它的价值可以拆成几条可检验的优势。第一,结构感知:模型输入里显式包含邻接关系,邻域信息经由消息传递进入节点表示,这是任何把节点当独立样本的方法做不到的。第二,参数共享与规模无关:同一套聚合参数在所有节点上复用,模型可训练于小图、推断于大图,参数量不随节点数增长。第三,编号无关性:合理的图卷积对节点重编号不敏感——同构的两张图经置换后应得到相同的输出分布,这一点在 1.2 节会作为传统方法的"罪名"再详述。第四,归纳能力:以 GraphSAGE 为代表的手段不记忆具体节点,只学习聚合函数,因此能对训练时从未见过的新节点直接推断,适合持续有新用户、新商品入场的业务现场。第五,多粒度输出:同一副骨架稍加改造即可输出节点级、边级、图级表示,分别服务定性个体、预测关系、评估整案三类结案需求。
上手勘查:用 NetworkX 开第一份卷宗
光说不练不是侦探作风。下面用 NetworkX 把开头的刷单案建成图对象,并做初步勘查——统计度数分布、找出互动最密的嫌疑人。度数(与节点相连的边数)是图结构里最基础的结构证据,社交现场里它近似"互动活跃度"。
import networkx as nx # 按委托人提供的互动记录建图:账号之间的转发与共同设备 edges = [ ("账号A", "账号B"), ("账号A", "账号C"), ("账号B", "账号C"), ("账号C", "账号D"), ("账号D", "账号E"), ("账号E", "账号F"), ("账号F", "账号D"), ("账号G", "账号H"), ("账号H", "账号I"), ] G = nx.Graph() G.add_edges_from(edges) # 无向图:转发关系视为双向可见 print("节点数:", G.number_of_nodes()) # 9 print("边数:", G.number_of_edges()) # 9 print("度数:", dict(G.degree())) # 度数: {'账号A': 2, '账号B': 2, '账号C': 3, '账号D': 3, # '账号E': 2, '账号F': 2, '账号G': 2, '账号H': 2, '账号I': 1} # 找出"抱团"结构:连通分量=互相可达的账号群体 for i, comp in enumerate(nx.connected_components(G)): print(f"团伙{i+1}:", sorted(comp)) # 团伙1: A~F 六人互连通;团伙2: G,H,I 自成一体 —— 两拨刷单团伙被分开
连通分量把账号切成了互不相连的群体,这就是最朴素的结构证据。再进一步,把"团伙内部连接密度"量化为聚类系数,可以区分真朋友圈与互捧团伙。
# 逐账号计算聚类系数:邻居之间也互认识的比重 for v in ["账号A", "账号C", "账号I"]: print(v, "聚类系数 =", round(nx.clustering(G, v), 3)) # 全图平均:互捧团伙往往内部密集、外部稀疏 print("全图平均聚类系数:", round(nx.average_clustering(G), 3)) # 勘查结论:把度数与聚类系数并列成表, # 高度数+低聚类=枢纽账号;高度数+高聚类=团伙核心; # 低度数+高聚类=边缘跟随者——三类角色处置策略不同。
这份勘查展示了立案阶段的基本功:建图、数边、看度数、找团伙。它们尚未涉及任何神经网络,却已经能回答"结构里有没有证据"。本册后续要做的,就是把这些手工勘查动作变成可学习、可泛化的模型操作。
本节勘查要点
- 图数据定义:节点集合加边集合构成的关系结构,节点带属性、边可带权重与方向,业务语义由现场决定。
- 证据在关系里:个体特征正常的账号可能构成异常团伙,结构模式是独立于个体特征的一类证据。
- 四大现场:社交网络、化学分子、交通路网、推荐系统是最常见的图数据来源,节点与边语义各异而算法骨架通用。
- 发展脉络:循环图模型到谱方法再到空间方法,卷积在图上的定义逐渐从特征分解走向邻域聚合。
- 核心优势:结构感知、参数共享、编号无关、归纳推断、多粒度输出,五条优势各有对应模型与场景。
下一节请传统深度学习的三员主力上审讯台——看看它们在这类卷宗上究竟败在哪个机制环节。