1.2 老办法为何失灵:传统深度学习的图上困境
1.2 老办法为何失灵:传统深度学习的图上困境
本节摘要:卷积网络依赖规则网格与平移不变性,循环网络依赖线性顺序,全连接网络把节点当独立样本——这三大机制假设在图数据上全部落空。本节承接上一节的案发现场勘查,逐一审讯传统深度学习的主力模型,用可运行的 NumPy 实验给出"失灵证据":邻域大小不定、节点排序不唯一、参数量随图规模爆炸,为第二章引入消息传递范式提供充分动机。
审讯台上的三员主力
别以为把邻接矩阵拉平、接上全连接层,就算"用深度学习处理了图数据"——这是立案阶段最常见的冤案源头。上一节我们确认了证据藏在关系里,本节要回答的是立案逻辑的下半段:为什么现成的老办法接不了这类卷宗。原因不在工程细节,而在数学结构:图既没有规则网格供卷积核滑动,也没有天然顺序供循环网络展开,更没有"节点彼此独立"的奢望。下面依次提审三员主力,每位的"罪名"都配一段可以直接复现的实验证据。
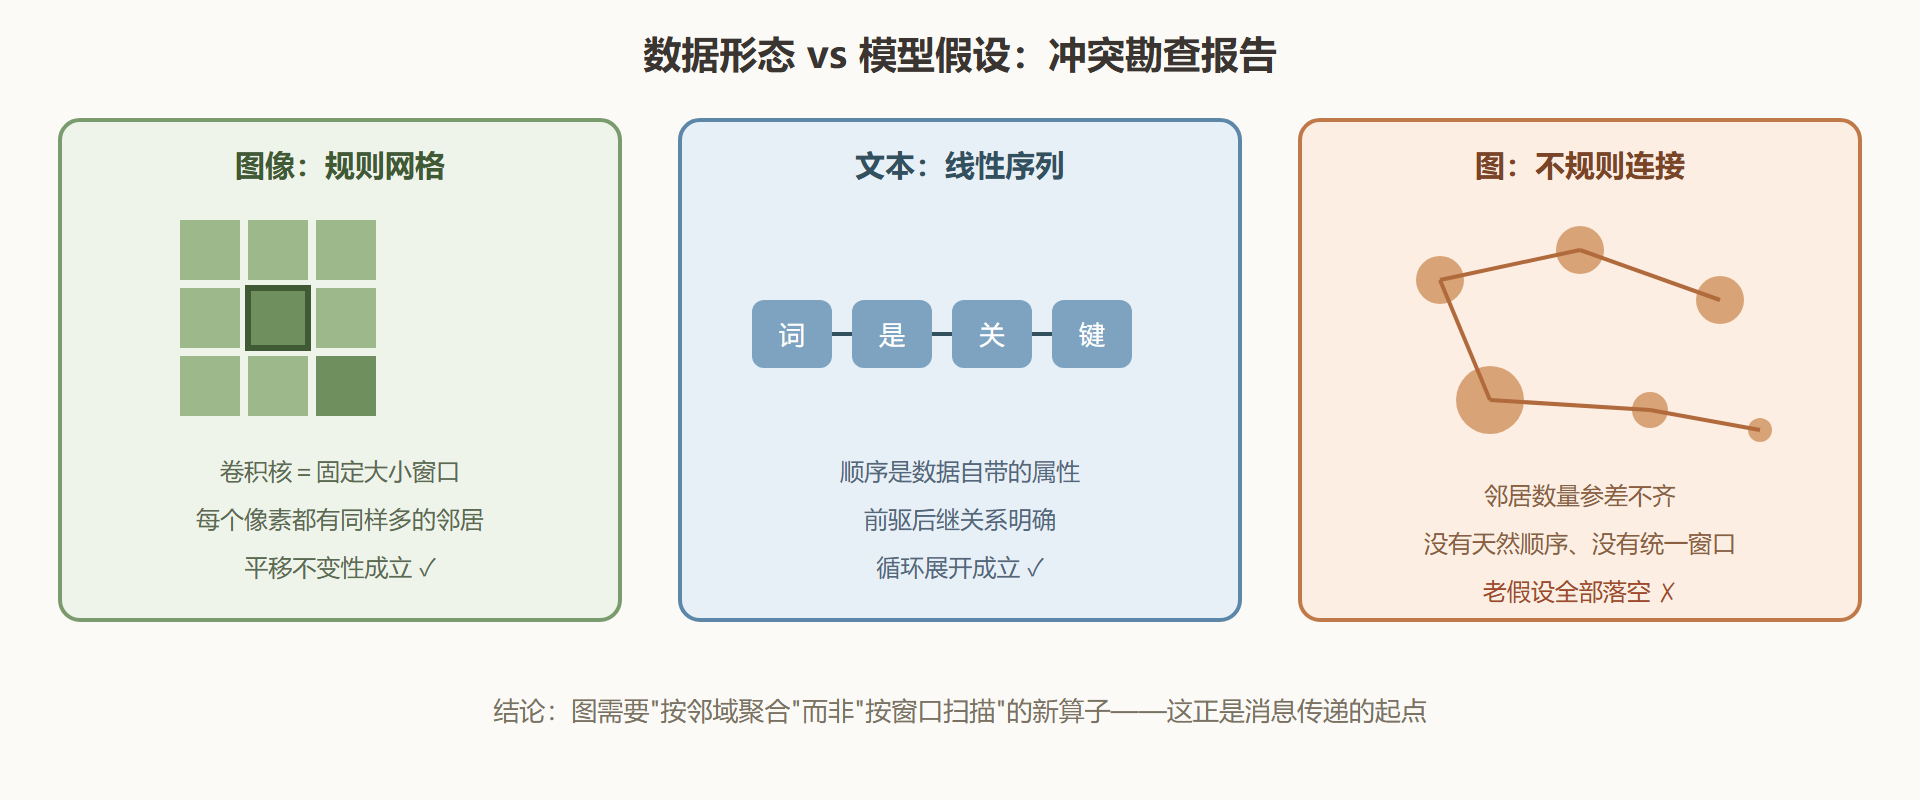
图:三种数据形态与三大模型的假设冲突
罪名一:卷积网络缺了平移不变性
图像卷积的效率建立在一个前提上:卷积核在图像每个位置都以相同形状的窗口取数——左上角的像素和右下角的像素都恰好拥有相同数目的网格邻居。图把这个前提连根拔起:社交现场里有的账号有几百个互动对象,有的账号只有零星几个;分子现场里碳原子可以有化学键连向多位邻居,而氢原子常常只连。卷积核在图上"滑不动",因为每个位置能取到的邻居集合形状都不一样。更麻烦的是,图上根本没有"上下左右"这种空间方位,两节点相邻只意味着有关系,不意味着它们在任何坐标系里彼此靠近——把图强行画成平面布局时,同一张图可以画出无数种不相像的嵌套样式,视觉距离不携带信息。
罪名二:序列模型强加了不存在的顺序
循环网络假设数据排成链状,当前状态吸收上一时刻的状态。可图上任意两节点之间只有"是否相连"与"路径长短",没有先后。你可以按账号注册时间给节点排序,也可以按编号、按拼音,随便哪种排法都同样"合法"又同样武断——顺序不是数据的属性,而是分析者强加的。更隐蔽的伤害在于路径结构:关系网里信息沿着边向四面八方扩散,而序列模型只能沿单链传递,分支结构会被强行截断成多条独立序列,交叉证据被白白丢弃。
罪名三:全连接网络对编号过敏
最朴素的做法是把邻接矩阵按行拼接成向量喂给全连接层。它确实能跑起来,但有个致命缺陷:对节点重编号过敏。同一张关系网,仅仅因为账号换了编号方式,拼接出的向量就完全不同,模型的输出随之漂移——而图本身一个字都没变。下面这段 NumPy 实验直接复现这个"翻供"现场:结构不变、仅置换编号,全连接网络的输出差异有多大。
import numpy as np rng = np.random.default_rng(42) n = 6 # 六个账号的小关系网 A = np.zeros((n, n)) edges = [(0,1),(0,2),(1,2),(2,3),(3,4),(4,5),(3,5)] for i, j in edges: A[i, j] = A[j, i] = 1 # 无向图对称 # 拼平邻接矩阵 → 全连接层(固定随机权重模拟训练后的模型) W = rng.normal(size=(n*n, 4)) def mlp_forward(adj): return np.tanh(adj.reshape(1, -1) @ W) out1 = mlp_forward(A) # 置换编号:结构完全相同,只是账号改了"名字" perm = rng.permutation(n) A2 = A[np.ix_(perm, perm)] # 同构图的另一种编号 out2 = mlp_forward(A2) print("输出1:", np.round(out1, 4)) print("输出2:", np.round(out2, 4)) print("差异范数:", np.linalg.norm(out1 - out2)) # 明显非零 # 同构的两张图,全连接层给出完全不同的答案——它学到的是编号规律而非结构规律
实验输出里差异范数显著大于零,说明全连接层把"编号方式"误当作了"图结构"本身。顺带还有第二重罪:输入维度被节点数锁死——输入层需要固定长度,换个更大规模的图就得重训整个网络,模型彻底丧失跨规模的归纳能力,这在每天都有新账号加入的业务现场等于宣判死刑。
罪名四:参数量与计算量的规模爆炸
如果坚持"为每个节点学习专属参数"的思路,参数量会随节点数线性甚至平方增长;把邻接矩阵整张喂进网络,矩阵乘法的开销对亿级边的社交图而言更是灾难。即便规模允许,逐节点独立学习也违背了关系数据的可迁移性——新节点的参数从哪里来?没有共享机制,就没有泛化。下面的对比实验展示"邻域大小不定"带来的工程麻烦:即便只想做最简单的邻域均值特征,也要处理不同节点邻居数差异巨大的现实。
# 同一张图上,不同节点的"邻域规模"差异巨大 deg = A.sum(axis=1) print("各节点度数:", deg.astype(int)) # [2 2 3 3 3 2] —— 小图尚且如此,真实社交图里度数可从个位数跨到百万级 # 朴素方案:为每个节点学一个专属向量 → 参数量 ∝ 节点数 naive_params = n * 16 # 每节点 16 维专属参数 # 共享方案:一套聚合参数,所有节点复用 → 参数量与节点数无关 shared_params = 16 * 16 print(f"专属参数量 {naive_params} vs 共享参数量 {shared_params}") # 节点数增长到百万时:专属方案 1.6e7 参数且无法处理新节点, # 共享方案参数量不变,新节点直接套用同一套聚合规则 # 邻域均值特征:注意除数各不相同(度为零的节点还要单独保护) with np.errstate(divide='ignore', invalid='ignore'): feat = A / deg[:, None] feat[~np.isfinite(feat)] = 0 print("行归一化邻接矩阵(每行求和为1):\n", np.round(feat, 3))
这段代码的最后部分其实已经悄悄给出了出路:行归一化的邻接矩阵乘上节点特征,就是最朴素的邻域均值聚合——第二章会看到,这正是图卷积的雏形。老办法的失灵不是终点,而是新算子的路标。
结案:失灵清单与出路
把三员主力的罪名汇总成表,失灵的根源指向同处:传统算子的结构假设(网格、顺序、独立性)与图的结构现实(不规则邻域、无顺序、强相关)不匹配。
| 模型 | 依赖的假设 | 图上的现实 | 后果 |
|---|---|---|---|
| 卷积网络 | 规则网格、平移不变 | 邻域大小不定、无方位 | 卷积核无处滑动 |
| 循环网络 | 线性顺序 | 无天然顺序、路径分叉 | 顺序武断、证据被截断 |
| 全连接网络 | 节点独立、输入定长 | 节点强相关、规模可变 | 对编号过敏、无法跨规模 |
出路已经浮出水面:需要一种对编号不敏感、按邻域聚合、参数共享的新算子。它就是下一章的主角——消息传递范式:每个节点向邻居取证,把证词聚合成新证据,层与层之间滚动推进。本节审讯台上留下的所有罪名,都将成为第二章设计新算子时的设计约束。