1.4 证物编码与预处理:让图能被张量吞噬
1.4 证物编码与预处理:让图能被张量吞噬
本节摘要:图神经网络的输入是节点特征矩阵 X(形状 N×F)、边索引与可选的边特征矩阵。本节完成立案阶段的收官工序:把类别属性、数值属性、文本属性编码为特征向量,对特征做标准化与归一化,划分直推式或归纳式的训练测试集,并预告大规模图的采样预处理。工序完成后,卷宗即达到"可训练"状态。
为什么要专门花一节谈编码
口供是文字、物证是照片、账目是表格——这些原始证物要进神经网络,都得先翻译成同一语言:定长浮点向量。编码质量差,再好的模型也是在错误证词上推理。本章前三节完成了勘查、定责与建档,本节处理立案的最后一道工序,产出的特征矩阵会直接作为第二章消息传递的输入。编码环节最容易踩的坑不是"不会编码",而是"编码时偷看了测试集信息"或"对图结构视而不见"——下面按特征构造、数值处理、数据切分、结构预处理四道工序展开。
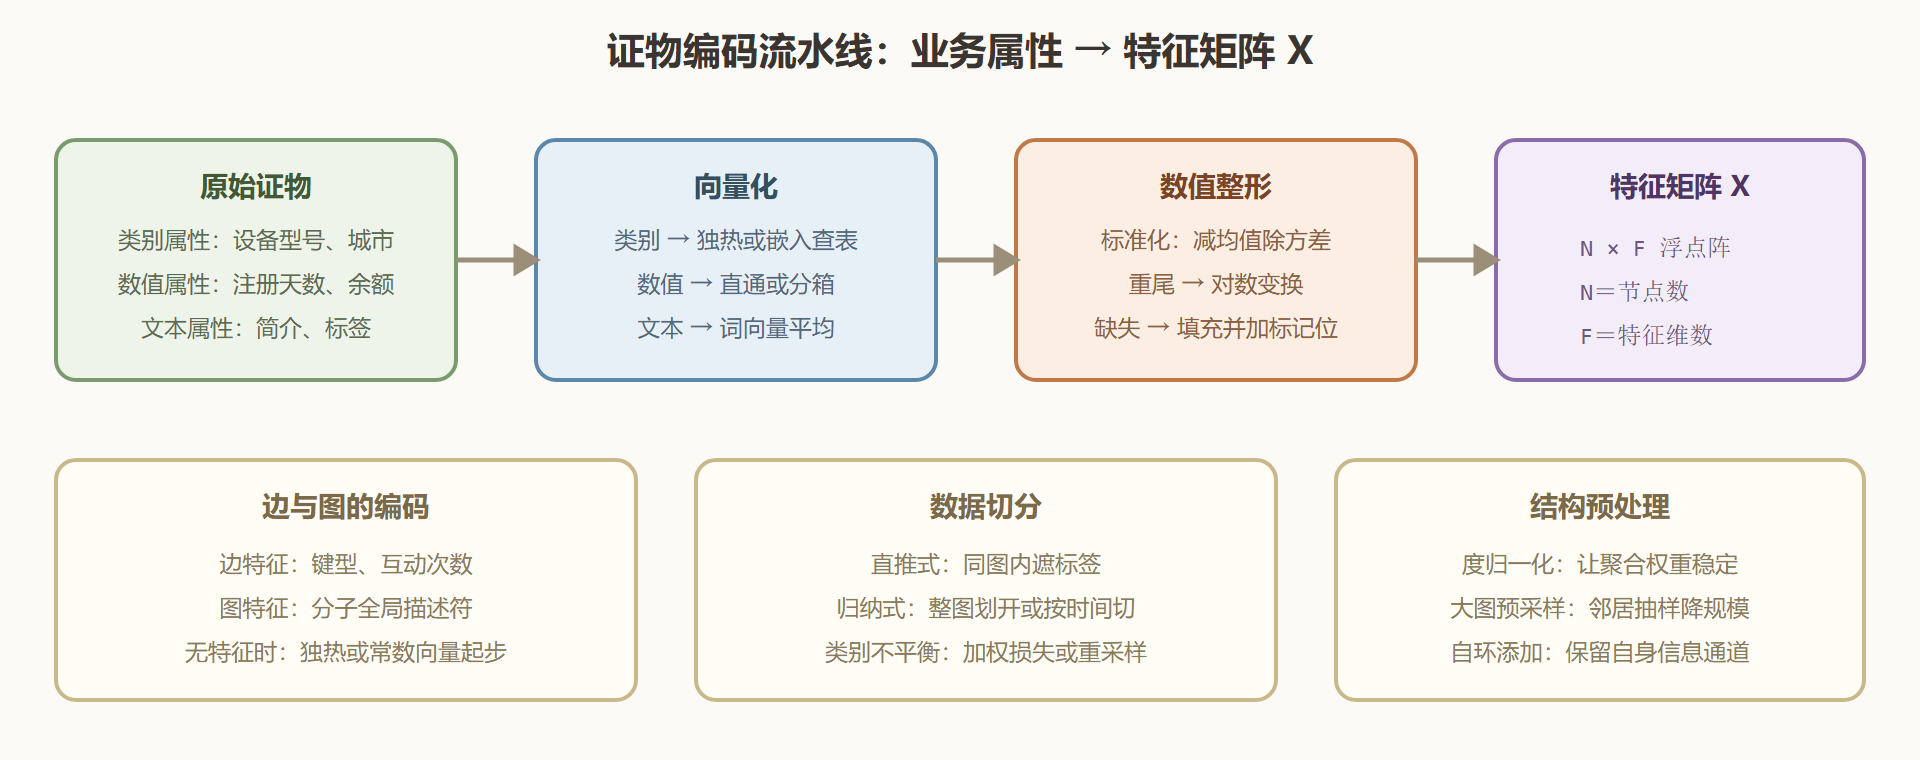
图:从原始证物到可训练张量的编码流水线
工序一:节点特征怎么构造
节点特征的来源五花八门。类别属性(设备型号、注册城市、账号等级)最常见的做法是独热编码;当类别取值很多时,独热维度爆炸,改用嵌入查表——为每个类别学一个低维稠密向量,这本身就是模型可学习的部分。数值属性(注册天数、粉丝数、余额)原则上可以直接进入特征,但要注意量纲:余额以万计而等级只有个位数时,不处理量纲等于让大数值特征独占梯度。文本属性(简介、标签)通常先转词向量再取平均或最大池化,得到定长摘要向量。
特殊情况值得单独说:如果现场完全没有节点属性(比如匿名通讯网络),可以用结构特征兜底——节点度数、聚类系数、三角计数,甚至直接用单位向量或常数向量。图卷积的放大器是邻域聚合,哪怕初始特征毫无信息,多层聚合之后结构差异也会被逐渐拉开;当然,有好的原始特征永远是上策。
import numpy as np # 模拟账号表:类别属性 + 数值属性混合的原始证物 raw = [ {"device": "iOS", "city": "SH", "reg_days": 320, "balance": 54000.0}, {"device": "Android", "city": "BJ", "reg_days": 18, "balance": 120.0}, {"device": "iOS", "city": "SZ", "reg_days": 1400, "balance": 8900.0}, {"device": "Web", "city": "SH", "reg_days": 260, "balance": 1500.0}, ] # 类别 → 独热;数值 → 拼接(下一道工序再统一做数值整形) device_map = {"iOS": [1,0,0], "Android": [0,1,0], "Web": [0,0,1]} city_map = {"SH": [1,0,0], "BJ": [0,1,0], "SZ": [0,0,1]} rows = [] for r in raw: rows.append(device_map[r["device"]] + city_map[r["city"]] + [r["reg_days"], r["balance"]]) X = np.array(rows, dtype=float) print("原始特征矩阵(4 节点 × 8 维):\n", X) # 问题肉眼可见:balance 的量级碾压其他维度,必须整形
工序二:数值整形与归一化
数值整形的目的是让各特征维度处于相近的数值范围,避免量纲支配梯度。标准做法是按列标准化(减均值除标准差),重尾分布(金额、播放量)先取对数再标准化。注意两个纪律:其一,统计量只能从训练集计算——编码阶段最常见的泄漏就是用全量数据的均值方差做标准化,等于让模型提前偷看了测试集的分布;其二,对图数据而言还有"结构维度的归一化"——度数差异极大的节点在聚合时输出量级会随邻居数起伏,因此邻接矩阵通常做行归一化或对称归一化(上一节的度矩阵在此登场),这属于模型侧的预处理,第二章与第三章会反复用到。
# 按列标准化:只用训练节点行的统计量(此处假设前两行是训练集) train_part = X[:2] mu, sigma = train_part.mean(axis=0), train_part.std(axis=0) sigma[sigma == 0] = 1.0 # 防除零 X_std = (X - mu) / sigma print("标准化后:\n", np.round(X_std, 3)) # 重尾特征先取对数再标准化(金额类特征的常规操作) log_bal = np.log1p(X[:, -1]) print("余额对数化后:", np.round(log_bal, 3))
工序三:训练集怎么切——直推式与归纳式
图数据的切分方式与表格数据有本质差异,必须按办案模式二选一。直推式适用于"整张图固定、任务是在同图内给未标注节点补标签"的场景:图里所有节点(含测试节点)的边与特征训练时都可见,只是遮住部分标签——类似侦探掌握了全部关系网,只是部分嫌疑人的罪行待定。经典引文数据集(论文分类)就是这种模式。归纳式适用于"训练后要处理全新图或新节点"的场景:训练集与测试集是不同的图,或按时间把早前的图做训练、后来的图做测试——类似用旧案训练办案能力,再去破新案。社交平台的欺诈检测通常是归纳式:新用户不断入场,模型必须对没见过的节点直接推断。切分方式要与业务一致,直推式指标不能外推成归纳式能力,两者差距在真实系统里常常大得惊人。此外,类别不平衡(欺诈场景里坏账号占比极低)要用加权损失或重采样处理,这个话题在第五章损失函数一节展开。
工序四:结构侧的预处理
还有几项作用于图本身而非特征矩阵的预处理。自环添加:给每个节点连一条指向自己的边,保证聚合时自身旧状态不被丢弃——GCN 的公式里默认含自环。度归一化:把邻接矩阵按度归一,使聚合输出不随邻居数量漂移。大图采样:当整图大到无法全量训练时,按邻居抽样把大图切成可训练的子图批次,GraphSAGE 与第五章的训练阵型都建立在这之上。去冗余边与过滤噪声边也属于此列——立案阶段对可疑边做降噪,往往比换更强的模型更能提升指标。
最后把工序成果装配成 PyTorch Geometric 的标准数据对象,它是后续所有代码实战的通用容器。
import torch from torch_geometric.data import Data # 结构:边索引(2 × E 的长整型张量,按边对列出) edge_index = torch.tensor([[0, 1, 0, 2, 2, 3], [1, 0, 2, 0, 3, 2]], dtype=torch.long) # 特征:把上一步的 X_std 装进来(示意用小矩阵) x = torch.tensor(X_std[:, :4], dtype=torch.float) # 标签:欺诈检测示意,1=可疑 y = torch.tensor([0, 1, 0, 0]) data = Data(x=x, edge_index=edge_index, y=y) print(data) # Data(x=[4, 4], edge_index=[2, 6], y=[4]) print("节点数:", data.num_nodes, "边数:", data.num_edges) # 此对象可直接送入第二章的任何消息传递模型——立案阶段至此收官
立案阶段总结
本节之后,任何关系型业务现场都能被翻译成统一格式:特征矩阵描述嫌疑人画像、边索引描述关系线索、掩码或独立图描述训练测试边界。四道工序的核心纪律只有两条——不让信息从测试集泄漏进训练过程,不让量纲与规模差异扭曲聚合。下一章正式进入走访阶段:消息传递范式将规定"证词如何流动、如何聚合、如何更新档案",那是图神经网络真正的发动机。