1.3 建档手册:图论基础、图类型与三种表示法
1.3 建档手册:图论基础、图类型与三种表示法
本节摘要:图 G 由节点集 V 与边集 E 构成;度数衡量节点的关系数量;有向与无向、加权与非加权、同构与异构是卷宗的三组基本分类。本节承接前两节——现场勘查完毕、旧手段出局,现在按图论规范把卷宗正式建档:先补齐图类型分类法,再比较邻接矩阵、邻接列表、边列表三种装订方式,最后预备度矩阵与拉普拉斯矩阵,为第二章的谱域卷积铺路。
建档的第一行:形式化定义
图论的正式定义只需短短几行:图 G 由节点集合 V 与边集合 E 组成,每条边连接一对节点;节点数记作 N,边数记作 M。侦探社的翻译是——节点是嫌疑人档案袋,边是已核实的关系线索。上一节审讯结束、确认需要新算子之后,本节的任务是把业务现场翻译成这套标准档案格式:你将学会判断该建有向图还是无向图、该不该给边配权重、什么情况下必须升级为异构图,以及三种装订方式(邻接矩阵、邻接列表、边列表)各自的存储代价与查询效率。这些选择看似琐碎,却直接决定第二章每个模型的输入形态与运行效率。
三组分类法:给卷宗定类型
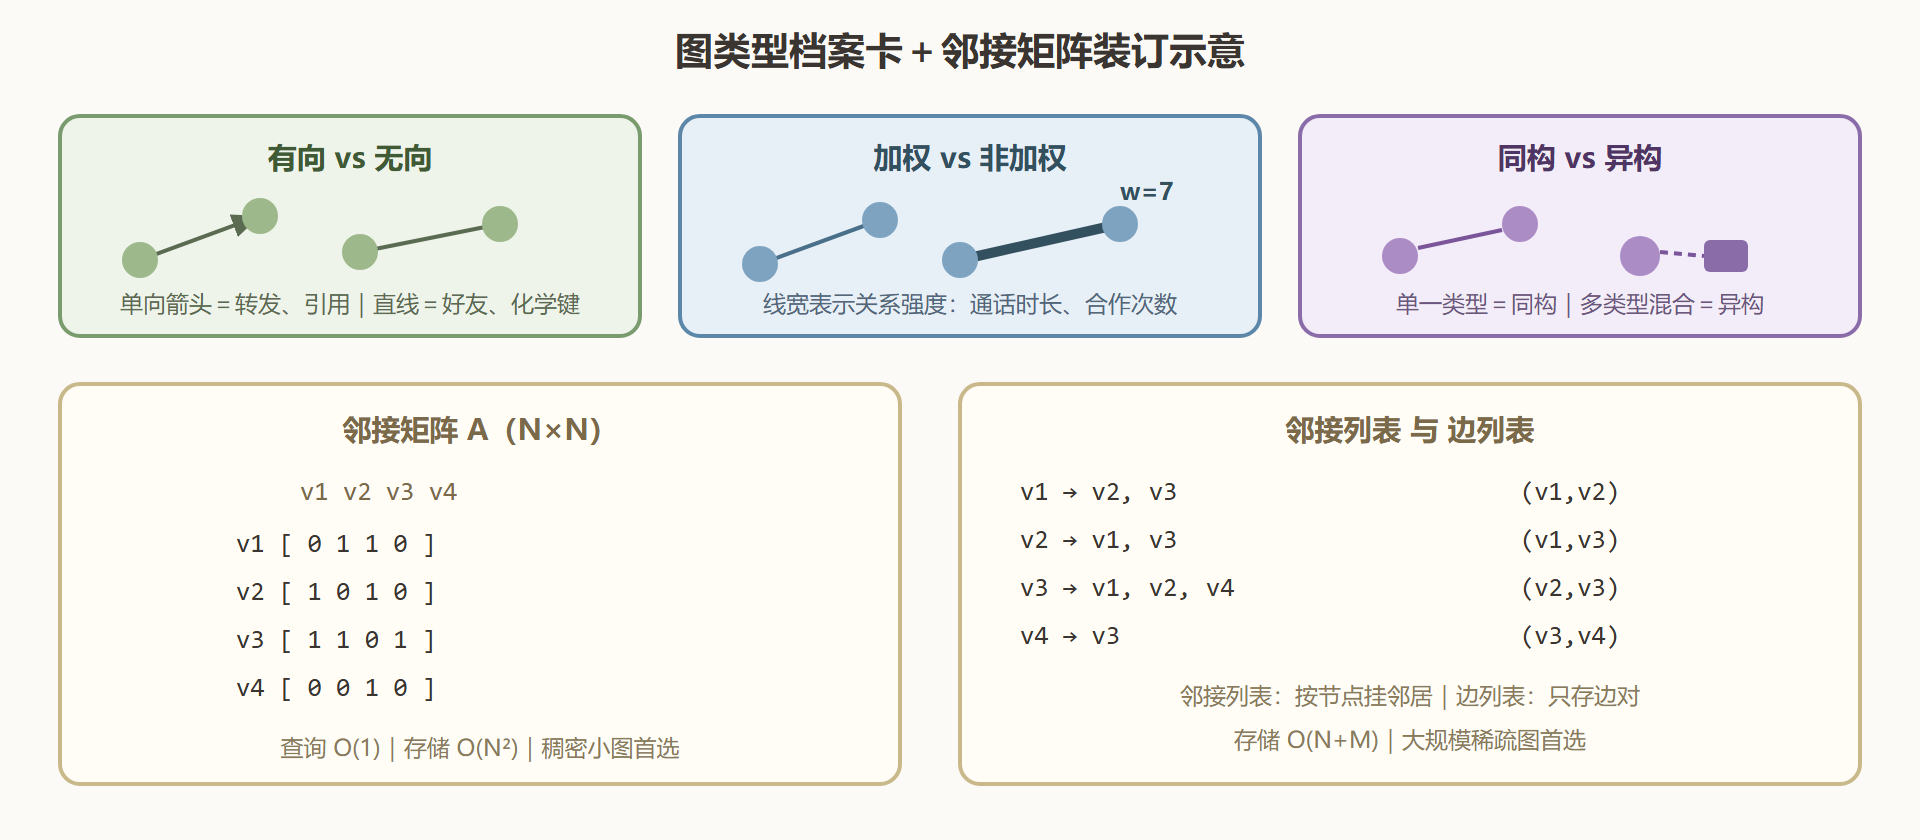
第一组分类看方向。转发是单向动作(A 转发 B 不代表 B 转发 A),引用论文也是单向(引文网络里"被引"与"引用"身份不同),这类卷宗要建有向图;好友关系互相成立,化学键不分方向,建无向图即可。方向装错,图的语义就错了——把有向边当无向边处理,等于把"单方面关注"当成"互相关注",团伙判定会严重走样。
第二组分类看权重。权重表示关系的强度或代价:路网现场里路段权重是通行时间,合作网络里权重是合作次数,通讯网络里权重是通话分钟数。非加权图里所有边一律平等,信息量少但建模简单。是否加权取决于"强度差异是否携带证据"——如果互动次数的多寡对破案有影响,就应当建加权图。
第三组分类看节点与边的类型是否唯一。只用单一类型节点(全是用户)与单一类型边(全是好友)构成的是同构图;推荐系统的用户-商品二部图、学术论文网络里的"作者-论文- venue"混合结构,节点或边存在多种类型,属于异构图。异构图的建模手段要到第六章才展开,但立案时就要判断清楚,因为它决定了能否直接使用第三章的经典模型。
图:图类型档案卡片与邻接矩阵示意
三种装订方式的取舍
邻接矩阵把关系装订成方阵:A 的第 i 行第 j 列为 1(或权重值)表示节点 i 与 j 相连。它的优点是查询快——任意两节点是否相邻直接查表,且矩阵乘法天然适配张量运算,第二章的图卷积公式直接建立在它之上。代价是存储:N 个节点需要 N 平方规模的存储单元,社交图动辄百万节点,矩阵里绝大部分位置是零(真实图往往高度稀疏),空间全部浪费在"存零"上。邻接列表只为每个节点挂一份邻居清单,空间与节点数加边数成正比,是大图的标准装订;代价是"某两点是否相邻"这类随机查询要扫清单。边列表最省——只记边对本身,适合边数据流式到达的场景(比如持续写入的互动日志),但按节点聚邻居需要额外索引。工程惯例:小图实验用邻接矩阵图个方便,大图生产用邻接列表或边列表加索引;PyTorch Geometric 内部正是用"边索引表加稀疏聚合"来兼顾两者。
import networkx as nx import numpy as np G = nx.Graph() G.add_edges_from([(0,1),(0,2),(1,2),(2,3)]) A = nx.to_numpy_array(G, nodelist=sorted(G.nodes())) print("邻接矩阵:\n", A.astype(int)) # 同一张图的三种装订 print("邻接列表:", {v: list(G.neighbors(v)) for v in G.nodes()}) print("边列表:", list(G.edges())) # 稀疏性:随机大图里零占比迅速失控 rng = np.random.default_rng(0) big = nx.gnp_random_graph(2000, 0.002, seed=rng) dens = nx.density(big) print(f"两千节点图 邻接矩阵占用 {2000*2000:,} 单元,实际边 {big.number_of_edges()},密度 {dens:.5f}")
度矩阵与拉普拉斯矩阵:为谱方法预备的档案
在邻接矩阵之外还有两份派生档案会反复出场。度矩阵 D 是对角阵,对角线上放各节点的度数——它记录"每个节点有多少关系"。拉普拉斯矩阵 L 定义为 D 减 A(度数减邻接),它像图的"微分算子":把 L 作用到节点信号上,得到的是每个节点与它邻居的差值总和,物理直觉类似离散化的二阶导数。谱域图卷积的全部推导都建立在 L 的特征分解上,这里先把档案备好,推导留给第二章。
A = nx.to_numpy_array(G, nodelist=[0,1,2,3]) D = np.diag(A.sum(axis=1)) # 度矩阵 L = D - A # 未归一化拉普拉斯 print("度矩阵:\n", D.astype(int)) print("拉普拉斯:\n", L.astype(int)) # 验证拉普拉斯的"差值"直觉:信号 x 上 (Lx)_i = Σ(邻居差) x = np.array([3.0, 1.0, 4.0, 1.0]) print("L @ x =", L @ x) # 每个分量=该节点值×度数−邻居值之和 # 归一化版本:对称归一化拉普拉斯,谱方法与 GCN 都要用 d_half = np.diag(1.0 / np.sqrt(A.sum(axis=1))) L_sym = np.eye(4) - d_half @ A @ d_half print("对称归一化拉普拉斯(保留三位):\n", np.round(L_sym, 3))
建档须知:拉普拉斯矩阵是半正定的,它的特征值全部非负、特征向量构成一组正交基——这组基就是"图的傅里叶基"。现在记下这条性质即可,第二章会把它变成卷积的定义。
建档检查清单
- 方向:转发、引用、关注等单向行为建有向图;好友、化学键建无向图。
- 权重:互动次数、通行时间等强度证据写入边权重;无强度差异则建非加权图。
- 类型:节点或边存在多类型时需按异构图建档(模型见第六章)。
- 装订:矩阵查询快、耗空间;列表省空间、查询慢;边列表适合流式写入。
- 派生档案:度矩阵记录关系数量,拉普拉斯矩阵是谱方法的入场券。
工程实践里还有一条容易被忽略的建档纪律:图一旦定稿,节点编号要与业务主键建立稳定映射并冻结。后续增量数据(新账号、新分子)追加编号时从末尾续排,绝不重排旧编号——编号重排会让所有已训练的模型、已导出的嵌入、已缓存的邻域索引集体作废,这是数据团队最常踩的"静默炸弹"之一。卷宗装订完成后再补一份"图快照说明"(节点数、边数、建图时间窗、过滤规则),归档时连同数据一起入库,复盘时才有据可查。
卷宗建档完成,下一节处理档案里的最后一道工序——把口供、物证这些原始特征编码成张量世界通用的形态,立案阶段即可宣告收官。