2.1 标准走访流程:消息传递范式
2.1 标准走访流程:消息传递范式
本节摘要:消息传递范式规定每个节点按"生成消息、聚合消息、更新状态"三步吸收邻域信息:消息函数决定"证词怎么说",聚合函数决定"证词怎么汇总",更新函数决定"档案怎么改写"。层数等于走访半径——两层网络让每个节点看到邻居的邻居。本节是第二章的理论地基,也是后续所有模型的总章程。
行话入门:邻域与消息
「邻域聚合」是图学习世界的行话,指每个节点把相邻节点的特征收拢进来更新自己的表示——侦探社的对应操作叫走访取证。第一章立案完成后,卷宗已经具备特征矩阵与边索引,本节把"侦探如何走访"写成数学规程。这套规程有个更正式的名字:消息传递范式(Message Passing Paradigm),几乎所有图神经网络模型都遵循它,区别只在每一步选什么函数。理解了本节,第三章的五个模型就只是五份不同的实施细则。
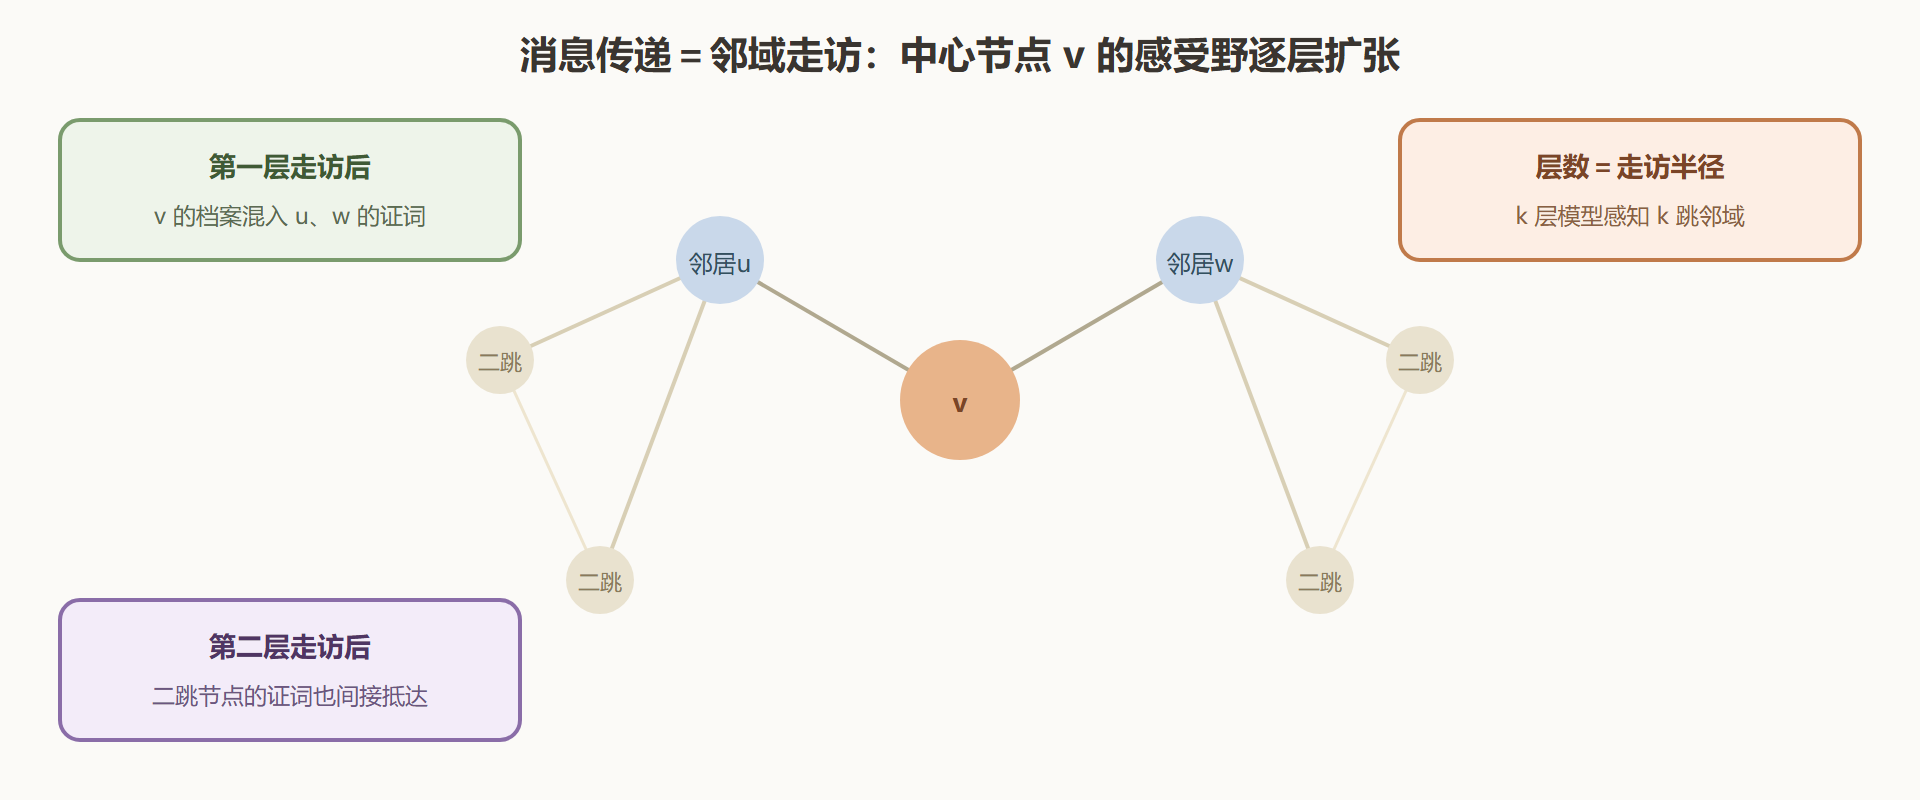
图:三轮走访中信息的扩散路径
规程总纲:三步曲
消息传递范式把一轮走访拆成三步。第一步,消息生成:每个邻居节点 u 面向目标节点 v 生成一条消息,消息函数通常是个小型神经网络(线性变换加激活),输入是双方的特征、必要时还有边上的特征——证词的内容由"关系人与嫌疑人双方的情况"共同决定。第二步,消息聚合:节点 v 把收到的所有消息汇总成一个向量,聚合函数必须满足置换不变性——邻居以任何顺序到场,汇总结果不变;均值、求和、最大值都满足这一要求。第三步,状态更新:节点 v 结合自己的旧档案与聚合结果,生成新档案,更新函数可以是简单拼接加线性层,也可以是门控循环单元。写成公式就是:消息 m 由消息函数生成,聚合结果是所有邻居消息经聚合函数的汇总,新状态 h 由更新函数融合旧状态与聚合结果得到。经过一轮三步曲,图中每个节点的表示都完成一次刷新。
关键推论随之而来:层数就是走访半径。第一层走访后,节点表示吸收了直接邻居;第二层的输入已经是"含邻居信息的表示",再聚合一轮,等于把邻居的邻居(二跳关系人)的证词间接引入。k 层网络对应 k 跳感受野。这也解释了为什么图神经网络通常只叠两三层——感受野随层数指数式扩张,叠太深反而让所有节点"听遍了全城的传闻",表示趋同,这正是第五章过平滑问题的伏笔。
import numpy as np rng = np.random.default_rng(7) n, d = 6, 4 # 六个节点,四维特征 A = np.zeros((n, n)) for i, j in [(0,1),(0,2),(1,2),(2,3),(3,4),(4,5),(2,5)]: A[i, j] = A[j, i] = 1 X = rng.normal(size=(n, d)) # 初始档案(第 0 层表示) W_msg = rng.normal(size=(d, d)) * 0.5 # 消息函数:线性变换 W_updt = rng.normal(size=(2*d, d)) * 0.5 # 更新函数:拼接后投影 def relu(z): return np.maximum(z, 0) def one_round(X, A): # 第一步:消息生成 —— 每个邻居把自己的特征变换成"证词" M = relu(X @ W_msg) # 所有节点的消息版本 # 第二步:消息聚合 —— 行归一化邻接矩阵做"邻域均值" D_inv = np.diag(1.0 / A.sum(axis=1)) agg = D_inv @ A @ M # 每行=邻居消息的均值 # 第三步:状态更新 —— 旧档案与聚合证词拼接后投影 return relu(np.hstack([X, agg]) @ W_updt) H1 = one_round(X, A) # 第一层走访 H2 = one_round(H1, A) # 第二层走访:二跳信息进入 print("第 0 层 节点0:", np.round(X[0], 3)) print("第 1 层 节点0:", np.round(H1[0], 3)) print("第 2 层 节点0:", np.round(H2[0], 3)) # 三份档案各不相同:层级越深,掺入的邻域成分越丰富
感受野的验证实验
"层数等于走访半径"这个论断可以直接验证。做法很侦探:给每个节点注入只有自己知道的"暗号"特征,然后数一数经过几轮消息传递后,目标节点的表示里能检测到谁的暗号。
# 身份暗号实验:节点 i 的初始特征只有第 i 维为 1,其余为 0 X_id = np.eye(n) # 用"求和聚合+直通更新"(不加权、不投影),让传播路径纯粹可见 def trace(X, A): return A @ X # 每个节点=邻居暗号之和 T1 = trace(X_id, A) print("一轮后 节点2 收到的暗号来源:", np.nonzero(T1[2])[0]) # 直接邻居 T2 = trace(T1, A) print("两轮后 节点2 收到的暗号来源:", np.nonzero(T2[2])[0]) # 扩展到二跳 # 结论:两轮传播后,二跳节点的身份信号已经出现——感受野确实随层数扩张
这个朴素实验同时演示了信息扩散的两面性:邻域信息进入是收益,远端噪声混入是代价。感受野不是越大越好——社交图里两跳大约覆盖"朋友的朋友",尚在业务语义之内;十几跳之后所有账号的表示都在平均全网的传闻,区分度反而坍缩。深度选择因此成为图模型最敏感的超参之一,第五章会给出系统的选型与诊断方法。
边特征与异质消息
基础规程里消息只依赖两端节点的特征,但现场往往要求把"关系本身的属性"写进证词:通讯录里的"通话频次"、分子里的"键型"、交易图里的"金额"都是边特征。改造方法直白——把边特征拼进消息函数的输入,让证词内容随关系类型变化。若不同类型的边需要不同的消息函数(比如"好友互动"与"共同设备"适用不同问询方式),就为每类边配独立的消息函数再分别聚合,这正是第六章异构图模型的思想雏形。本节先记住:规程骨架不变,变的是每一步里塞进去的信息与函数。
常见误区与要点
- 把"消息传递"与"特征拼接"混为一谈:直接把邻接矩阵行拼到特征后面喂全连接层,不是消息传递——聚合必须发生在函数内部且对邻居顺序不敏感。
- 忘记自环:不带自环的聚合会丢掉节点自身旧档案,更新全靠邻居证词;工程惯例是给邻接矩阵加单位阵再归一化。
- 层数贪多:走访半径按层数扩张,深网络在多数图任务上收益递减甚至变负,两三层是稳妥起点。
- 聚合函数随手选:均值抹平规模信息、求和保留规模信息,选错聚合在"数邻居数就有意义"的任务上会直接吃亏——2.3 节专门审这个问题。
本节确立了总章程:三步曲加感受野直觉。下一节勘验"图卷积"这个术语的两条理论来路——谱域与空间域,看它们如何在"聚合权重"上殊途同归。