2.2 双路线勘验:谱域卷积与空间域卷积
2.2 双路线勘验:谱域卷积与空间域卷积
本节摘要:谱域路线把图卷积定义为"图傅里叶域上的逐点乘法"——先用拉普拉斯特征向量把信号变换到频率空间,滤波后再变换回来;空间域路线直接定义"邻域特征的加权聚合"。切比雪夫多项式近似是双路线的汇合点:它把谱域滤波器改写成局部运算,落到每个节点的 k 跳邻域上。本节把双路线各推一遍,最终统一到"聚合权重"这个视角。
从一个类比进入谱域
最初的图卷积定义来自信号处理传统:给一张图配上"频率"的概念,再在频率空间里做滤波。侦探社的翻译是——走访记录可以按"波动快慢"分解:相邻节点值相近的是低频成分(缓慢变化的全城背景),相邻节点值剧烈反转的是高频成分(局部异常波动)。上一节确立了消息传递的走访规程,本节要回答规程背后的理论问题:凭什么"邻域加权聚合"配得上"卷积"这个名字?答案有两条推导路径,分别从频率分析与局部运算出发,最终在同一个公式上会师。先走谱域。
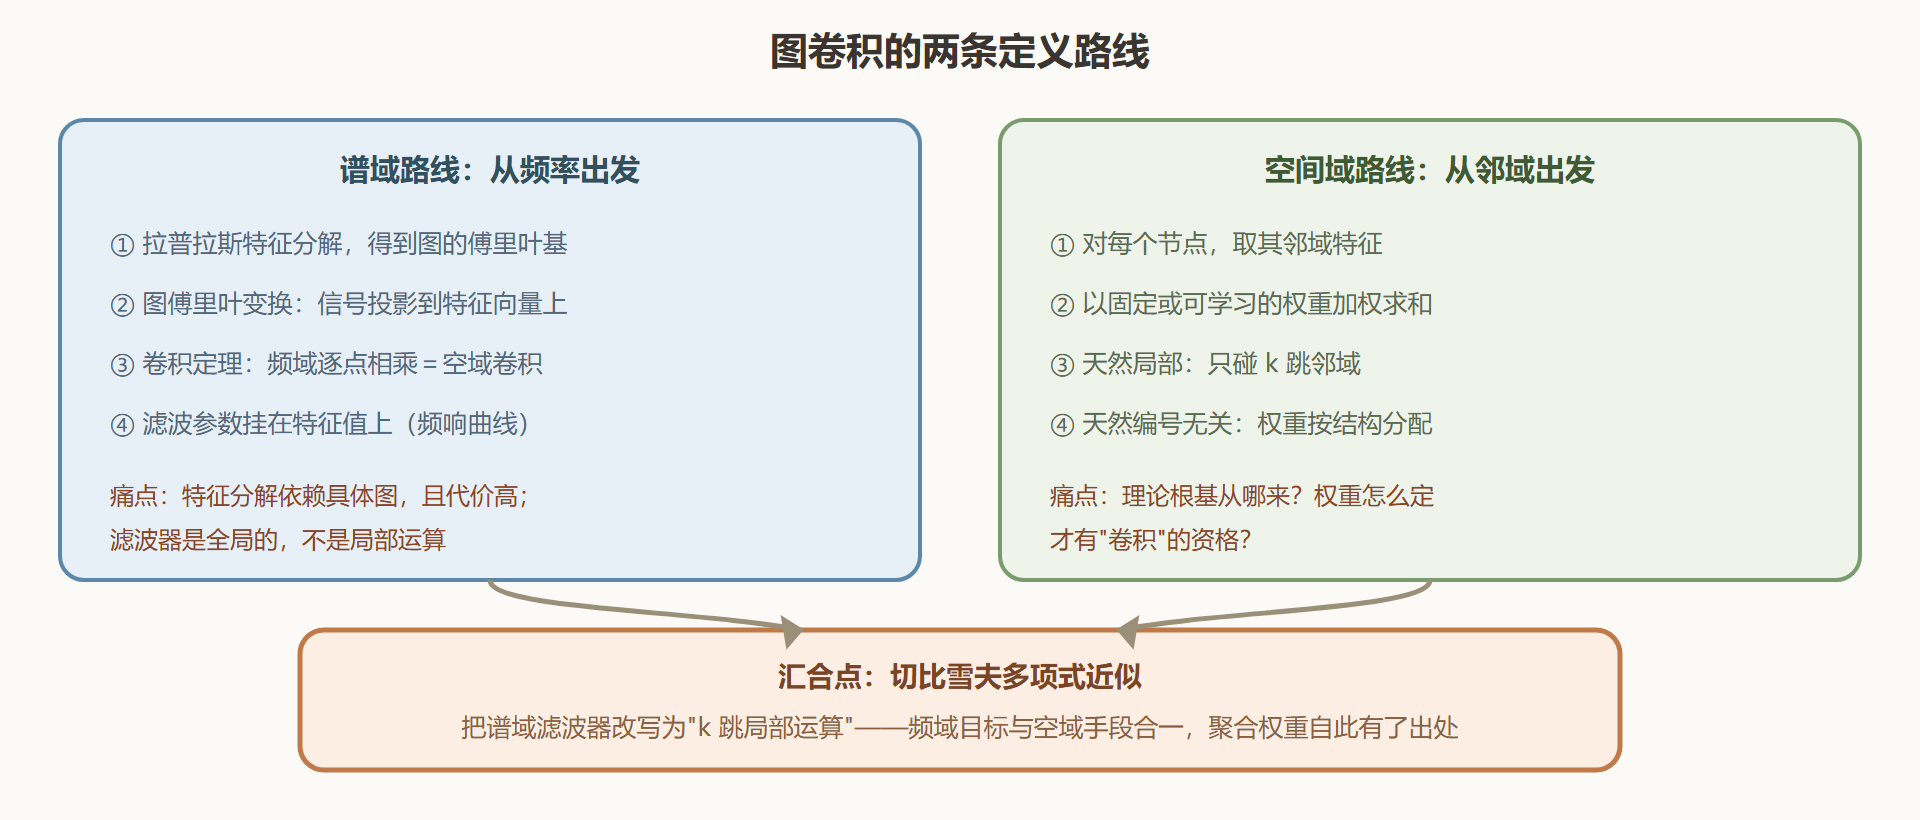
图:谱域与空间域两条路线的汇合
谱域勘验:给图配上频率
回忆第一章备好的档案:拉普拉斯矩阵 L 是半正定对称阵,可做特征分解,写成 L 等于 U 乘对角阵再乘 U 转置,其中 U 的列是一组正交特征向量,对角阵放着对应的非负特征值。把这组特征向量当作"图的傅里叶基",经典信号处理的概念就能平移过来:把节点信号 x 用 U 转置左乘,得到它在每个特征向量方向上的坐标,这就是图傅里叶变换;坐标的平方和集中在小特征值方向,说明信号沿图变化缓慢(低频),集中在大特征值方向则说明信号在相邻节点间剧烈翻转(高频)。特征值因此被当作"图频率"使用。卷积定理在此登场:时域(这里换成"图域")的卷积等价于频域的逐点相乘。于是图卷积的谱域定义浮出水面——把两个信号各自做图傅里叶变换,逐点相乘,再做逆变换回来。
import numpy as np import networkx as nx G = nx.path_graph(6) # 链状图:频率概念最直观 A = nx.to_numpy_array(G, nodelist=range(6)) L = np.diag(A.sum(1)) - A eigvals, U = np.linalg.eigh(L) # 特征向量=图傅里叶基 print("特征值(图频率):", np.round(eigvals, 4)) # 两个对照信号:低频(缓慢变化)与高频(逐点反转) x_low = np.array([1., 1.2, 1.4, 1.6, 1.8, 2.0]) x_high = np.array([1., -1., 1., -1., 1., -1.]) def gft(x): return U.T @ x # 图傅里叶变换:能量按频率展开 print("低频信号的频谱能量:", np.round(gft(x_low)**2, 3)) print("高频信号的频谱能量:", np.round(gft(x_high)**2, 3)) # 低频能量集中在小特征值处,高频集中在大特征值处——"频率"语义成立 # 谱域滤波:保留低频、压制高频(低通) filter_resp = 1.0 / (1.0 + 8 * eigvals) # 频响曲线:随频率衰减 x_f = U @ (filter_resp * gft(x_high)) # 频域逐点乘,再逆变换 print("高频信号低通滤波后:", np.round(x_f, 3)) # 逐点反转的振荡被抹平——滤波在图上生效
这段代码把"图频率"从抽象概念变成可触摸的对象:链图上相邻节点值交替的信号确实是高频,低通滤波确实能把它抹平。谱域路线的图卷积网络最初版本,就是把这个流程里"频响曲线"的位置换成可学习参数——参数直接挂在特征值上,每张图都要重新做特征分解,滤波器还是全局运算(改一个参数,所有节点的输出都变),既慢又不利于跨图泛化。
切比雪夫近似:从全局频域到局部邻域
转机来自多项式近似:把频响函数限制为特征值的低阶多项式,图卷积就能改写成拉普拉斯矩阵的多项式乘信号的形式。进一步用切比雪夫多项式展开并做尺度归一,会得到漂亮的性质——k 阶多项式滤波器恰好只依赖每个节点的 k 跳邻域。谱域的滤波器从此落地成空间域的局部运算:想保留低频,等价于对邻域特征做特定权重的加权平均;阶数越高,可表达的频响曲线越复杂,感受野也越大。这是两条路线的正式会师点,也是"邻域聚合配得上卷积之名"的理论凭证。
# 切比雪夫一阶近似的直观演示:k=1 时滤波只看直接邻域 I = np.eye(6) L_tilde = L - I # 重标度前的简化:直接用归一化想法 D_half = np.diag(1.0 / np.sqrt(A.sum(1))) L_norm = I - D_half @ A @ D_half # 对称归一化拉普拉斯 # "低通滤波"的多项式形式:I 减去 L_norm 的常数倍 lowpass = I - 0.5 * L_norm x_lowpass = lowpass @ x_high print("多项式低通(一阶):", np.round(x_lowpass, 3)) # 与谱域滤波结果同向:振荡被压制,且只用了邻域信息(L_norm 每行至多两个非零) print("L_norm 每行非零个数:", (np.abs(L_norm) > 1e-9).sum(axis=1))
一阶切比雪夫近似再经简化(权重合并、取单参数)就得到教科书上的 GCN 传播式:对称归一化邻接矩阵乘特征矩阵乘权重矩阵——这正是第三章第一套办案装备的公式,此处先按下不表。谱域路线的贡献是把"聚合权重的形状"与"频率选择"挂钩:归一化系数对应低通滤波,让邻域均值进入表示,也埋下了深层网络"人人都像均值"的过平滑病根。
空间域勘验:直接在邻域上定义运算
空间域路线绕开特征分解,直接规定:图卷积就是每个节点对邻域特征做加权聚合,权重由设计者或模型决定。它天然具备两个谱域初期缺乏的优点——局部性(只碰邻域)与编号无关性(权重按结构而非下标分配)。代价是理论约束松散:任意聚合都能自称"图卷积",权重设计缺乏频率视角的指导。实践中两条路线早已融合:切比雪夫近似证明"合理的空间聚合等价于某种谱域滤波",而现代模型(GraphSAGE、GAT)干脆直接在空间域定义权重——前者固定采样加均值池化,后者用注意力学权重,其频响特性可事后分析。选型时记住对照表即可。
| 维度 | 谱域路线 | 空间域路线 |
|---|---|---|
| 定义出发点 | 图傅里叶域逐点乘法 | 邻域特征加权聚合 |
| 理论根基 | 卷积定理、特征分解 | 局部性与置换不变性 |
| 计算代价 | 特征分解昂贵 | 稀疏矩阵乘,便宜 |
| 跨图泛化 | 依赖具体图的特征基 | 天然可跨图 |
| 代表模型 | 早期谱网络、切比雪夫网络 | GraphSAGE、GAT 及多数现代模型 |
| 汇合点 | 切比雪夫多项式把滤波器改写为局部运算 | —— |
要点归档
- 图频率:拉普拉斯特征值从小到大对应信号沿图变化的快慢,特征向量就是图上的正交基。
- 谱域卷积:图傅里叶变换、频域逐点乘、逆变换——卷积定理在图上的移植。
- 切比雪夫近似:低阶多项式滤波器只依赖 k 跳邻域,谱域目标与空间域手段在此合一。
- 空间域卷积:邻域加权聚合,胜在局部、便宜、可跨图;权重设计是各家模型的分野。
- 暗线:归一化均值聚合近似低通滤波——第五章过平滑问题的理论源头已在此埋下。
聚合权重确定后,还剩一个问题:证词汇总该用什么函数——均值、求和还是最大值?下一节专门审这道工序,它决定了模型的表达能力上限。