3.1 GCN:基础办案套件
3.1 GCN:基础办案套件
本节摘要:图卷积网络(GCN)把一阶切比雪夫近似固化为标准件——每层执行"对称归一化邻接矩阵乘特征矩阵乘权重矩阵",等价于按度数加权的邻域均值聚合。本节按案件背景、机制拆解、公式推导、代码实战、变体对比五段展开,给出 NumPy 手推与 PyG 实战代码,并盘点 SGC 等简化变体。
案件背景:引文网络上的半监督分类
委托来自学术数据库:论文之间的引用关系构成网络,只有少量论文带学科标签,要求给其余论文补标签。这桩案子的难点在于"标注稀缺而结构丰富"——直接训练分类器浪费了引用关系,手工设计特征又难以穷尽。GCN 的立项正是冲此而来:把卷积层直接架在引用图上,用少量标签的监督信号驱动多层邻域聚合,让"学科社区"的结构信息自动进入表示。案件的关键约束还有两条:模型必须对论文重编号不敏感,且要在中等规模的静态图上高效训练——这两条恰好框定了 GCN 的设计空间。GCN 在经典引文数据集上以极简的结构逼近甚至超越当年的专用模型,从此成为"拿到图数据先跑 GCN 基线"的行业惯例。
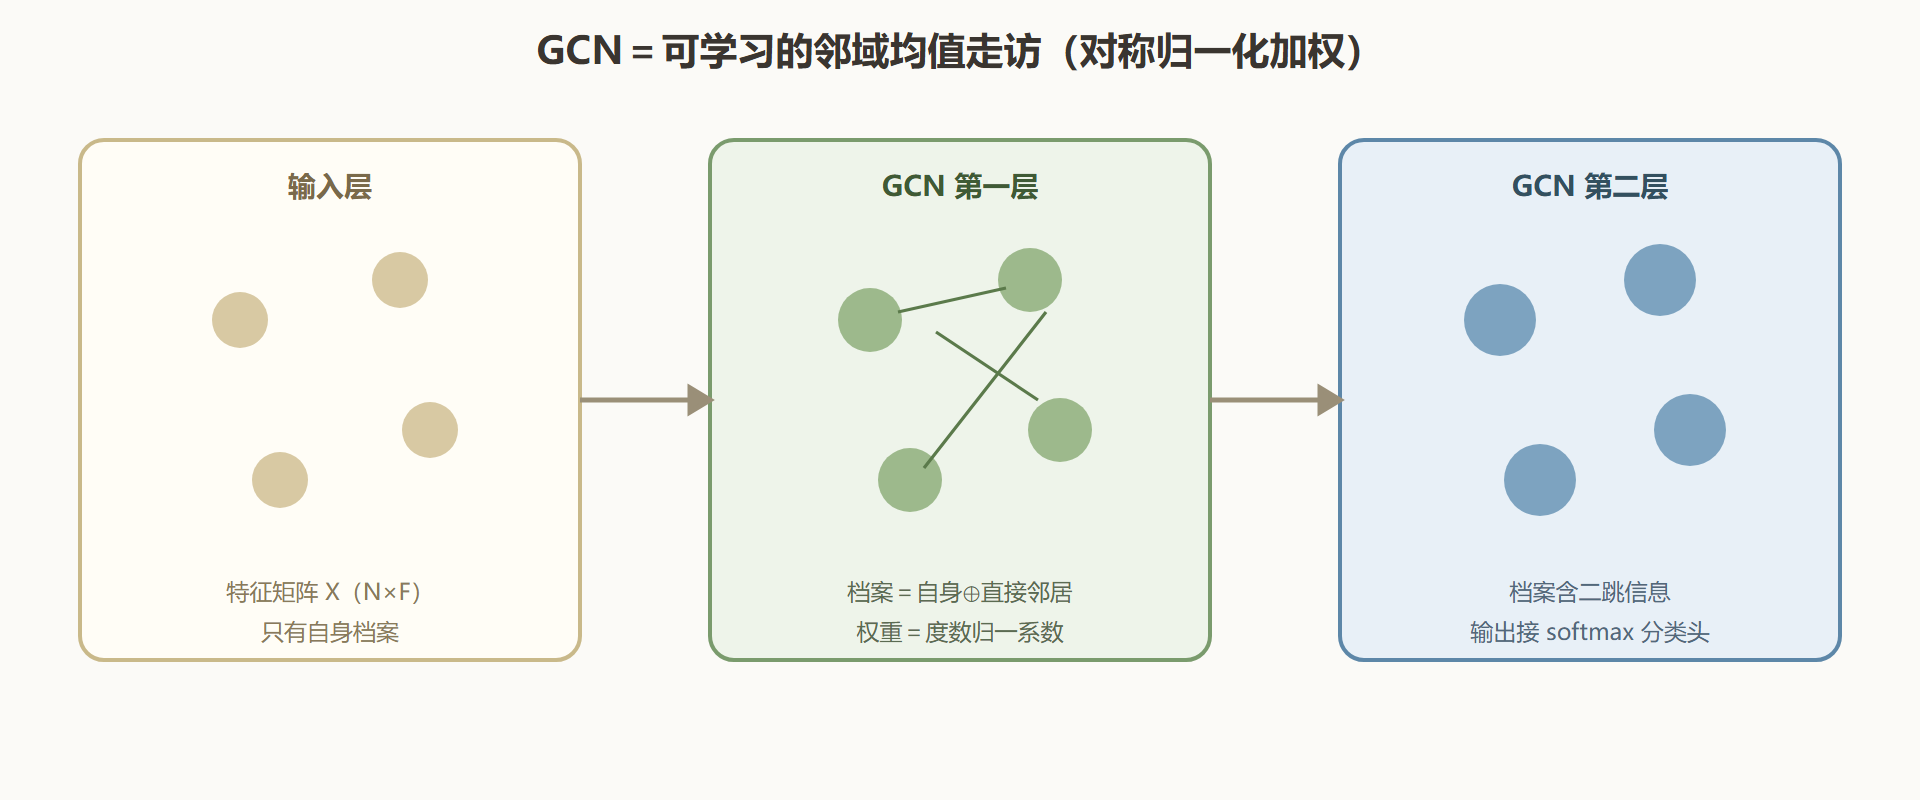
图:GCN 层叠——每层聚合一跳,层数决定感受野
机制拆解:归一化均值走访
GCN 的机制可以用一句话说尽:每层让每个节点的表示向"度数加权的邻居均值"看齐,再过一次可学习投影。拆开看有四个动作。加自环:邻接矩阵加上单位阵,节点把"自己"也列为走访对象,旧档案不至于被完全冲掉。度数求幂:算出度矩阵的二分之一次幂,左右各乘一次夹住邻接矩阵。对称归一:得到归一化邻接矩阵,任意两节点间的聚合权重由两端度数共同决定——度数高的邻居话语权被自动压低,避免了"枢纽节点淹没小节点"的失真。线性投影加激活:聚合结果乘可学习权重矩阵、过非线性。四个动作里只有权重矩阵是可学习的,其余全是确定性预处理——GCN 的参数量因此极小,小数据集也不容易过拟合。
公式推导:从一阶近似到传播式
推导的起点是第二章的一阶切比雪夫滤波器。切比雪夫网络把图卷积写成拉普拉斯多项式形式,取一阶截断(只看直接邻域)并令最大特征值尺度为固定值,传播式退化为归一化拉普拉斯相关的简单形式。GCN 论文再做了两步工程化简化:把两个本可独立学习的系数合并成单参数,再用"重归一化技巧"把自环直接加进邻接矩阵。最终每层的传播式为:新表示等于对称归一化邻接矩阵(含自环版本)乘当前表示乘权重矩阵,再过激活函数。用记号写出就是 H 上标 l 加一等于非线性作用于 Â 乘 H 上标 l 乘 W 上标 l,其中 Â 是加了自环的邻接矩阵经度矩阵负二分之一次幂左右夹乘的结果。
这条公式值得逐项读解。Â 与 H 相乘的含义是"按归一化权重汇总邻域"——第 i 行第 j 列的权重等于度数乘积平方根的倒数,分子上是连接指示。分母上两端度数都参与,体现了"话语权与自身规模和对方规模都相关"的对称衰减。乘 W 是把汇总结果投影到新空间,是唯一的可学习环节。半监督训练时,损失只计算带标签节点的交叉熵,未标注节点的表示通过层层聚合被标签信息"顺带"塑形——监督信号沿着边在图上扩散,这正是半监督设定的红利。
代码实战:NumPy 手推与 PyG 训练
先手推:不借助任何框架,把单层 GCN 前向算清楚,确认"对称归一化均值聚合"的数值行为。
import numpy as np import networkx as nx G = nx.Graph([(0,1),(0,2),(1,2),(2,3),(3,4)]) n = 5 A = nx.to_numpy_array(G, nodelist=range(n)) + np.eye(n) # 加自环 D_half = np.diag(1.0 / np.sqrt(A.sum(axis=1))) # 度矩阵负二分之一次幂 A_hat = D_half @ A @ D_half # 对称归一化邻接矩阵 print("归一化权重(每行按结构分配):\n", np.round(A_hat, 3)) rng = np.random.default_rng(5) X = rng.normal(size=(n, 4)) W = rng.normal(size=(4, 3)) * 0.5 H = np.tanh(A_hat @ X @ W) # 单层 GCN 前向 print("单层输出:\n", np.round(H, 3)) # 每个节点的输出=自身与邻居的加权均值再投影;枢纽邻居(度数大)权重自动变小 print("行和(近似守恒):", np.round(A_hat.sum(axis=1), 3))
再用 PyTorch Geometric 走完整训练:内置的空手道俱乐部数据集,两层 GCN 加 softmax,几十轮内即可把社区结构分开。
import torch import torch.nn.functional as F from torch_geometric.datasets import KarateClub from torch_geometric.nn import GCNConv dataset = KarateClub() data = dataset[0] class GCN(torch.nn.Module): def __init__(self): super().__init__() self.conv1 = GCNConv(dataset.num_features, 4) self.conv2 = GCNConv(4, dataset.num_classes) def forward(self, data): x, ei = data.x, data.edge_index return self.conv2(self.conv1(x, ei).relu(), ei) model = GCN() opt = torch.optim.Adam(model.parameters(), lr=0.1) for epoch in range(60): opt.zero_grad() out = model(data) loss = F.cross_entropy(out[data.train_mask], data.y[data.train_mask]) loss.backward(); opt.step() if epoch % 20 == 0: acc = (out.argmax(1) == data.y).float().mean() print(f"epoch {epoch:03d} loss {loss:.4f} acc {acc:.3f}") # 仅用四个带标签节点的监督,两层 GCN 即可把全部成员按社区分开
训练日志里最值得注意的是收敛速度与少标签依赖:监督信号只有个位数节点,但经过两层聚合,社区边界已经在表示空间里成形。这是半监督图学习的典型红利,也是 GCN 成为默认基线的原因。
⚠️ 常见坑:把 GCN 直接用在有向图上。归一化公式假定对称邻接,有向图应先决定"入边聚合成还是出边聚合",再按相应方向构造归一化矩阵,否则信息流向与业务语义错位。
变体对比:简化与加速
| 变体 | 改动点 | 收益 | 代价 | 适用场景 |
|---|---|---|---|---|
| SGC 简化图卷积 | 删掉层间非线性,先预乘归一化邻接幂次再训练线性分类器 | 训练快数倍,几乎无损于部分基线 | 表达力降为线性滤波 | 大规模快基线、特征已较强 |
| FastGCN | 按重要度对节点采样,把图卷积改为期望意义下的蒙特卡洛估计 | 显存可控地训练大图 | 估计方差需要调采样量 | 亿级边图 |
| DeepGCN 系 | 引入残差、正则化与深网络训练技巧 | 可叠到数十层 | 结构复杂 | 需要大感受野的特殊任务 |
| APPNP | 用 personalized PageRank 替代多层堆叠传播 | 少参数获得大感受野 | 传播不可学习 | 标签传播味浓的任务 |
GCN 的直推口径与固定权重是它的阿喀琉斯之踵:权重只由度数决定、与节点内容无关,且经典实现偏爱静态图。下一件装备正是为解决"节点不断新增"而造——抽样讯问法 GraphSAGE。