3.2 GraphSAGE:抽样讯问法
3.2 GraphSAGE:抽样讯问法
本节摘要:GraphSAGE 用"对每个目标节点抽样固定数量邻居、聚合后与自身拼接"的流程替代逐节点记忆参数,从而获得归纳能力——训练好的模型可直接推断训练时从未出现过的节点。本节按五段式展开:Pinterest 规模推荐的真实动机、采样与聚合的机制细节、拼接更新的公式、NumPy 采样模拟与 PyG 邻居加载器实战、以及重要度采样系变体对比。
案件背景:流动人口不断入场的平台
委托来自电商与内容平台:商品与用户每天都在新增,要求模型对新入场的节点立即给出推荐与风险判断。GCN 的经典用法在这类现场水土不服——它倾向于把整张图摊开做全图计算,且历史版本里节点表示在训练中逐渐固化,新节点没有"排练"机会就只能重训。GraphSAGE 的破题思路是把办案从"认人"改成"认流程":不记忆任何具体节点的向量,只学习"给定邻居集合如何归纳出表示"的聚合函数。新节点入场时,套用同样的采样与聚合流程即可当场出档案。这篇工作的原始实验在蛋白质相互作用网络与学术引用网络上验证了归纳式推断的可行性,随后被 Pinterest 改造为工业级系统,在数亿节点的图上每天服务线上推荐——"规模"与"流动"双重约束同时被解决。
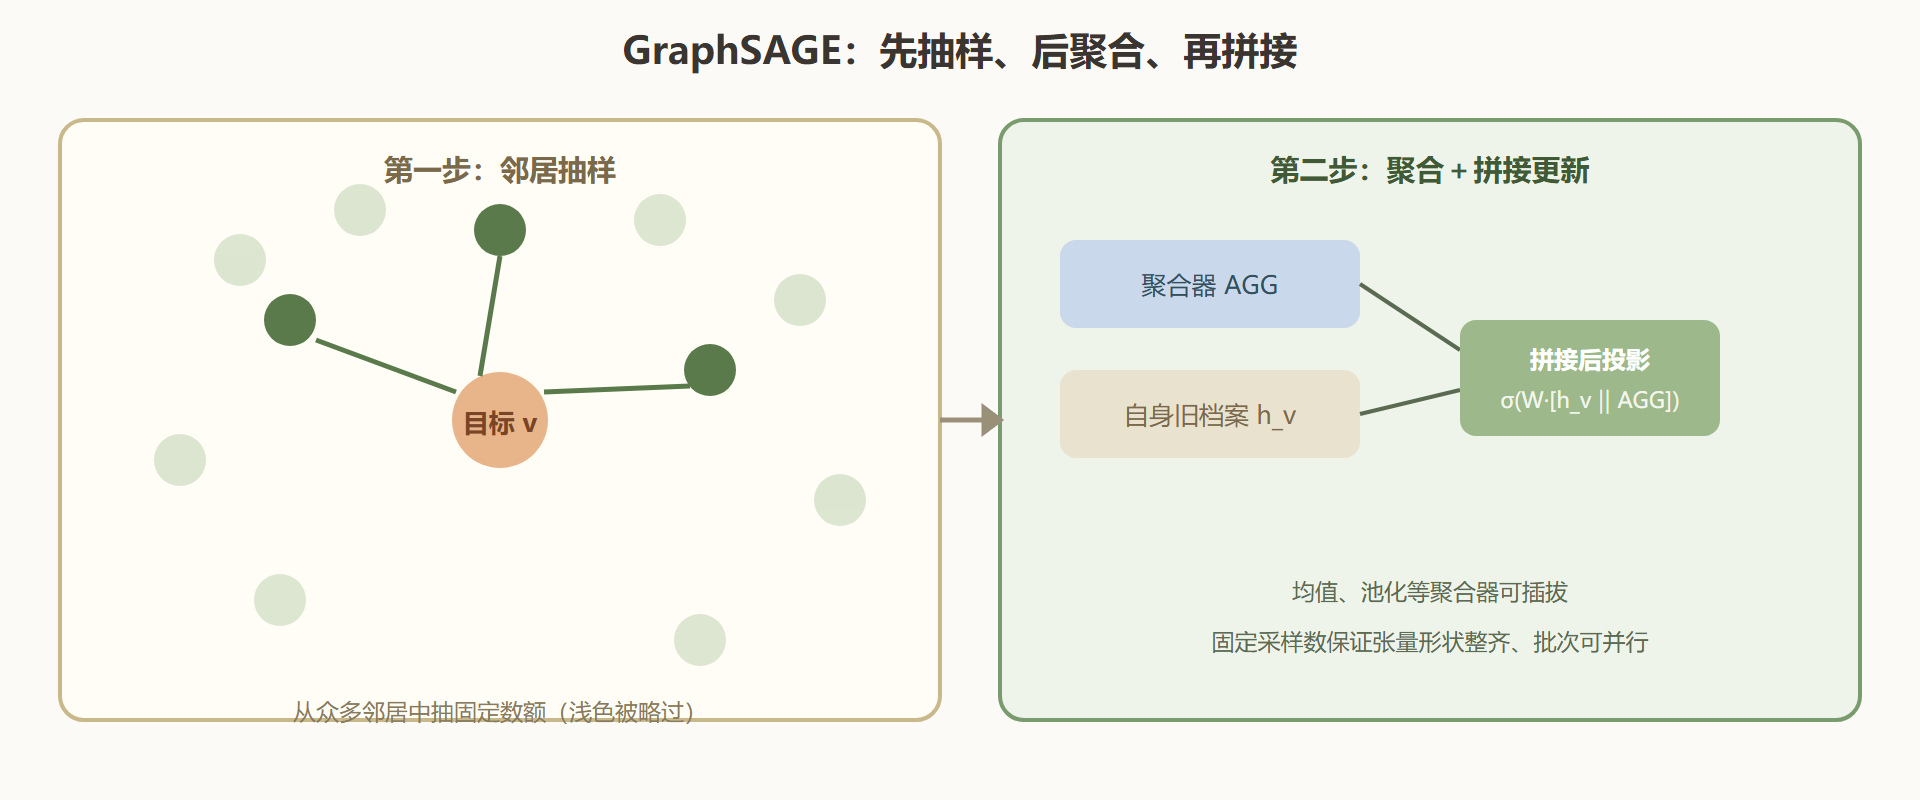
图:GraphSAGE 的采样与聚合两步
机制拆解:采样定形,聚合定质
GraphSAGE 的机制由两个可分离的模块组成。采样模块负责"定形":对每个目标节点,从邻居集合里均匀抽出固定数额的邻居;再下一层对抽出的邻居重复同样操作,形成两层"采样树"。固定数额带来工程上的巨大红利——同一批次里每个节点的计算图形状完全一致,张量化、批处理、显存估算全部变成确定性操作,这正是它能被工业系统采用的关键。采样还顺带完成了正则化:每轮训练看到的是子图,等价于对全图的结构做了随机遮蔽,抑制了对局部噪声的过拟合。聚合模块负责"定质":论文比较了均值、池化、循环单元几种聚合器——均值即对抽样邻居取平均;池化先把每条消息过共享小网络再取元素级最大值,表达力更强;循环单元按序处理邻居消息,性能与开销在多数静态图任务上不占优。聚合结果与节点自身旧表示拼接后投影,完成一次更新——拼接而非替换,保证旧档案始终有直通道,信息不被聚合结果单方面覆盖。
公式推导:从采样树到归纳保证
单层更新可以写成紧凑形式:节点 v 的新表示等于非线性作用于权重矩阵乘以"自身旧表示与邻居聚合结果的拼接",其中邻居聚合是对抽样邻域内每个邻居 u 的表示经聚合函数的汇总。两层堆叠时,第一层以原始特征为输入产出中间表示,第二层以中间表示为输入产出最终表示;反向传播沿采样树回传,只更新被抽到的路径上的参数。
归纳保证来自参数与节点的解耦:训练目标是聚合函数的参数,它们从不绑定具体节点编号。因此推断阶段遇到全新节点时,只要它带着特征与邻居边,就能按同样流程计算表示——模型输出的是"流程的执行结果"而非"记忆的查询结果"。代价也有:均匀抽样在邻居分布极度倾斜时会漏掉关键邻居(枢纽节点被抽到的概率虽高,但小众重要邻居可能长期缺席),这正是后续重要度采样变体的改进切入点。
代码实战:采样过程模拟与邻居加载器
先用纯 Python 模拟采样树的生成,看清"固定数额"如何让不同规模的节点获得形状一致的计算图。
import numpy as np rng = np.random.default_rng(21) adj = { "v": ["a", "b", "c", "d", "e", "f"], # 目标节点 v 的邻居 "a": ["g", "h", "i"], "b": ["j"], "c": ["k", "l", "m", "n", "o"], "d": ["p"], "e": [], "f": ["q", "r"], } def sample_neighbors(node, k): nbrs = adj.get(node, []) if len(nbrs) <= k: return nbrs + [None] * (k - len(nbrs)) # 不足则填充,保证长度恒定 return rng.choice(nbrs, size=k, replace=False).tolist() fanouts = [3, 2] # 每层抽样数额 layer1 = sample_neighbors("v", fanouts[0]) layer2 = {u: sample_neighbors(u, fanouts[1]) for u in layer1 if u} print("第一层抽样:", layer1) print("第二层抽样:", layer2) # v 实际有六位邻居,只抽三位;每位再抽至多两位——计算图规模被钉死, # 无论原始度数多大,反向传播的代价都有上界
再用 PyG 的邻居加载器走一遍小批次训练的骨架,它是 GraphSAGE 思想在框架层的标准实现。
import torch from torch_geometric.datasets import Planetoid from torch_geometric.loader import NeighborLoader from torch_geometric.nn import SAGEConv import torch.nn.functional as F data = Planetoid(root="/tmp/Cora", name="Cora")[0] loader = NeighborLoader(data, num_neighbors=[10, 10], batch_size=64, shuffle=True, input_nodes=data.train_mask) class SAGE(torch.nn.Module): def __init__(self): super().__init__() self.c1 = SAGEConv(data.num_features, 32) self.c2 = SAGEConv(32, data.num_classes if hasattr(data, "num_classes") else 7) def forward(self, x, ei): return self.c2(self.c1(x, ei).relu(), ei) model, opt = SAGE(), torch.optim.Adam(model.parameters(), lr=0.01) for batch in loader: # 每个批次只含抽样子图 opt.zero_grad() out = model(batch.x, batch.edge_index) mask = batch.train_mask loss = F.cross_entropy(out[mask], batch.y[mask]) loss.backward(); opt.step() print("小批次训练完成:每个批次的计算图规模恒定,显存不随全图增长")
变体对比:采样策略的进化
| 变体 | 采样策略 | 相对 GraphSAGE 的改进 | 典型场景 |
|---|---|---|---|
| PinSage | 重要度采样:按随机游走命中频次挑邻居 | 抽到高价值邻居的概率大幅提高 | 工业推荐,邻居上百万 |
| GraphSAINT | 子图级采样:先抽子图再在子图上做完整卷积 | 消除层间采样偏差,训练更稳 | 大图节点分类 |
| Cluster-GCN | 图分区采样:把图切成簇,逐簇训练 | 批内结构完整、显存效率高 | 超大图深度训练 |
| FastGCN | 节点重要性采样(期望近似) | 理论上无偏 | 分析友好场景 |
抽样讯问法解决了"流动"问题,但它的聚合权重对抽样邻居一视同仁(或仅按池化隐式加权)。下一件装备把"权重"本身变成学习对象——重点盯防术 GAT。