3.3 GAT:重点盯防术
3.3 GAT:重点盯防术
本节摘要:图注意力网络(GAT)把聚合权重从"由度数决定的固定系数"升级为"由节点内容决定的动态注意力"——每条边的重要性经共享打分函数计算、邻域内 softmax 归一,多头并行增强稳定性。本节按五段式展开:注意力入图的动机、打分归一加权三步机制、系数公式推导、NumPy 注意力手推与 PyG 实战、GATv2 等变体对比。
案件背景:不是每个邻居都同样可信
反洗钱团队的委托里有一条尖锐的备注:嫌疑人有几十个关联账户,其中绝大多数是日常缴费、发工资的正常往来,真正可疑的往往只是少数几条异常通道——而 GCN 对这些邻居的聚合权重只由度数决定,谁来都是同一套归一化系数,"关键证人"与"路人甲"话语权几乎没差别。这桩案子把需求推向"权重应当随内容变化":同样两账号相邻,在欺诈上下文里权重应偏向异常一方,在正常上下文里权重可以均衡。GAT 的答案是把 Transformer 的注意力机制移植到图上:让目标节点对每个邻居打分,分数经归一化后作为聚合权重——盯防谁、盯多紧,由证据内容实时决定。原始论文在引文网络与蛋白质相互作用图上验证了增益,注意力权重还附带了"哪些边在起作用"的可解释线索,这对需要给出研判理由的风控、医疗场景是额外红利。
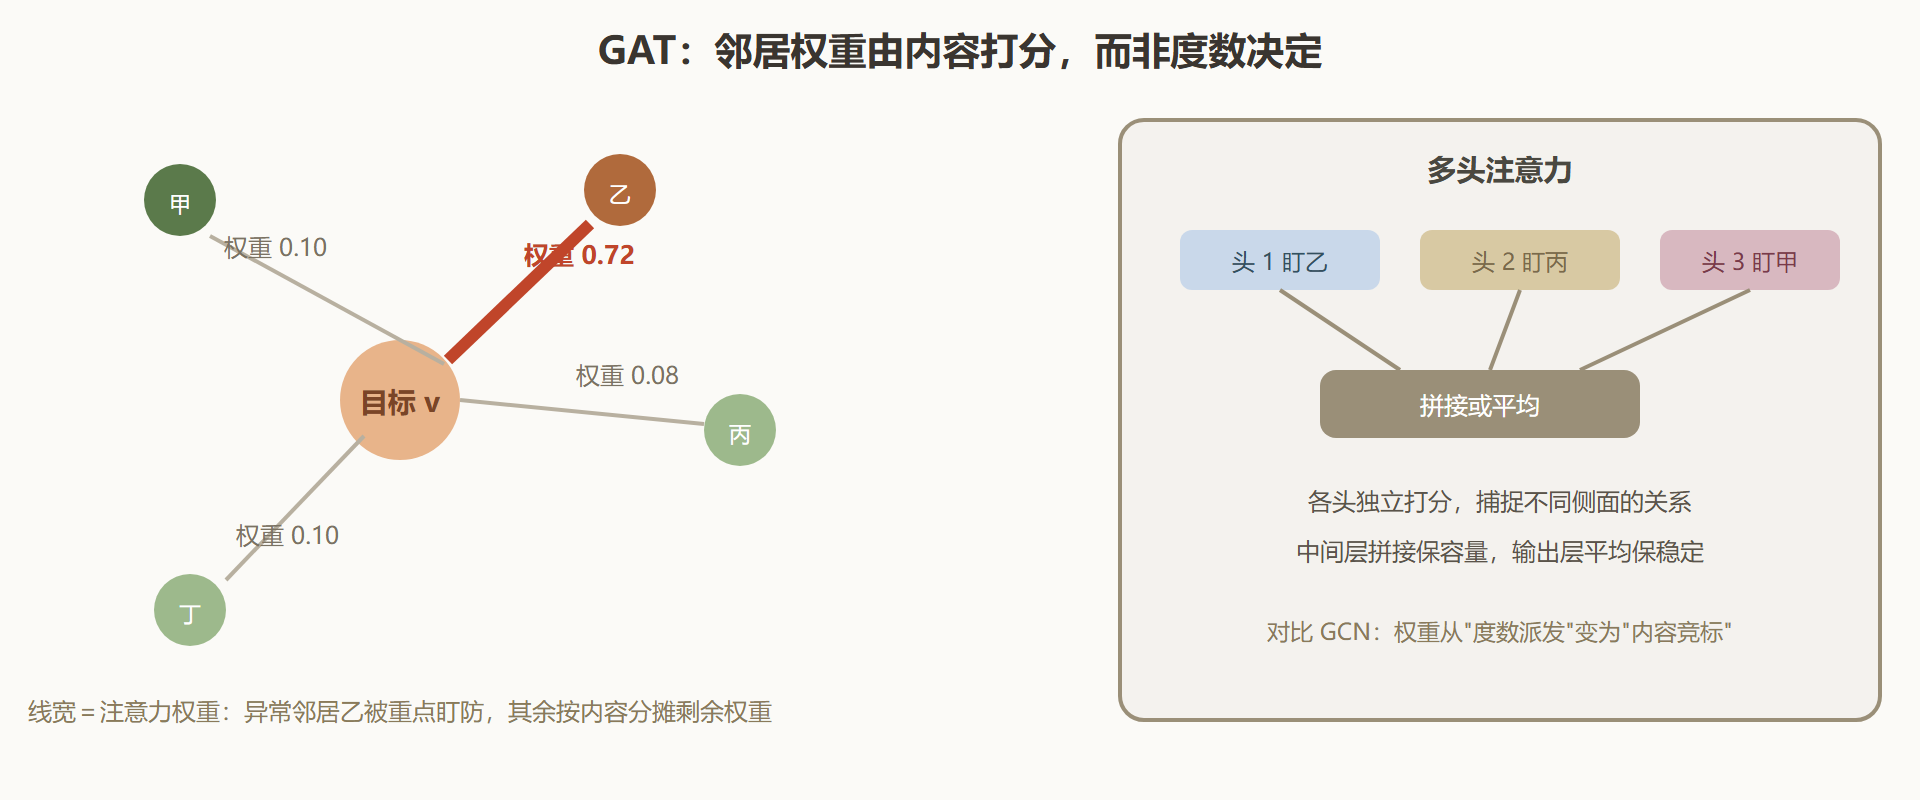
图:GAT 的邻域注意力分配
机制拆解:打分、归一、加权
GAT 的单层分三步。打分:每条边先让两端节点的表示经共享线性层变换,拼接后送入单层前馈(带泄漏整流激活)得到原始分数——分数只依赖两端内容,与图的其它部分无关,因此可以逐边独立计算。归一:对每个目标节点,把它所有入边的原始分数做 softmax,压成总和为一的注意力分布——权重是相对的、在邻域内竞争产生。加权:以注意力为系数对邻居消息加权求和,得到聚合结果。多头机制在此基础上并行运行若干组独立的打分与聚合:中间层把各头输出拼接(扩大表示容量),输出层取平均(稳定收尾)。与 GCN 对照最清楚:GCN 的权重由度数在训练前就固定,GAT 的权重由内容在每次前向时动态计算——同一条边在不同样本、不同训练阶段可以有不同的盯防强度。
公式推导:从原始分到注意力系数
设节点 v 与邻居 u 的第 k 头变换为各自表示乘该头权重矩阵。原始分数记作 e,等于把两端的变换结果拼接后与注意力向量 a 做内积再过泄漏整流。正式系数 α 是 e 在 v 的邻域内做 softmax 的结果。多头版本把上述流程重复 K 次后拼接。推导上有几处值得指出的细节。其一,softmax 保证权重非负且和为一,聚合输出量级与邻居数解耦,天然带了一层"注意力版归一化"。其二,打分函数是"拼接后内积"的特定形式,计算上可拆解为两端各自与 a 的前半段、后半段相乘再相加,实现时能高效批量化。其三,注意力对边特征并不天然敏感——原始 GAT 的边权只由两端节点内容决定,若要让"关系本身的属性"参与打分,需要显式改造(后续关系感知变体的方向)。其四,理论研究表明原始 GAT 的打分方式存在"静态注意力"局限——打分面在训练后趋于固定排序,GATv2 通过调整变换与非线性顺序修复了这一点。
代码实战:手推注意力与框架调用
先用 NumPy 把单头注意力的前向完整走一遍,看清"打分、归一、加权"的数值过程。
import numpy as np rng = np.random.default_rng(33) d = 4 h_v = rng.normal(size=d) # 目标节点表示 h_n = rng.normal(size=(3, d)) # 三位邻居的表示 W = rng.normal(size=(d, 4)) * 0.5 # 共享变换 a = rng.normal(size=8) * 0.5 # 注意力向量(拼接后维度翻倍) z_v = h_v @ W # 目标节点变换 z_n = h_n @ W # 邻居变换 pairs = np.hstack([np.tile(z_v, (3, 1)), z_n]) # [z_v ‖ z_u] e = np.maximum(pairs @ a, 0.2 * (pairs @ a)) # 泄漏整流:负区间保留斜率 def softmax(z): z = z - z.max(); ex = np.exp(z) return ex / ex.sum() alpha = softmax(e) # 邻域内归一化 → 注意力系数 print("原始分 e:", np.round(e, 3)) print("注意力 α:", np.round(alpha, 3), "(和为", round(alpha.sum(), 4), ")") h_new = np.tanh(alpha @ z_n) # 加权聚合 print("加权聚合结果:", np.round(h_new, 3)) # 换一批邻居内容,α 立即改变——权重随证据动态变化,这是与 GCN 的本质差异
再用 PyG 在空手道俱乐部上跑两层 GAT,多头设为四。
import torch import torch.nn.functional as F from torch_geometric.datasets import KarateClub from torch_geometric.nn import GATConv data = KarateClub()[0] num_features, num_classes = data.num_features, int(data.y.max()) + 1 class GAT(torch.nn.Module): def __init__(self): super().__init__() self.g1 = GATConv(num_features, 8, heads=4) self.g2 = GATConv(8 * 4, num_classes, heads=1) def forward(self, data): x, ei = data.x, data.edge_index x = self.g1(x, ei).relu() # 中间层四头拼接:4×8=32 维 return self.g2(x, ei) # 输出层单头平均 model = GAT() opt = torch.optim.Adam(model.parameters(), lr=0.01) for epoch in range(80): opt.zero_grad() out = model(data) loss = F.cross_entropy(out[data.train_mask], data.y[data.train_mask]) loss.backward(); opt.step() acc = (out.argmax(1) == data.y).float().mean() print(f"训练完成 acc={acc:.3f},注意力层:", len([m for m in model.modules() if isinstance(m, GATConv)])) # 可视化提示:GATConv(return_attention_weights=True) 可取回边级权重, # 风控场景常用来绘"盯防热力图",回答"模型为什么把该账号判为可疑"
变体对比:注意力机制的修正与扩展
| 变体 | 关键改动 | 解决的问题 | 适用场景 |
|---|---|---|---|
| GATv2 | 变换与非线性重排(先拼接过非线性再打分) | 原版打分面退化为静态排序 | 需要真动态权重的任务 |
| 关系感知 GAT | 边特征进入打分函数 | 原版对边属性不敏感 | 异构关系、带类型边 |
| 稀疏注意力实现 | 只在存在的边上计算打分 | 全邻接矩阵版的显存爆炸 | 中大规模图 |
| 多头策略变体 | 中间层平均、输出层拼接等组合调整 | 容量与稳定的权衡 | 表示维度敏感的任务 |
重点盯防术补上了"权重动态化",但它与 GCN、GraphSAGE 仍各说各话——每篇论文都有自己的符号体系。下一节把三件装备收进同一册规程:MPNN 统一框架。