4.2 边级结案:关系线索预测
4.2 边级结案:关系线索预测
本节摘要:链接预测判断"某条边是否(将)存在",评分函数把两端节点表示映射为分数(点积、哈达玛积、神经网络打分),训练依赖负采样制造反例。本节展开评分函数选型、负采样策略、评测指标与边泄漏防范,配套推荐场景的完整小实验;边分类(判断既有边的类型)作为姊妹任务一并归档。
推荐工单的本质
打开电商的"猜你喜欢",后台其实在解一道边级题:用户与商品构成二部图,历史点击购买已连成边,"推荐"就是给尚未连边的用户-商品对打分,取分数最高者呈现。链接预测的本质是给节点对打分排序——分数从哪来?从两端节点的表示来。上一节给节点定性,本节把粒度切到"关系":预测边是否存在(链接预测)、判断已存在的边属于什么类型(边分类)、预测边的权重(边回归),共享同一套"表示加打分"的骨架。侦探社的对应业务是"团伙关系补全":已知部分关联,推断还有哪些暗线。
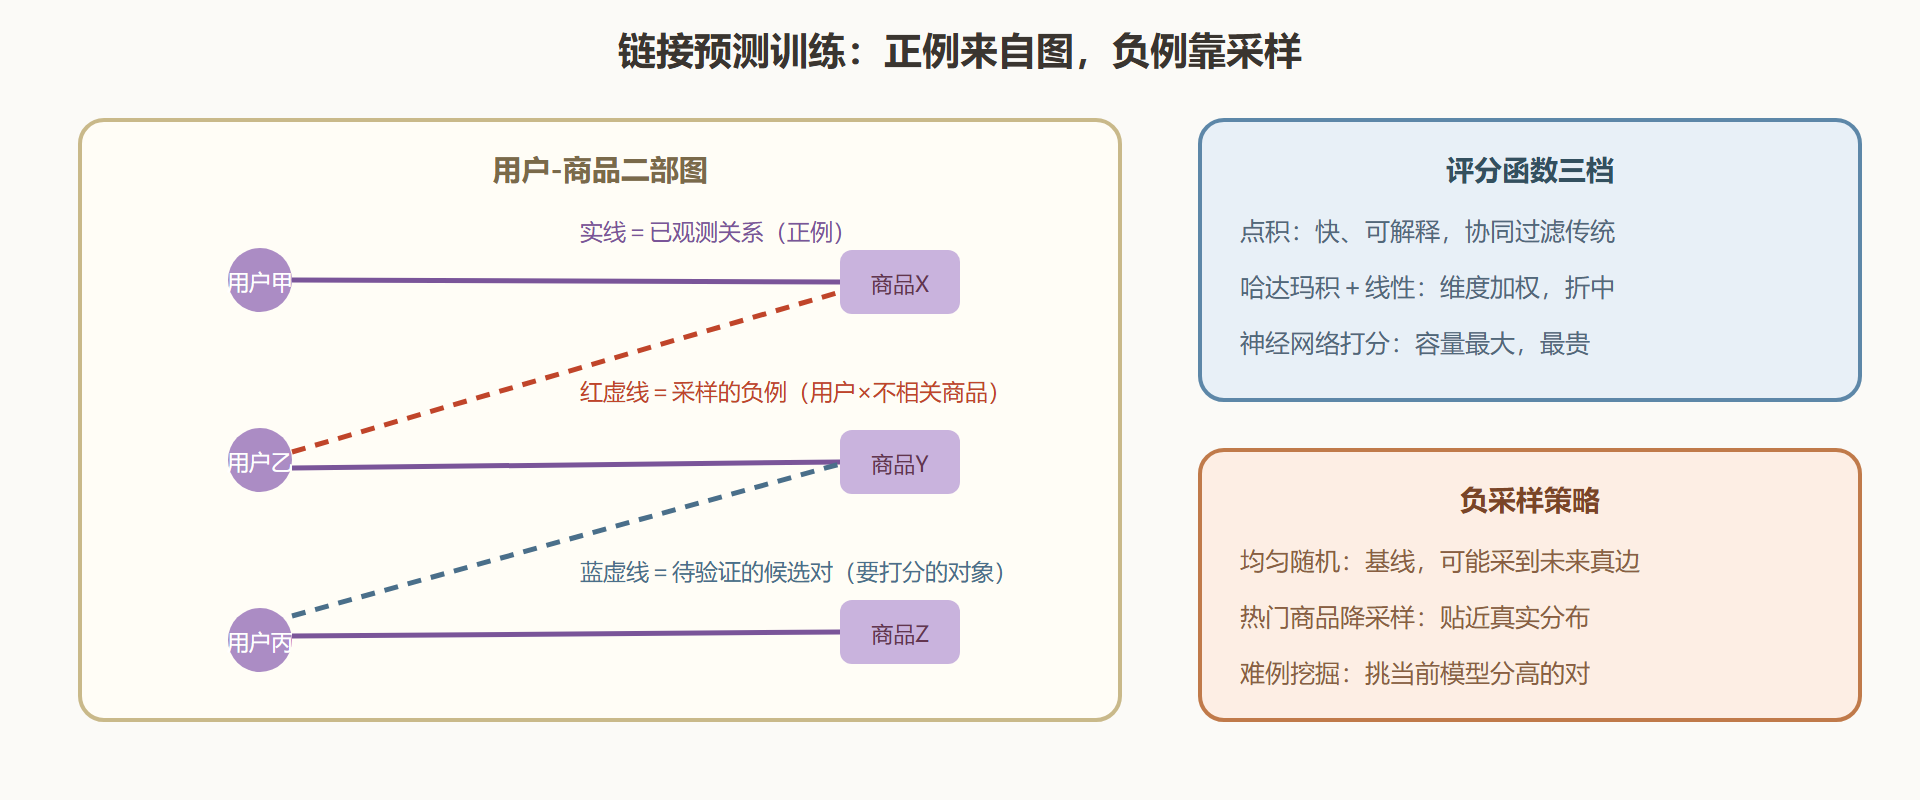
图:负采样——给链接预测制造反例
评分函数与训练流程
链接预测的训练数据由正例与负例构成:正例就是图里已存在的边;负例不存在,需要从"尚未连边的节点对"里采样。训练目标是拉开正负对的分数差距——损失可用二分类交叉熵,也可用贝叶斯个性化排序式的成对损失(只要求正例分数高于负例)。评分函数有三档。点积直接把两端嵌入做内积,几何含义是"方向越一致分数越高",快且可解释,是矩阵分解时代的直系遗产;嵌入学得好时,点积已经足够强。哈达玛积加线性层把两端的各维度逐一相乘再加权求和,允许"某些维度重要、某些维度无关",比点积多一层灵活性。神经网络打分把两端表示拼接后喂入多层感知机,容量最大也最贵,适合关系模式复杂的场景(有向图、异构图)。
⚠️ 头号翻车点是边泄漏:评测用的测试边如果在训练阶段参与了消息传递,模型等于提前看过答案——分数再高也只是记忆。正确姿势是训练时把测试边从图中抽掉,评测阶段才放回来打分。
评测指标与协议
链接预测的指标与排序任务对齐。精确率与召回率按阈值切分;曲线下面积衡量打分的整体排序力;命中率与逆排序(推荐系统的常用组合)考察"真实交互能否排进前列"。协议方面要锁定三条:负采样协议(采多少、怎么采、各方法是否同口径)、划分协议(随机切边还是按时间切,按时间切更贴近线上)、重复次数(随机划分方差大,需多次取均值)。同一个模型在不同协议下的指标差距可以大到没有可比性——读论文先读协议,是链接预测领域的生存法则。
代码实战:小推荐图的完整流程
用一个小型用户-商品图走完整流程:划分正负例、训练、评估。
import torch import torch.nn.functional as F from torch_geometric.data import Data from torch_geometric.utils import negative_sampling from torch_geometric.nn import SAGEConv torch.manual_seed(0) # 用户 0~5,商品 6~11 的二部图 pos_edges = torch.tensor([ [0,6],[1,6],[2,7],[3,7],[4,8],[5,8], [0,9],[1,9],[3,10],[4,10],[2,11],[5,11]], dtype=torch.long) edge_index = torch.cat([pos_edges, pos_edges.flip(0)], dim=1) # 无向化 x = torch.eye(12) data = Data(x=x, edge_index=edge_index) class Encoder(torch.nn.Module): def __init__(self): super().__init__() self.c1 = SAGEConv(12, 16); self.c2 = SAGEConv(16, 8) def forward(self, x, ei): return self.c2(self.c1(x, ei).relu(), ei) enc, opt = Encoder(), None def train(): global opt opt = torch.optim.Adam(enc.parameters(), lr=0.01) # 负采样:与正例数量相同的"用户-商品"不相连对 neg = negative_sampling(data.edge_index, num_nodes=12, num_neg_samples=pos_edges.size(0)) pos_scores = (enc(data.x, data.edge_index)[pos_edges[:,0]] * enc(data.x, data.edge_index)[pos_edges[:,1]]).sum(-1) neg_scores = (enc(data.x, data.edge_index)[neg[:,0]] * enc(data.x, data.edge_index)[neg[:,1]]).sum(-1) labels = torch.cat([torch.ones(pos_scores.size(0)), torch.zeros(neg_scores.size(0))]) scores = torch.cat([pos_scores, neg_scores]) loss = F.binary_cross_entropy_with_logits(scores, labels) opt.zero_grad(); loss.backward(); opt.step() return loss.item() for ep in range(120): loss = train() print("末轮损失:", round(loss, 4)) # 正例分数被推高、负例压低
评估阶段示范"候选打分"的正确姿势——训练后对指定用户枚举未交互商品并排序。
# 为用户 0 推荐商品:对未交互的商品打分排序 enc.eval() with torch.no_grad(): h = enc(data.x, data.edge_index) user = 0 seen = set(pos_edges[pos_edges[:,0] == user][:,1].tolist()) candidates = [g for g in range(6, 12) if g not in seen] scores = {g: (h[user] * h[g]).sum().item() for g in candidates} ranked = sorted(scores.items(), key=lambda kv: -kv[1]) print("用户已交互:", sorted(seen), " 推荐排序:", ranked) # 打分用同构信息(共现结构)而非内容画像——这正是协同过滤的图形态
姊妹任务:边分类与边回归
边分类判断已存在边的类型——通讯记录里区分"同事、家人、推销",知识图谱里判断关系谓词。做法与链接预测同构:把两端节点表示(必要时加边特征)喂入分类头。边回归预测边的数值,比如路段的通行时间、好友间的互动强度。三者的统一视角:边的属性由两端的"相遇"决定——相遇的方式可以是拼接、逐元素相乘或注意力交互,选哪种取决于关系的复杂度。
本节要点
- 任务本质:给节点对打分排序,推荐与团伙补全是同构问题。
- 评分三档:点积快而可解释,哈达玛积折中,神经网络打分容量最大。
- 负采样造反例:均匀、热门降采样、难例挖掘三档,口径必须一致。
- 边泄漏是头号坑:测试边不得参与训练期消息传递,协议决定指标可信度。
- 三姊妹一体:链接预测、边分类、边回归共享"表示加打分"骨架。
节点与边的粒度都覆盖后,下一节升到最高粒度:把整张图压成一个结论——图分类、图回归与图生成的前哨站。