4.3 图级结案:整案定性
4.3 图级结案:整案定性
本节摘要:图级任务输出整张图的结论——分类(分子有无致变性)、回归(溶解度数值)、生成(按需求造新图)。本节聚焦读出与池化的工程细节、多图批处理的索引机制、图分类完整训练循环,以及按分布划分数据集这一图级任务特有的评测纪律;图生成作为预告留给第六章。
药物筛选流水线
制药公司的筛选流水线把图级任务用到了极致:候选分子以十万计,每个分子是一张小图(原子为节点、键为边),实验测定"是否致变""溶解度多少"昂贵且缓慢。图分类与图回归的价值在于用已测分子的知识给未测分子做虚拟筛选,把实验资源集中到模型看好的子集。前两节分别处理了节点与边的粒度,本节把粒度升到顶:整张图作为一个样本。技术上唯一的新部件是"读出"(把任意数量的节点表示压成一个固定长度向量),其余——消息传递、训练循环、损失函数——与节点级任务完全同构。这个"只换读出不换骨架"的事实再次印证本册的主线判断:图神经网络的通用性来自表示底座的统一。
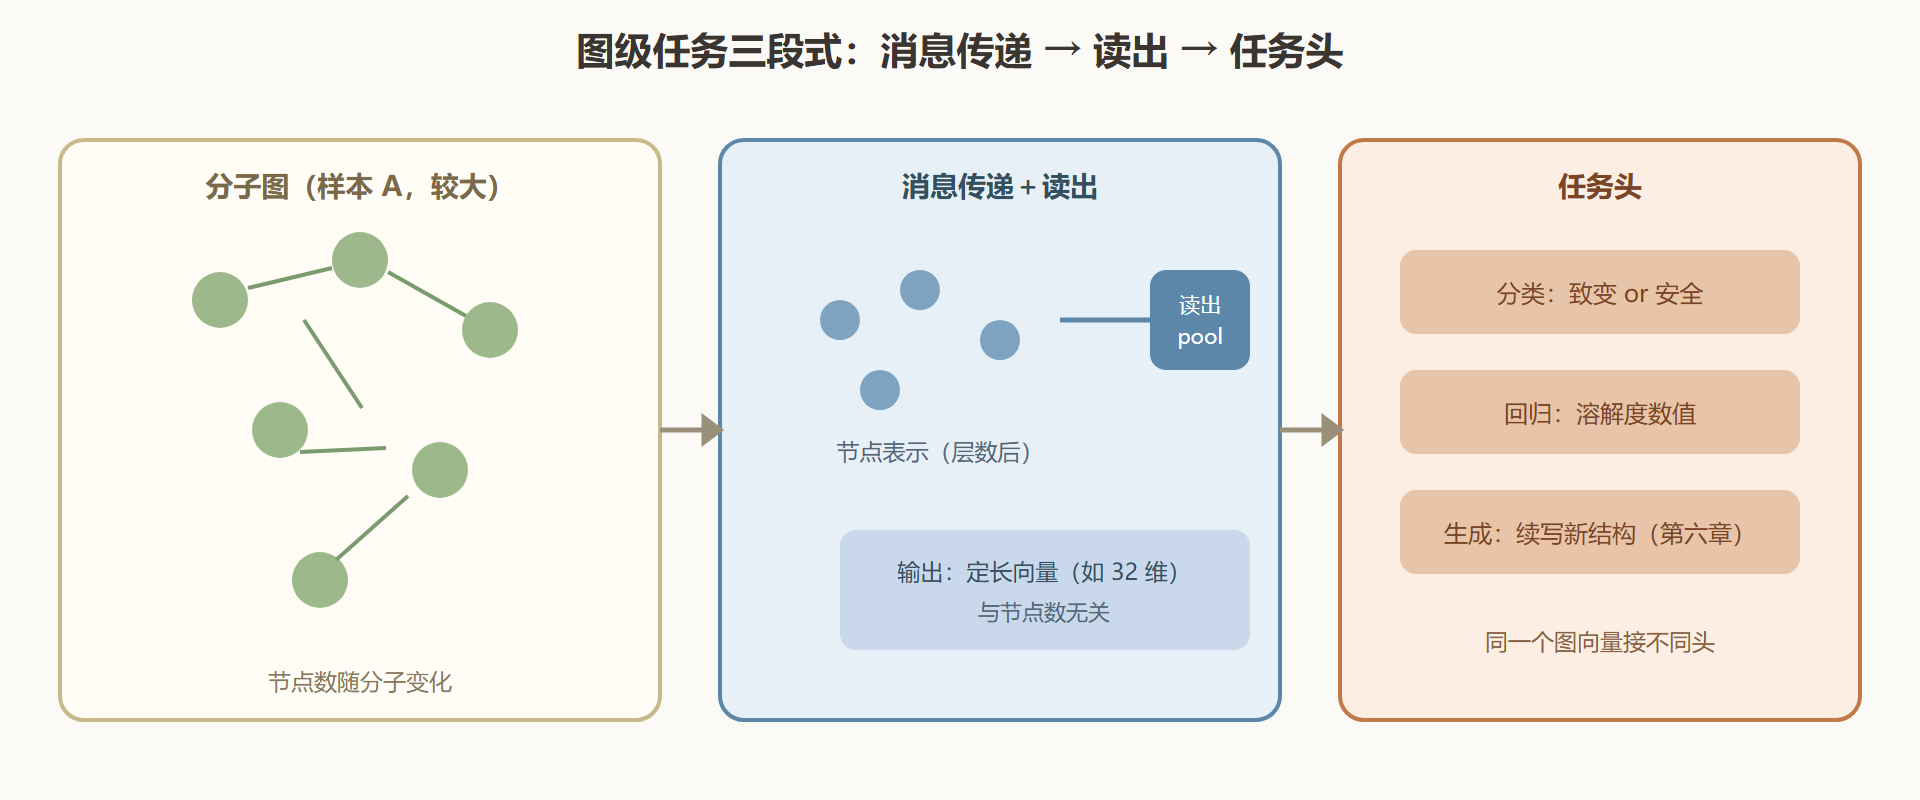
图:读出——从任意规模的节点集合到定长图向量
读出的工程细节
读出方案在第二章末已列过选项表,这里补上工程视角的三条细节。其一,读出与聚合的选型逻辑同源:求和保留"有几个什么"(分子计数敏感),均值平滑规模差异(会话长度无关的语义摘要),注意力池化让模型挑选代表节点,层次池化逐级压缩。其二,读出前做一次投影再读出常比直接读出更稳——先把节点表示过一层线性加激活,压缩掉任务无关成分,再汇总。其三,拼接多层读出是廉价增强:把每层的节点表示分别读出后拼接,让任务头同时看到浅层局部与深层全局信息,这就是跳跃知识机制在读出端的应用。
多图批处理:向量的接力
图级训练的核心工程技巧是把多张图拼进一个批次。做法是节点索引接力:第一张图有若干节点,第二张图的节点索引直接续接编号,同时一张批次向量记录每个节点属于哪张图。消息传递按边索引照常进行(不同图的节点之间没有边,互不干扰),读出函数按批次向量分组池化。于是不同大小的图可以共享一个规则的长方形批次张量,显卡利用率与训练吞吐都大幅提升。理解这套机制的检验方式很简单:给定批次向量,能手算出"哪些节点会被池化到同一个图向量里"。
import torch from torch_geometric.data import Data, Batch g1 = Data(x=torch.randn(4, 8), edge_index=torch.tensor([[0,1,2,3],[1,2,3,0]])) g2 = Data(x=torch.randn(3, 8), edge_index=torch.tensor([[0,1,2],[1,2,0]])) batch = Batch.from_data_list([g1, g2]) # 拼批 print("拼批后节点总数:", batch.num_nodes) # 4+3=7 print("批次向量:", batch.batch.tolist()) # [0,0,0,0,1,1,1] 各节点归属 print("边索引(接力后):\n", batch.edge_index) # g2 的边整体平移了四个编号——两图的节点在拼接后依然互不相连 from torch_geometric.nn import global_mean_pool h = torch.randn(7, 8) print("按图池化输出形状:", global_mean_pool(h, batch.batch).shape) # 2 × 8
完整训练循环:分子图分类
以经典分子数据集为例跑通图分类的完整循环——这次用数据加载器的批次接口,而非单图。
import torch import torch.nn.functional as F from torch_geometric.datasets import TUDataset from torch_geometric.loader import DataLoader from torch_geometric.nn import GCNConv, global_add_pool dataset = TUDataset(root="/tmp/MUTAG", name="MUTAG") dataset = dataset.shuffle() split = int(len(dataset) * 0.8) train_ds, test_ds = dataset[:split], dataset[split:] train_ld = DataLoader(train_ds, batch_size=32, shuffle=True) class GNet(torch.nn.Module): def __init__(self): super().__init__() self.c1 = GCNConv(dataset.num_features, 32) self.c2 = GCNConv(32, 32) self.head = torch.nn.Linear(32, dataset.num_classes) def forward(self, b): h = self.c1(b.x, b.edge_index).relu() h = self.c2(h, b.edge_index) return self.head(global_add_pool(h, b.batch)) # 求和读出 model, opt = GNet(), torch.optim.Adam(model.parameters(), lr=0.01) for epoch in range(60): for b in train_ld: opt.zero_grad() loss = F.cross_entropy(model(b), b.y) loss.backward(); opt.step() test_ld = DataLoader(test_ds, batch_size=64) correct = total = 0 model.eval() for b in test_ld: pred = model(b).argmax(1) correct += (pred == b.y).sum().item(); total += b.y.numel() print(f"测试精度: {correct/total:.4f}(按分布划分,小数据集波动大,多次重复才稳)")
评测纪律:按分布划分
图级任务有个容易忽略的评测陷阱:随机划分时,高度相似的图会同时出现在训练集与测试集——分子库里大量结构近似的同系物,模型只需"认家族"就能得高分,指标虚高。更严格的协议是按分布划分:先把图聚类成结构家族,再按家族切开,保证测试集与训练集存在分布差异。两种协议的指标差距在真实研发里可能高达数十个百分点,发表与采购决策前必须核对划分协议。图回归任务把分类头换成单个输出加均方误差损失即可,其余不动;回归目标(溶解度、活性数值)常呈长尾,对目标做对数变换与分位数标准化是常规预处理。
💡 图生成的预告:生成任务要求模型产出全新的图——新分子、新材料结构。主流路线是自回归逐节点逐边地"画图",或把图映射到隐空间再解码,第六章末节展开。
本节要点
- 读出是图级任务的唯一新部件:求和计数、均值平滑、注意力挑选、层次压缩,选型与聚合函数同逻辑。
- 拼批靠索引接力:节点编号续接加批次向量分组,大小不一的图共享规则张量。
- 评测按分布划分:结构近似的图必须隔开,随机划分的指标会系统性虚高。
- 三任务接同一向量:分类、回归、生成共用图表示,只换输出头。
三级结案能力齐备,最后一节走出训练场:到社交、推荐、制药、知识图谱、交通五类真实现场,看完整卷宗怎么写。