5.3 证词趋同之谜:过平滑的诊断与处方
5.3 证词趋同之谜:过平滑的诊断与处方
本节摘要:过平滑指层数加深后节点表示相互趋同、区分度坍缩的现象——每层归一化均值聚合都等价于低通滤波,反复滤波让所有节点的"证词"滑向全图平均。本节用能量视角解释成因、给出可计算的量化诊断,并整理残差、DropEdge、浅层宽化、解耦表达与传播四类处方及其代价。
案情:越努力走访,证词越像
复盘会的悬案是这样发现的:工程师给模型加层,指望"看得更远、判得更准",结果两到三层之后精度不升反降,加到七八层时所有节点的预测几乎相同——模型把每个嫌疑人都描述成了"全城平均居民"。这就是过平滑(over-smoothing):邻域聚合的本意是吸收关系证据,重复太多次后,吸收变成了同化。它与过拟合的方向恰好相反——过拟合是模型对训练数据过度敏感,过平滑是模型对输入差异过度迟钝。本节先做机制鉴定(为什么图模型独有此病),再给诊断手段(怎么量化"表示有多像"),最后开处方(四类缓解手段及其代价)。
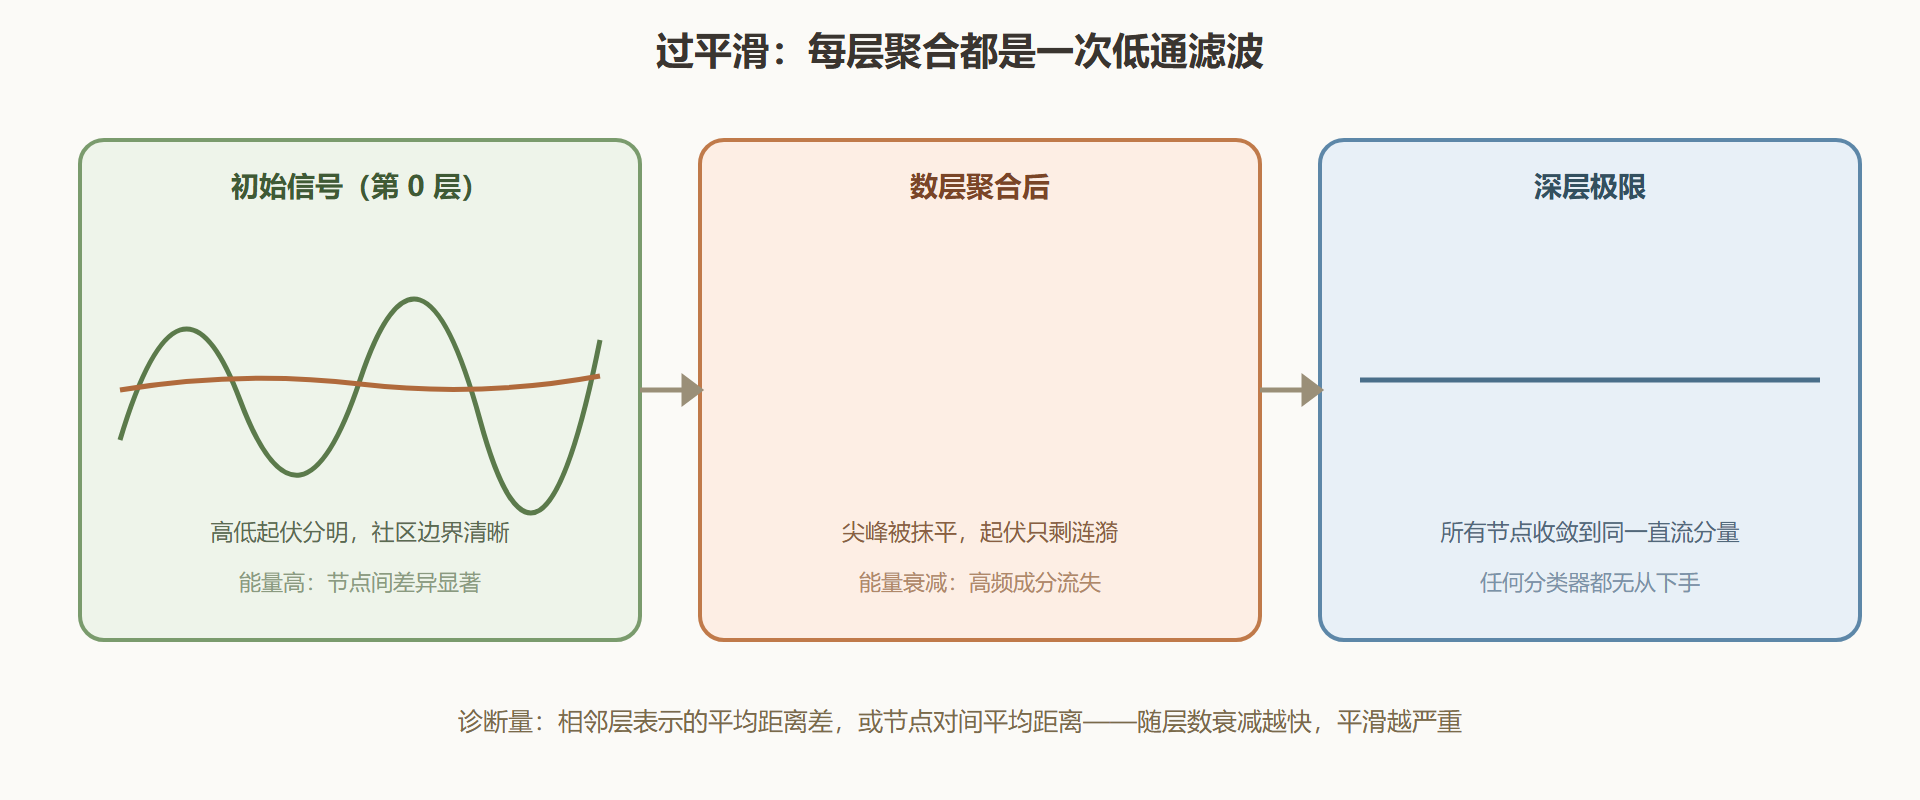
图:反复低通滤波下的表示坍缩
机制鉴定:能量为什么必然衰减
过平滑的成因可以用"能量"讲清楚。给节点表示定义一种能量:全部节点对之间的平均距离(或等价地,表示相对全局平均的方差)。观察一次归一化均值聚合对能量的影响:聚合把每个节点拉向其邻域均值,相邻节点的表示因此靠拢,节点对距离单调收缩——能量被每一层削减。第二章的谱域知识在此刻回魂:归一化均值聚合近似低通滤波器,低通滤波削的正是高频成分,而节点间差异恰恰主要存储在高频段。层数即滤波次数,反复低通之后只剩直流分量——所有表示相同。这解释了三个经验事实:图模型的两三层魔咒(滤波次数的天然上限)、异质图上更严重(相邻节点标签相反,高频信息正是任务信号,削掉即自杀)、以及残差连接为何有效(给每层保留一条"不过滤波"的直通旁路,能量不再单调衰减)。
import numpy as np import networkx as nx # 实验对象:空手道俱乐部的真实社区结构 G = nx.karate_club_graph() nodes = sorted(G.nodes()) A = nx.to_numpy_array(G, nodelist=nodes) A = A + np.eye(len(nodes)) # 加自环(GCN 习惯) D_half = np.diag(1.0 / np.sqrt(A.sum(axis=1))) A_hat = D_half @ A @ D_half # 对称归一化 # 初始信号:两个社区给不同的值(任务相关的"高频"差异) club1 = {0,1,2,3,4,5,6,7,8,10,11,12,13,16,17,19,21} x0 = np.array([-1.0 if v in club1 else 1.0 for v in nodes]) def energy(x): # 节点对平均距离(区分度代理) return np.abs(x[:, None] - x[None, :]).mean() print(f"初始能量 {energy(x0):.4f}") for layer in range(1, 11): x0 = A_hat @ x0 if layer in (1, 2, 3, 5, 8, 10): print(f"第 {layer:2d} 层后能量 {energy(x0):.4f}") # 能量逐层衰减;八九层后信号近乎平坦——两社区彻底不可区分
运行这段代码会看到能量单调下滑,直到趋近零。把"社区标签信号"换成任意节点特征,结论不变——过平滑不挑信号,只认滤波结构。
量化诊断:把"像不像"变成数字
工程上需要把过平滑变成可监控的数字,最常用的是表示的平均绝对差类指标:计算每对节点表示的距离,取平均——数值随训练轮次或层数快速下滑,即是平滑警报。实践中在每层后挂一个钩子记录该指标,与验证精度画在同一张图上:若精度下降与平滑度上升同步出现,诊断成立;若精度下降而平滑度平稳,问题在别处(过拟合、学习率、监督泄漏),别乱开药方。
# 逐层监控:在 PyG 模型里挂记录钩子 import torch class MonitoredGCN(torch.nn.Module): def __init__(self, convs): super().__init__() self.convs = torch.nn.ModuleList(convs) self.log = [] # 每层后的平滑度 def forward(self, x, ei): for conv in self.convs: x = conv(x, ei).relu() with torch.no_grad(): xm = x - x.mean(0, keepdim=True) denom = torch.clamp((xm ** 2).sum(1).sqrt().mean(), min=1e-9) self.log.append(float((xm.T @ xm).trace() ** 0.5 / denom / x.size(0))) return x # 训练后检查 model.log: # 相邻层平滑度比值持续低于阈值(如零点五)→ 平滑警报; # 深层模型的 log 曲线趋平到接近零 → 确诊过平滑
处方柜:四类缓解手段
残差与稠密连接给每层加旁路,旧表示直通最终输出,能量不再被逐层削减;初始残差的进阶版把每层输入都锚定在原始特征上,深网络的训练稳定性显著改善。DropEdge 按比例随机删边再聚合,等价于给图做结构性正则——邻域变小、滤波强度变弱,同化速度被拖慢;实现成本几乎为零。浅层宽化是朴素的躺平方案:既然两三层就到顶,不如把宽度加够——多数任务的最优解仍是浅层宽模型,别为了堆深度而堆深度。解耦表达与传播把"变换"与"聚合"拆开:先在无图状态下做足非线性变换,再单独做少量传播步,避免"每层都滤波"的复合伤害;个性化 PageRank 式传播是该思路的代表,用固定传播核替代层叠。
# 处方速写:残差 + DropEdge 的最小实现 import torch from torch_geometric.nn import GCNConv class ResidualGCN(torch.nn.Module): def __init__(self, dims): super().__init__() self.convs = torch.nn.ModuleList(GCNConv(a, b) for a, b in zip(dims, dims[1:])) def forward(self, x, ei, drop_edge=0.3): for conv in self.convs: if self.training and drop_edge > 0: # DropEdge:随机屏蔽部分边(结构性正则) mask = torch.rand(ei.size(1), device=ei.device) > drop_edge ei_use = ei[:, mask] else: ei_use = ei h = conv(x, ei_use) x = x + torch.nn.functional.relu(h) if x.shape == h.shape else torch.nn.functional.relu(h) return x # 残差要求各层维度一致(dims 同宽);维度变化处用投影对齐后再残差
鉴别诊断:别把别的病当过平滑
复盘记录里最常见的误诊有三例。权重衰减过强的症状类似(表示被拉向平均)——关掉衰减重跑即可鉴别。特征本身同质(初始特征几乎没有区分度)是数据问题,加层只会更糟,应回到特征工程。监督信号太稀(标签节点过少导致表示漂移)则应增加弱监督或自监督(第六章)。诊断顺序建议:先看初始特征区分度,再查正则强度,最后才定性过平滑——先排除环境因素,再怀疑滤波本性。
本节要点
- 成因:归一化均值聚合即低通滤波,层数即滤波次数,高频(节点差异)必然流失。
- 诊断:节点对平均距离逐层监控,精度下滑与平滑上升同步才确诊。
- 处方四档:残差留旁路、DropEdge 减弱滤波、浅层宽化顺势而为、解耦表达与传播。
- 鉴别:权重衰减过强、特征同质、监督过稀都会伪装成过平滑,先排除再用药。
顽疾有了诊疗方案,下一节把整册的工程知识装配成标准作业程序:框架选型、数据流水线、训练评估一体化的完整办案流程。