5.4 装备库与完整办案流程:PyG 实战
5.4 装备库与完整办案流程:PyG 实战
本节摘要:PyTorch Geometric 以"数据对象加消息传递基类加加载器"三件套覆盖研究与中小规模生产,DGL 在大规模分布式与多框架后端见长。本节给出从数据接入、探索、建模、训练到评估推理的完整标准流程,代码按"可直接交给同事维护"的标准组织,并附框架选型与上线注意事项。
装备库盘点
侦探社的器材室里有两排工具架。**PyTorch Geometric(PyG)**的哲学是"把图当成张量的扩展":Data 对象装特征与边索引,消息传递基类让自定义层只需填空,加载器家族(随机小批次、邻居采样、子图、聚类)对应 5.1 节的全部阵型。模型库覆盖经典与前沿,数据集仓库内置几十个常用基准,研究原型与中小规模生产都能一套代码走通。DGL 的哲学是"把图编程做成原语":以稀疏矩阵运算为核心抽象,多框架后端(PyTorch、TensorFlow、MXNet 都接),大规模分布式训练的工程成熟度高,图采样与异构图的接口设计也自成体系。选型经验:研究与快速迭代优先 PyG(代码量小、生态新),超大规模分布式或多后端环境优先 DGL;两者都在活跃演进,团队熟悉度往往比特性差异更重要。本节的完整流程以 PyG 示范,概念在两边通用。
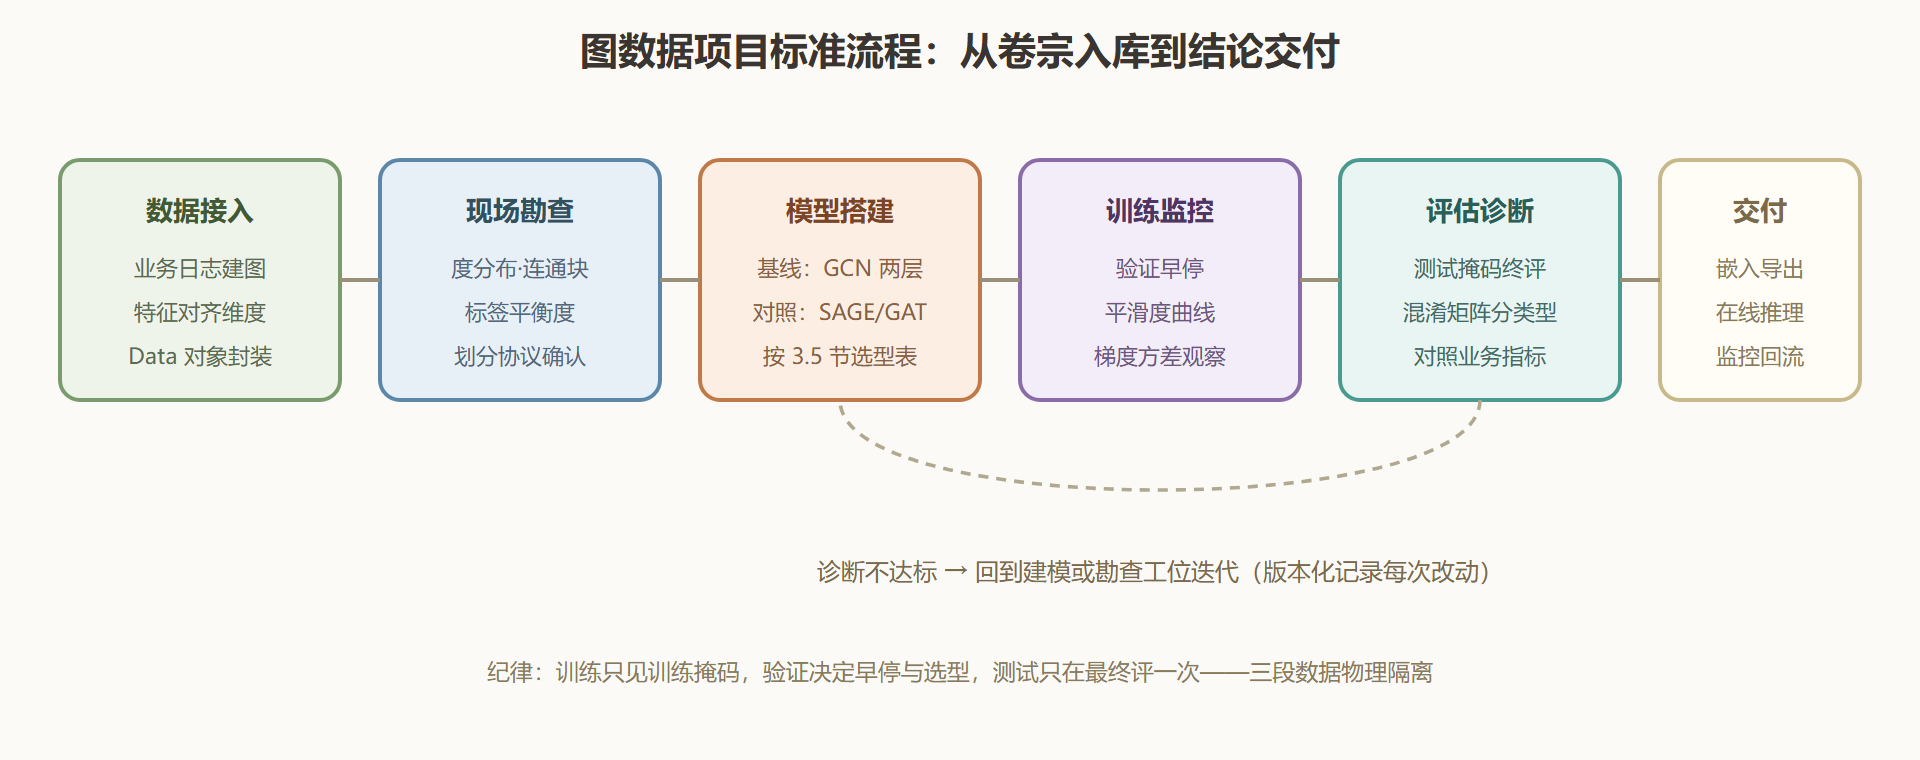
图:标准办案流程的六个工位
完整流程代码
下面是按标准流程组织的完整脚本:数据接入与勘查、基线模型、带早停的训练、终评。它综合了前几节的全部工程纪律。
"""引文图节点分类的完整办案脚本(可直接扩展到业务图)""" import torch import torch.nn.functional as F from torch_geometric.datasets import Planetoid from torch_geometric.nn import GCNConv torch.manual_seed(0) # ---- 工位一:数据接入 ---- data = Planetoid(root="/tmp/Cora", name="Cora")[0] # ---- 工位二:现场勘查 ---- from torch_geometric.utils import degree deg = degree(data.edge_index[0]) print(f"节点 {data.num_nodes}|边 {data.num_edges}|特征维 {data.num_features}") print(f"度数 中位 {deg.median():.0f} 均值 {deg.mean():.1f} 最大 {deg.max():.0f}") print(f"训练标签 {int(data.train_mask.sum())}|类别 {data.num_classes}") # 勘查结论写入实验记录:度分布重尾 → 聚合需归一化(GCN 自带);类别均衡 → 普通交叉熵即可 # ---- 工位三:模型搭建(基线先行)---- class Baseline(torch.nn.Module): def __init__(self, cin, chid, cout): super().__init__() self.c1 = GCNConv(cin, chid) self.c2 = GCNConv(chid, cout) def forward(self, x, ei): return self.c2(F.relu(self.c1(x, ei)), ei) dev = "cuda" if torch.cuda.is_available() else "cpu" model = Baseline(data.num_features, 16, data.num_classes).to(dev) data = data.to(dev) # ---- 工位四:训练与早停(验证集说了算)---- opt = torch.optim.Adam(model.parameters(), lr=0.01, weight_decay=5e-4) best_val, best_state, patience, bad = 0.0, None, 30, 0 for epoch in range(300): model.train(); opt.zero_grad() loss = F.cross_entropy(model(data.x, data.edge_index)[data.train_mask], data.y[data.train_mask]) loss.backward(); opt.step() model.eval() with torch.no_grad(): out = model(data.x, data.edge_index) val_acc = (out.argmax(1)[data.val_mask] == data.y[data.val_mask]).float().mean().item() if val_acc > best_val + 1e-4: best_val, bad = val_acc, 0 best_state = {k: v.detach().clone() for k, v in model.state_dict().items()} else: bad += 1 if bad >= patience: print(f"第 {epoch} 轮早停,最佳验证精度 {best_val:.4f}") break # ---- 工位五:终评(测试集只碰这一次)---- model.load_state_dict(best_state) model.eval() with torch.no_grad(): out = model(data.x, data.edge_index) test_acc = (out.argmax(1)[data.test_mask] == data.y[data.test_mask]).float().mean().item() print(f"测试精度 {test_acc:.4f}")
这份脚本的"可维护性"体现在三处:勘查输出的结论与模型选型之间有显式因果(注释里写明);早停保存最佳权重而不是最后一轮;测试集在训练循环里完全缺席。把这三条守住,脚本就能安全地交给下一个人。
推理与交付
训练完成后,交付形态通常是"嵌入导出"或"在线服务"两类。嵌入导出把节点表示存成向量文件,下游的检索、聚类、风控规则直接消费向量,图模型退到离线批处理——最简单也最常见。在线服务则要求模型对新节点即时响应:归纳式模型加邻域收集器,请求到达时抓取目标节点的多跳邻子图、现场前向。上线注意三条:邻域收集要设超时与兜底(新节点可能还没有邻居,退化为纯属性打分);监控输入图的健康度(边缺失、特征漂移都会静默拉低效果);保留模型与数据的版本对应关系(图结构变了,旧嵌入就过期了)。
# 交付形态一:嵌入导出(供检索与聚类消费) import numpy as np model.eval() with torch.no_grad(): h = model.c1(data.x, data.edge_index).relu() # 取中间层表示(比任务输出更通用) emb = h.cpu().numpy() np.save("node_embeddings.npy", emb) # 行序=节点编号,随图版本入库 # 交付形态二:单节点在线推理的最小骨架 @torch.no_grad() def score_node(node_id, k_hop=2): """收集目标节点的邻子图并前向——生产中要加缓存与超时""" from torch_geometric.utils import k_hop_subgraph subset, ei_sub, _, _ = k_hop_subgraph(node_id, k_hop, data.edge_index, relabel_nodes=True) out = model(data.x[subset], ei_sub) return out[0].argmax().item(), float(out[0].max()) # 预测类别与置信度 pred, conf = score_node(0) print(f"节点 0 预测类别 {pred},置信度 {conf:.3f}")
常见工程坑归档
- 掩码泄漏:任何调参看了测试集,测试精度就失去意义——超参选择只允许用验证集。
- 特征漂移:业务特征的定义随版本变化("余额"口径改了),嵌入与模型需同步重训。
- 静默的图损坏:边表里的重复边、自环遗漏、悬空节点都不报错,勘查工位的统计要能兜住。
- 加载器口径不一致:训练用邻居采样、离线评估却用全图,两者分布不同,指标对不齐。
本节要点
- 框架选型:PyG 胜在轻快与研究生态,DGL 胜在分布式与多后端,团队熟悉度常是决定项。
- 流程六工位:接入、勘查、搭建、训练、评估、交付,每工位有明确的进出物。
- 数据三段纪律:训练掩码管学习、验证集管早停与选型、测试集只在终评出现一次。
- 交付两形态:离线嵌入导出最省事,在线服务要处理邻域收集、缓存与图版本。
复盘章至此收官:阵型、标尺、顽疾、工程化全部归档。下一章侦探社开设专案组,接手异构、动态、无标注这些常规流程啃不动的悬案。