6.3 无标注破案:图自监督与对比学习
6.3 无标注破案:图自监督与对比学习
本节摘要:图数据的结构本身就是免费监督信号——对比式方法用图增强制造正负样本对,把同源视图拉近、异源推远;互信息式方法让节点表示与全局摘要互相对暗号;预测式方法靠遮特征、猜上下文出题。本节覆盖增强设计、对比损失、预训练到微调的完整链路,以及线性探针评测协议。
零预算的破案法
初创团队的委托只有一句话:三千万账号的关系图就在这里,标注预算为零,三个月内要一套可用的风控表示。传统思路会卡死在"没有标签"这一步,但图数据恰恰是自监督学习的富矿——结构本身在源源不断地出题:这对节点相邻吗?遮住这个特征能猜回来吗?这个局部与整张图是一体的吗?每一道题的答案都写在数据里,不需要任何人工标注。本节把图自监督的三条出题路线(对比式、互信息式、预测式)讲透,再给出"预训练到微调"的工程链路。它在全册知识体系里的位置是:为第四章的所有结案任务提供"表示增强"的前置工序,也是第七章图基础模型叙事的序章。
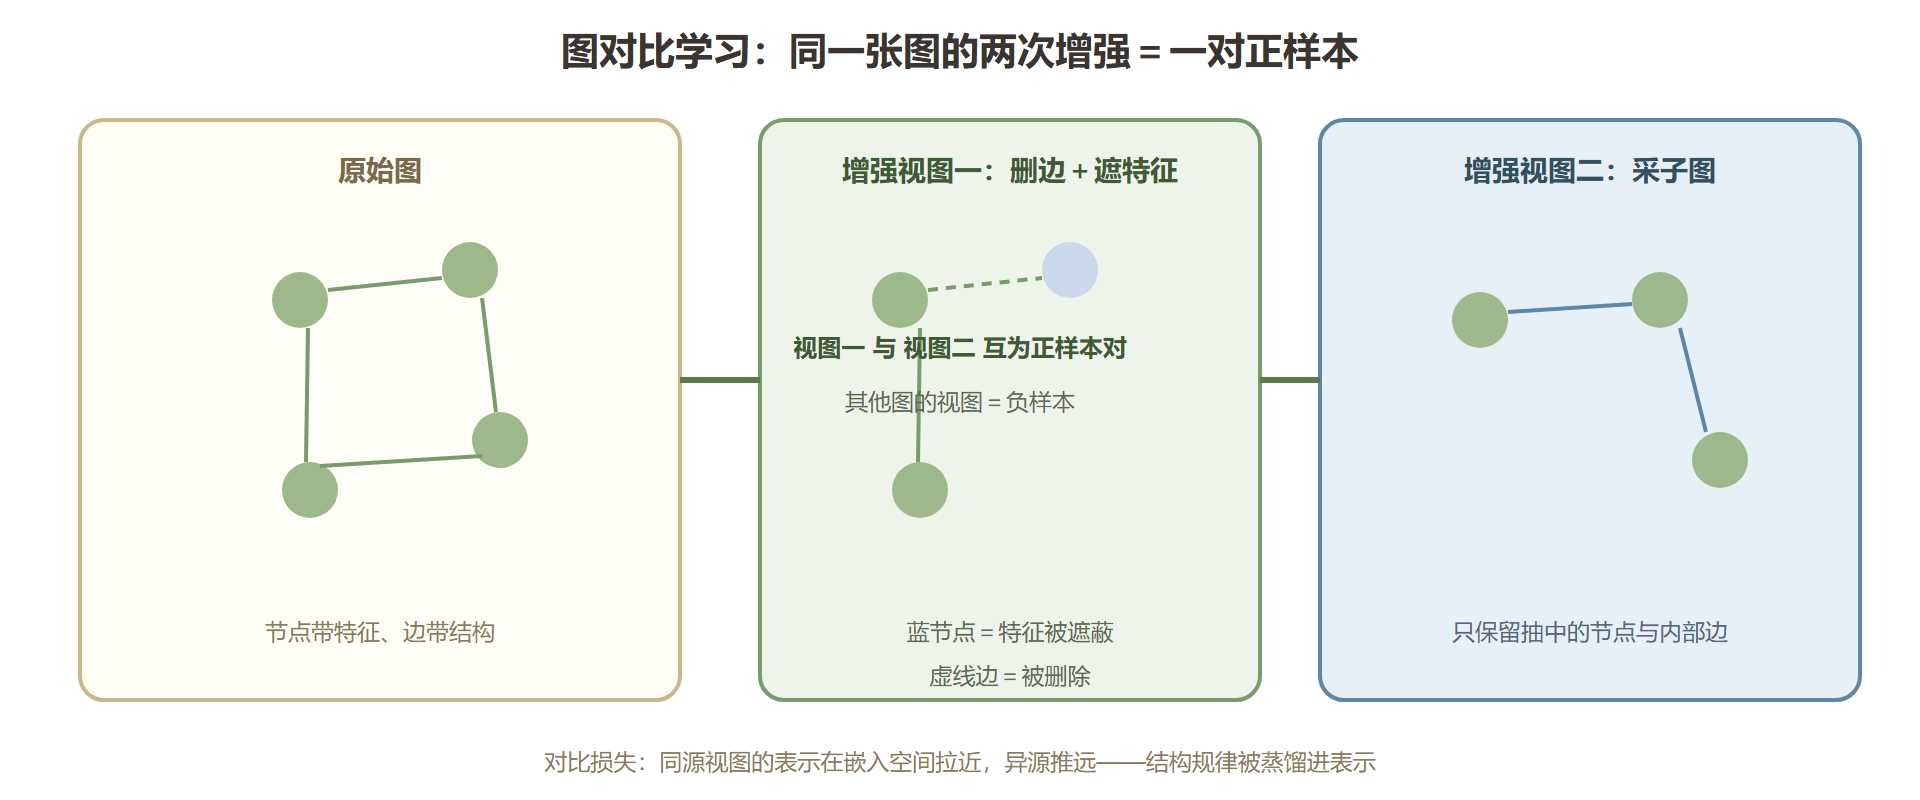
图:对比学习的正负样本构造
出题路线一:对比式
对比学习的流水线分三步:增强、编码、对比。增强在图上有结构域与属性域两套手法——删边、删点、采子图改变结构;遮特征、加特征噪声扰动属性。增强的组合与强度是首要超参:太弱则两个视图几乎相同,模型学不到东西(学到的是"抄近路");太强则语义被破坏,正样本对名不副实。经验起点是轻度删边加中等比例特征遮蔽,再按下游验证表现微调。编码就是前几章的消息传递模型,无标注场景下它只是表示的生产车间。对比用 InfoNCE 类损失:批内把正样本对的相似度与其他样本(负样本)拉开,温度参数控制对难负样本的惩罚力度。图对比学习工作系统研究了增强组合与任务的关系:结构类增强利于结构敏感任务(社区检测),属性类增强利于内容敏感任务(主题分类)。
# 图增强的最小实现:结构域与属性域各一手 import torch def augment(x, edge_index, drop_edge=0.2, mask_feat=0.25): """返回一个增强视图(结构+属性同时轻扰动)""" n_edges = edge_index.size(1) keep = torch.rand(n_edges) > drop_edge ei_aug = edge_index[:, keep] # 删边 feat_mask = torch.rand(x.size(1), device=x.device) > mask_feat x_aug = x * feat_mask.unsqueeze(0) # 遮特征(整列遮,保持语义) drop_nodes = (x_aug.abs().sum(1) == 0) # 极端情况:孤立点自然形成 return x_aug, ei_aug # 正样本对:同一份数据增强两次 x1, ei1 = augment(data_x := torch.randn(20, 8), torch.tensor([[i for i in range(19)], [i+1 for i in range(19)]])) x2, ei2 = augment(data_x, torch.tensor([[i for i in range(19)], [i+1 for i in range(19)]])) print("视图一边数:", ei1.size(1), " 视图二边数:", ei2.size(1)) # 两个视图不同但同源——对比学习的全部燃料
出题路线二:互信息式
互信息式方法换了一种问法:"这个节点的表示与整张图的摘要一致吗?"代表做法是深度图信息最大化(通称 DGI):编码器产出节点表示,读出函数把全图压成一个摘要向量;判别器逐节点判断"该节点属于这张图吗"(正例),再用打乱的或来自其他图的节点当负例。训练收敛后,节点表示为了"骗过判别器"必须携带足够的全局结构信息——局部与全局的一致性本身成了监督信号。这条路线不需要设计增强(负例来自打乱),对增强调参头疼的团队是个省心选项;代价是判别器质量决定表示上限,且"全局摘要"的定义较粗。
# 互信息式的骨架:编码-读出-判别 三件套(示意) import torch import torch.nn.functional as F d = 16 enc = torch.nn.Linear(8, d) # 表示车间(实际用图卷积) readout = torch.nn.Linear(d, d) # 全图摘要 disc = torch.nn.Bilinear(d, d, 1) # 判别器:节点×摘要 → 属于该图? h_pos = enc(torch.randn(20, 8)) # 原图节点表示 h_neg = enc(torch.randn(20, 8)) # 负例:另一图(或打乱) s = readout(h_pos).mean(0, keepdim=True).expand(20, -1) # 共享的全局摘要 pos_score = disc(h_pos, s).squeeze(-1) # 应判"属于" neg_score = disc(h_neg, s).squeeze(-1) # 应判"不属于" logits = torch.cat([pos_score, neg_score]) labels = torch.cat([torch.ones(20), torch.zeros(20)]) loss = F.binary_cross_entropy_with_logits(logits, labels) print("判别损失:", round(loss.item(), 4)) # 训练这个"辨别游戏",编码器被迫让本图节点与全局摘要互相印证——结构信息入表示
出题路线三:预测式
预测式出题更接近填空:属性遮蔽(遮住部分节点特征,让模型按邻域猜回来——类似完形填空)、上下文预测(遮住某个邻域,让模型根据外围结构猜内部结构——类似看图补全)、边重建(随机删边再让模型判断两端点是否原本相连——第四章链接预测的 自监督 形态)。预测式方法训练稳定、对超参不敏感,学习到的表示偏重局部相关性;对比式学到的偏全局不变性。实践里两种常预训练两份表示拼着用,或按下游任务性质择一。
预训练到微调的工程链路
自监督的完整用法分三段。预训练:在无标注图上跑自监督损失若干轮,得到编码器。评测(线性探针):冻结编码器,只训练一个线性分类器,用少量标签测表示质量——探针精度高说明信息已进表示,微调空间大。微调:解冻全部或顶层参数,用下游少量标签精调。这段链路的价值在标签稀缺现场最明显:三千万账号零预算的委托,先用对比学习预训练出通用表示,风控同事只需标注数千个账号即可完成微调——标注成本压到可承受区间。
# 线性探针:冻结表示,只训线性头(评测表示质量的金标准) import torch def linear_probe(h, y, train_mask, test_mask, epochs=100): """h: 冻结的节点表示;只训练线性分类器""" head = torch.nn.Linear(h.size(1), int(y.max()) + 1) opt = torch.optim.Adam(head.parameters(), lr=0.05) for _ in range(epochs): opt.zero_grad() F.cross_entropy(head(h[train_mask]), y[train_mask]).backward() opt.step() with torch.no_grad(): acc = (head(h[test_mask]).argmax(1) == y[test_mask]).float().mean() return acc.item() h_frozen = enc(torch.randn(20, 8)).detach() # 预训练表示(冻结) y_demo = torch.randint(0, 3, (20,)) print("线性探针精度:", linear_probe(h_frozen, y_demo, torch.arange(0, 12), torch.arange(12, 20))) # 探针协议排除微调干扰,纯粹衡量"预训练把多少任务相关信息压进了表示"
本节要点
- 免费监督:邻接关系、特征可恢复性、局部全局一致性都是无标注的习题答案。
- 对比三步:增强造对、编码产表示、损失拉近推远;增强强度是第一超参。
- 互信息式:局部对全局的"对暗号"游戏,免增强设计,省心之选。
- 预测式:填空与补全类任务,稳定不挑参,偏局部相关性。
- 链路纪律:预训练后用线性探针体检,微调只花小标注预算。
表示的免费午餐拿下了,最后一桩悬案把图变成"推理对象"与"生成对象":知识图谱上的关系推断与从零到一的图生成。