6.4 情报网与案件重演:知识图谱推理与图生成
6.4 情报网与案件重演:知识图谱推理与图生成
本节摘要:知识图谱推理以三元组打分为核心——平移类把关系看作头实体到尾实体的位移,双线性类做交互分解,神经网络类用消息传递;图生成则让模型从零构造新图,自回归逐节点逐边"画图"、隐空间变分解码、扩散式去噪多路线并行,评价指标看有效性、独特性与分布贴近度。本节是第六章的收官双卷宗。
最后两份卷宗
专案组的收尾卷宗是两份"方向性"委托。第一份来自情报部门:知识图谱里实体数以百万计,关系谓词几十种,缺漏严重——"某公司与某高管是否存在任职关系"需要模型推断补全,这桩案子的技术核心是给三元组打分。第二份来自材料实验室:想要"具有目标性质的新分子",即在约束下生成全新图结构——案件重演的高级形态:不只分析已有案子,还要推演出尚未发生的案子。两份卷宗分别代表图学习的两大纵深方向,本节各用一节的篇幅讲清主干。
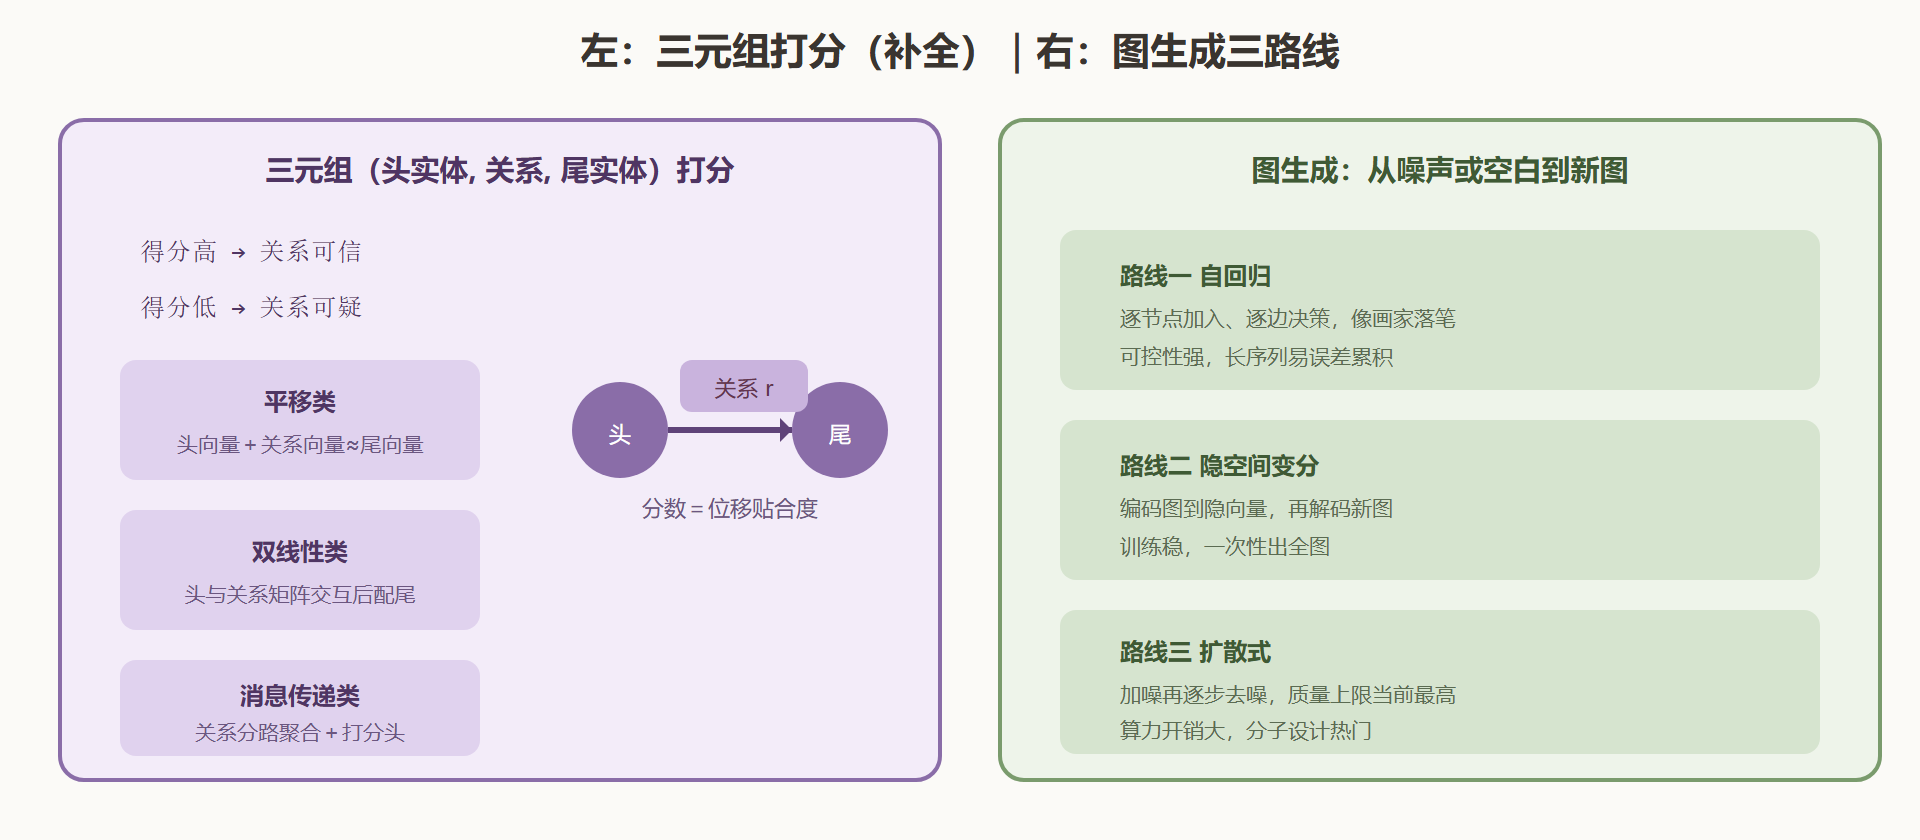
图:知识图谱打分与图生成的三条路线
知识图谱推理:打分函数大家族
补全任务的统一接口是打分:给定头实体与关系,枚举候选尾实体并按分数排序,高位者即补全建议。平移类最简洁:把关系看成嵌入空间里的位移向量,头实体向量加关系向量应落在尾实体向量附近——距离即分数。它抓住了多关系数据最朴素的几何直觉,可解释性强(关系的语义就是"往哪个方向挪"),但在对称关系与一对多关系上先天吃力(一个位移只能指向一个点)。双线性类用关系矩阵做头尾向量的交互变换,表达力高于纯平移,参数量居中,长年在基准榜上活跃。消息传递类是本章的主题回归:用关系图卷积在图谱上做分路聚合(每种谓词一条路),节点表示吸收了多跳邻域的图谱结构信息后,再接打分头——它把"实体表示"从孤立查表升级为"结构推断",在稀疏图谱上优势明显。评测沿用链接预测协议(命中率、逆排序),但必须用滤波模式:把已知为真的三元组从候选里剔除,否则排序指标被"已见过的答案"污染。
# 平移类打分的完整训练骨架(最小实现) import torch import torch.nn.functional as F torch.manual_seed(0) n_ent, n_rel, d = 12, 3, 8 ent_emb = torch.nn.Embedding(n_ent, d) rel_emb = torch.nn.Embedding(n_rel, d) # 三元组示意:(公司甲, 任职, 高管乙) 等 triples = torch.tensor([ [0, 0, 5], [1, 0, 6], [2, 1, 7], [3, 1, 8], [4, 2, 9], [5, 2, 10], [0, 0, 6], [2, 1, 5]]) opt = torch.optim.Adam(list(ent_emb.parameters()) + list(rel_emb.parameters()), lr=0.02) for epoch in range(200): h, r, t = ent_emb(triples[:,0]), rel_emb(triples[:,1]), ent_emb(triples[:,2]) pos_score = ((h + r - t) ** 2).sum(-1) # 距离越小越好 neg_t = torch.randint(0, n_ent, (triples.size(0),)) # 负例:随机换尾实体 neg_score = ((h + r - ent_emb(neg_t)) ** 2).sum(-1) # 合页损失:正例距离应比负例至少低出边际 loss = F.relu(1.0 + pos_score - neg_score).mean() opt.zero_grad(); loss.backward(); opt.step() # 推理:给定(实体2, 关系1, ?)给所有候选打分排序 with torch.no_grad(): scores = ((ent_emb.weight[2] + rel_emb.weight[1] - ent_emb.weight) ** 2).sum(-1) ranking = scores.argsort() print("补全候选排序(分数升序,前几名最可信):", ranking[:4].tolist())
图生成:三条路线与评价
图生成的输出不是向量而是图本身,这带来两个独特问题:怎么处理离散且变长的结构、怎么评价生成质量。自回归路线把生成拆成决策序列:先决定加不加节点,再决定它与哪些已有节点连边——每步都是小分类问题,循环网络或 Transformer 都能当决策器;优点是天然支持条件生成("生成带羧基的分子"),缺点是序列长了误差累积。隐空间变分路线先学图的连续隐表示,再从隐空间采样解码成图——训练稳定,一次成图,但对离散结构的解码需要松弛技巧。扩散路线先给图逐步加噪、再学反向去噪,当前在分子生成任务上质量领先,代价是采样步数多、算力贵。评价体系三件套:有效性(生成的分子能否对应合法化学结构)、独特性(生成的图是否互不雷同、不抄训练集)、分布贴近度(生成集合的统计性质与训练分布的距离,分子任务常用专门指标衡量化学空间重叠)。
# 自回归生成的决策骨架:每步回答"加节点吗、连到谁" import torch import torch.nn.functional as F torch.manual_seed(1) d = 16 node_rnn = torch.nn.GRUCell(d, d) # 状态机:已生成图的摘要 add_head = torch.nn.Linear(d, 2) # 决策一:继续加 or 停止 edge_head = torch.nn.Linear(2 * d, 1) # 决策二:新节点连到哪个旧节点 def generate(max_nodes=8, stop_prob_bias=0.0): h = torch.zeros(1, d) # 初始状态 nodes = [h.clone()] for step in range(max_nodes - 1): h = node_rnn(nodes[-1], h) # 状态推进 p_stop = F.softmax(add_head(h) + stop_prob_bias, dim=-1)[0, 1] if torch.rand(1) < p_stop: break # 新节点与每个旧节点逐一判断连边概率 new_h = h edges = [] for j, old in enumerate(nodes): p_edge = torch.sigmoid(edge_head(torch.cat([new_h.squeeze(0), old.squeeze(0)])))[0] if torch.rand(1) < p_edge: edges.append((len(nodes), j)) nodes.append(new_h) return len(nodes), edges n, e = generate() print(f"生成图:{n} 个节点,{len(e)} 条边 {e[:6]}") # 真实系统里状态机输入的是"已生成图的编码"而非单步隐状态, # 且训练信号来自教师强制(按真实图的生成轨迹逐步监督)
两份卷宗的交汇
知识图谱与生成并非孤立:图谱上的推理可视为"约束驱动的受限生成"(补全即生成一条最可信的边),而生成的可控性技术(条件注入、约束解码)反过来服务图谱的规则校验。工业的典型组合拳:先在图谱上做关系推理缩小候选空间,再用条件生成产出具体结构(药物研发的"先找靶点再设计分子"正是此路)。第六章的四桩悬案至此全部结案,改造的艺术——分路、加时序、给证据、找免费监督、组合约束——构成图学习进阶阶段的主旋律。
本节要点
- 打分即补全:平移类重几何直觉、双线性类重交互、消息传递类重结构推断;评测须滤波。
- 生成三路线:自回归可控、变分稳定、扩散质量高,按算力与可控性需求取舍。
- 生成评价三件套:有效性、独特性、分布贴近度,缺一不可。
- 交汇点:图谱推理是受限生成,可控生成反哺图谱校验,组合拳是研发现场的常态。
高级主题收官。最后一章回到侦探社本身:验收规范、未破之谜、技术动向与职业操守——归档与展望。