第1章 图论筑基
第 1 章 · 图论筑基
章节摘要:本章解决的问题是——在进入最短路径、最小生成树、最大流这些进阶主题之前,你必须把"图"这个数据结构的语言体系建立起来。我们会讲清图的形式化定义与分类、两种主流表示法(邻接矩阵与邻接表)的取舍,以及 DFS 与 BFS 两大遍历骨架。读完本章,你应当能对任何一个实际问题做出两个判断:它是不是图问题、该用什么结构存它。
阅读收获
阅读完本章,你应当能够:
- 用二元组的形式化定义描述一个图,并区分有向图、无向图、带权图;
- 说出度、入度、出度、路径、环、连通分量等术语的准确含义;
- 在邻接矩阵与邻接表之间,按图的稠密程度做出正确的选型;
- 手工模拟 DFS 和 BFS 在具体图上的执行过程;
- 判断一个图问题应该归约到遍历、最短路径还是连通性问题。
核心概念速览
图是一切"关系型问题"的统一语言:先把问题翻译成图,再谈算法。
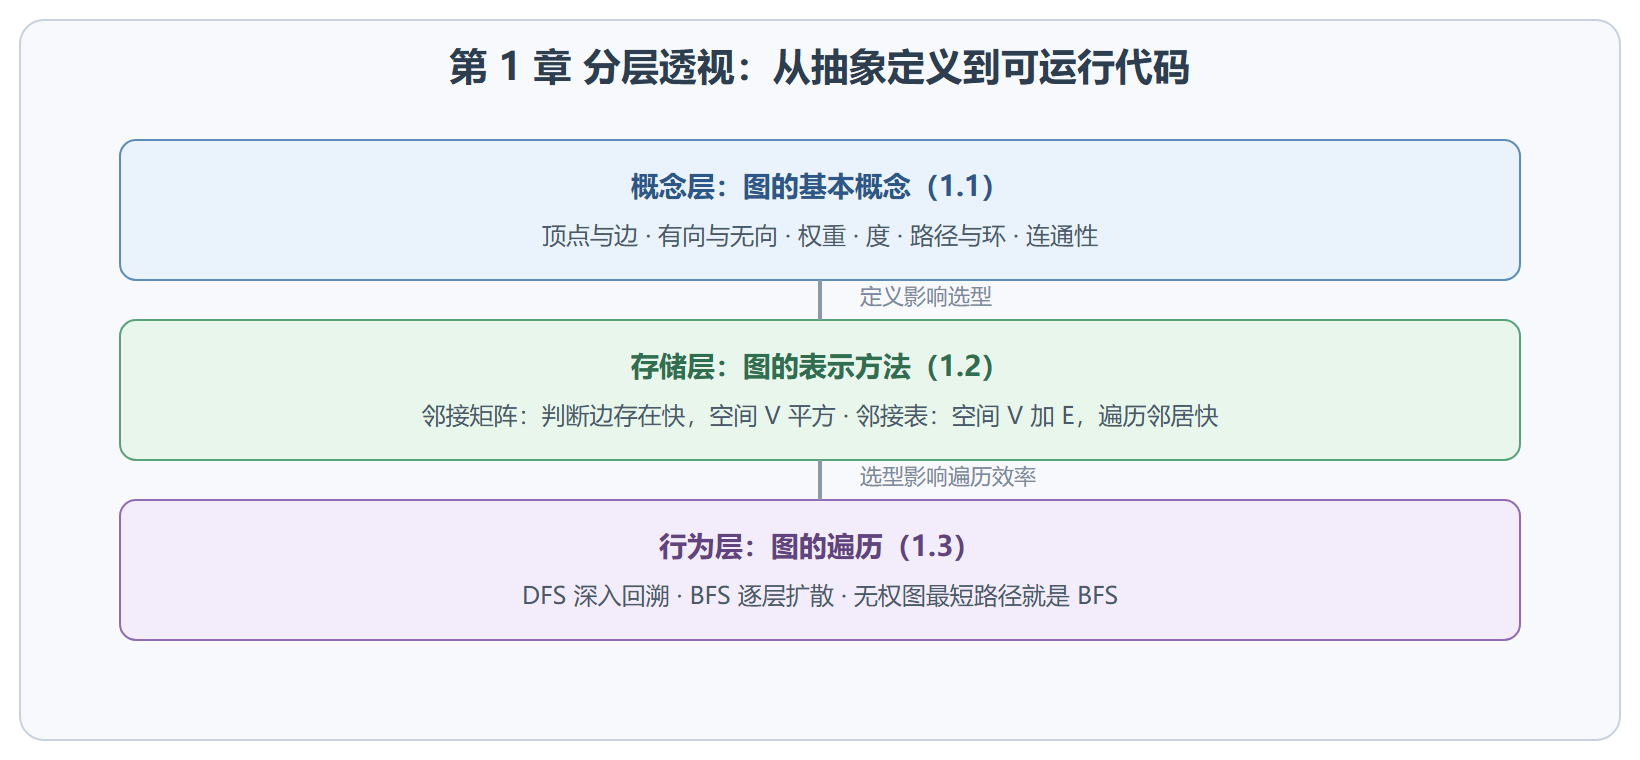
本章知识分层图
子章节导航
1.1 图的基本概念
讲图的形式化定义、分类体系与核心术语。这是全书的"词汇表",后面的每一章都默认你熟悉这里的每个词。
1.2 图的表示方法
邻接矩阵与邻接表的正面对比:空间、查询、遍历邻居三笔账一起算,并给出选型决策表。还会提到边集数组等辅助表示。
1.3 图的遍历算法
DFS 与 BFS 的执行过程、代码骨架与复杂度,以及一个关键伏笔——BFS 在无权图上就是最短路径算法,这直接通向第 2 章。
子章节之间的逻辑关系
本章三节是自底向上的关系:概念定义决定你如何建模,建模方式决定存储结构,存储结构决定遍历的效率。
[1.1 概念] --建模--> [1.2 表示] --支撑--> [1.3 遍历] | | | 加权 / 方向 / 稀疏 | +----------------------------------------+ 共同构成第 2~4 章的地基
一个典型的连锁反应:社交网络好友关系是无向稀疏图(1.1),于是选邻接表(1.2),于是 BFS 找"几度人脉"时每个节点只花与度数成正比的时间(1.3)。三节的顺序不能颠倒,因为每一步的决策都依赖上一步的结论。
常见疑问解答
学过一点图论,能不能跳过本章?
可以做一个小测试再决定:给你一个"好友关系 + 聊天频次"的数据集,让你判断"任意两人之间隔几个好友"和"哪几个人际圈子把整个群体切成了两半",你能不能在十分钟内说出图的表示法、遍历选择和大致复杂度。答得上,直接进第 2 章;哪里卡壳,就回对应小节补——本章三节彼此独立成篇,允许跳跃式复习。
本章内容与面试考察的关系?
面试里"手写图的遍历"是高频基础题,而"邻接矩阵和邻接表怎么选"则是检验工程直觉的常用追问。更深的一层是:后面章节的算法题(最短路、生成树、并查集判环)在面试中出现时,考官默认你本章的内容已经内化——遍历代码里忘了 visited、复杂度分析说不出"为什么邻接表是线性",都会被归为地基不牢。
图的术语各书叫法不一,怎么办?
中文资料里"顶点/节点"、"边/弧"、"深度优先/纵深优先"混用是常态,英文资料同样有 vertex 与 node 之别。建议以本书的用词为准并记住对应的常见别名,读外文资料时先扫一眼术语表再进入正文,避免在概念对译上耗神。
本章的自测清单
合上书自查五题:给"微博关注关系"选择图的分类(有向、可带权、稀疏);说明"度数之和等于两倍边数"的由来;为千万级社交图选表示法并说明理由;手推四点图上 BFS 的访问序;解释 BFS 为何天然给出无权最短路。五题全对,本章可以翻篇;任何一题迟疑超过半分钟,对应小节值得再看一遍——地基的裂缝会一路延伸到第四章的管网里。
章末的一句提醒
图论术语是全书的"官方语言",本章的每个词都会在后面四章高频复用——把 1.1 的术语表存进自己的笔记,后面遇到含糊处随手回查,比每次靠猜省时得多。学习图算法最大的隐性成本不是算法本身,而是概念对齐:术语差一个字,讨论就会错位一整段。
前置知识与后续延伸
- 前置:一门编程语言的基础语法、数组和链表、递归的直觉、大 O 记号的粗略概念。
- 为后续铺垫:1.2 的邻接表是第 2 章 Dijkstra 与第 3 章 Kruskal 的存储基础;1.3 的 BFS 直接升级为第 2 章无权图最短路;1.3 的 DFS 连通性判断是第 3 章生成树与第 5 章并查集的思维原型。