2.4 DAG与无权图上的最短路径
2.4 DAG 与无权图上的最短路径
本节摘要:当图具备特殊结构,最短路径可以绕开通用算法的重量级 machinery。有向无环图(DAG)上,按拓扑序对每条边各松弛一次,即可在"点数加边数"的线性时间内完成单源最短路——且不受负权边影响;无权图上,BFS 本身就是最短路径算法,同样是线性时间。本节讲两个特例的原理、实现与触发条件,并给出全章选型总表。
上手前先明确
阅读完本节,你应当能够:
- 写出"拓扑排序 + 逐边松弛"的 DAG 最短路算法;
- 解释为什么 DAG 允许负权边、也不需要负环检测;
- 说明 BFS 在无权图上求最短路的正确性论证;
- 在拿到问题时第一时间识别"这是 DAG / 这是无权图"的信号;
- 用一张总表完成第 2 章全部算法的选型。
一、DAG:没有环,一切都被理顺了
有向无环图(Directed Acyclic Graph)是"有方向、且沿方向永远走不回原地"的图。它的顶点可以被排成一个线性序列——拓扑序——使所有边的方向都与序列一致(边只从排在前面的点指向排在后面的点)。任务依赖(B 学分需要先修 A)、流程编排、 spreadsheet 单元格依赖、编译目标文件之间的 include 关系,天然都是 DAG。
拓扑序的存在给最短路计算带来了决定性的简化:按拓扑序处理顶点,处理到某个点时,它所有可能的前驱都已经处理完毕。于是每条边只需要被松弛一次——不存在"之后又冒出更短的前驱路径"的可能,因为前驱全部在前面,一个不漏。
def dag_shortest_path(graph, topo_order, start): dist = {node: float('inf') for node in graph} dist[start] = 0 for u in topo_order: # 拓扑序扫描 if dist[u] == float('inf'): continue # 源点不可达 跳过 for v, w in graph[u]: if dist[u] + w < dist[v]: dist[v] = dist[u] + w return dist
三个此前费尽周折的问题在这里集体消失:
- 负权边:随便。算法的正确性只依赖"每个前驱先于它处理",与权重符号无关。
- 负环:不存在。DAG 无环,负环无从谈起,检测环节可以整个删掉。
- 多轮迭代 / 优先队列:不需要。一趟线性扫描就是终点。
复杂度为"拓扑排序的线性开销加逐边松弛的线性开销",即点数加边数级别——这是最短路径问题理论上的速度极限(至少要把每条边看一眼)。原始文集把这套流程比作"细致的规划者按既定顺序有条不紊地完成任务",并明确其复杂度就是线性时间。顺带一提:把所有边权取反再跑同样的算法,就得到 DAG 上的最长路径——关键路径调度(项目管理里"哪条依赖链决定总工期")的标准解法,而一般图上的最长路径是 NP 难问题,这个反差恰好凸显 DAG 结构的"红利"。
二、无权图:BFS 就是答案
无权图是"所有边权重相等"的退化情形(等价于权重全为 1)。1.3 节已经铺垫了结论:BFS 按到起点的边数逐层扩展,顶点首次被标记时的层数就是最少边数距离。正确性来自层序的单调性——所有更浅的层先被处理,所以第一次到达某点时,不可能存在更短的路径被"漏掉"。
原始文集把 BFS 比作"逐层扩展的园丁",并指出无权图最短路的时间复杂度为顶点数加边数的线性级别。与 Dijkstra 对照着看会更清楚:Dijkstra 是把 BFS 的"队列"升级成"优先队列",把"层数加一"升级成"距离加边权"——BFS 是 Dijkstra 在整数等权图上的特例,层次序就是天然的处理顺序。
两个实用的引申:
- "几度人脉":社交图上问"A 与 B 相隔几个好友",就是无权最短路,BFS 直接解决。
- 状态图搜索:把问题的每个状态看作顶点、每步操作看作边(如华容道移动、倒水问题),状态图常常无权,BFS 找最少步数是标准建模。
三、全章选型总表与识别信号
| 场景信号 | 算法 | 复杂度 | 备注 |
|---|---|---|---|
| 无权图 | BFS | 点数加边数 | 首次标记即最短 |
| 有向无环(DAG) | 拓扑序松弛 | 点数加边数 | 容忍负权 可求最长路 |
| 非负权 一般图 | Dijkstra 堆优化 | 边数乘 log 点数 | 单源默认选项 |
| 负权边 存在 | Bellman-Ford | 点数乘边数 | 可检测负环 |
| 负权 且图大 | SPFA | 平均快 最坏同上 | 谨防被构造数据卡 |
| 全源 点数百级 | Floyd-Warshall | 点数立方 | 五行代码 对角线判负环 |
| 全源 大稀疏图 | Johnson | 点数次 Dijkstra | 重赋权套路 实现较繁 |
识别信号的经验法则:先问"边有没有权重";再问"有没有方向";有方向就追问"有没有环";最后问"要单源还是全源"。四问下来,答案基本锁定。特别提醒:题目里"依赖、先后、层次、流水线"这类措辞是 DAG 的强烈信号——识别结构比背算法更省力。
特殊图算法的位置图
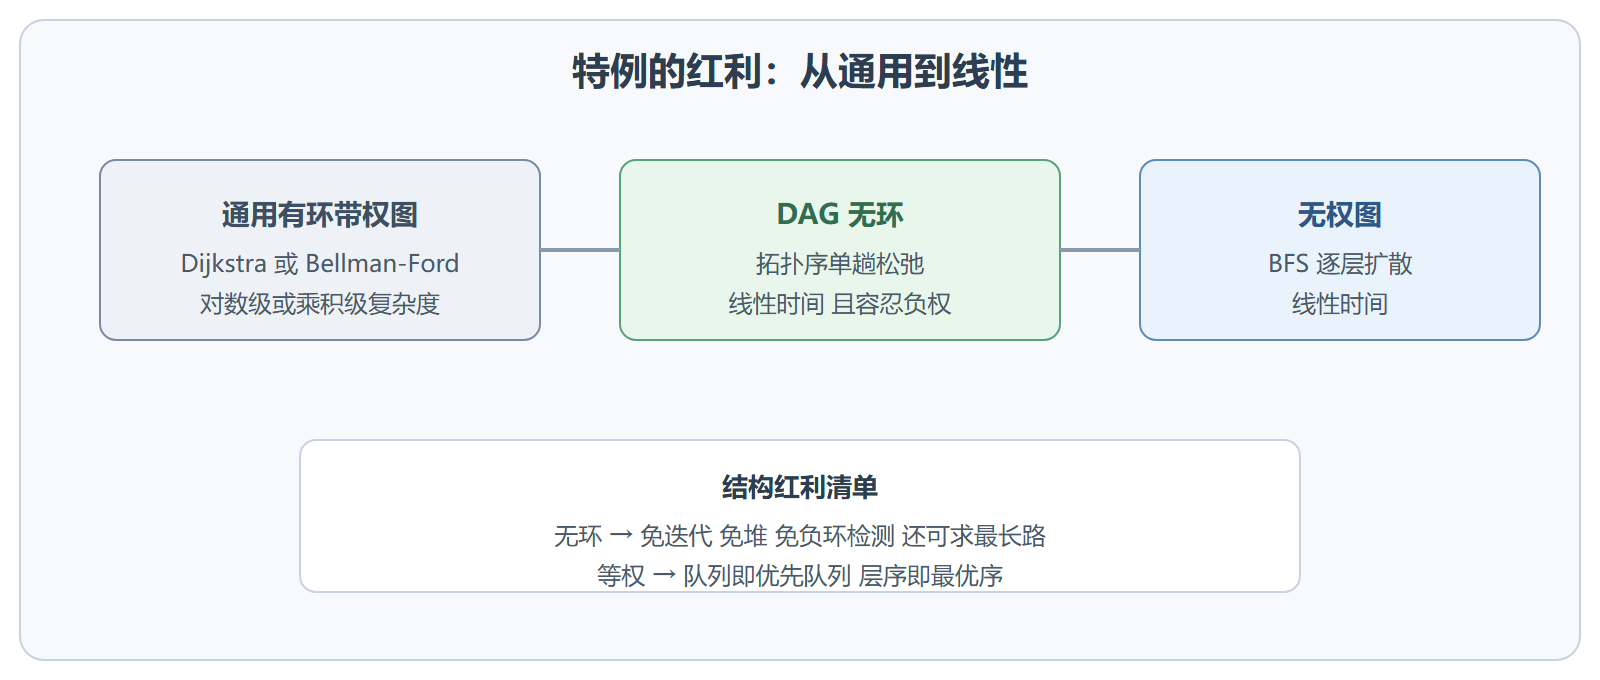
⚠️ 常见坑:拿到 DAG 却上了 Dijkstra。能算对,但白白付出对数因子,更糟的是掩盖了"可直接求最长路"这一结构信息。另一个方向:把带环的图误当 DAG 用拓扑排序,排序阶段就会发现无法排完(存在环),此时应退回通用算法并排查建模。
💡 关键直觉:算法复杂度买的是"图的不确定性"。环的存在让"先处理的点可能被后面的路反超",于是要堆、要迭代;无权让"更近"与"更少步"重合,于是队列就够了。识别出图缺什么"不确定性",就能省掉对应的机器。
四、深入一层:DAG 的"线性世界观"
DAG 上的算法之所以又快又稳,根源在于它把二维的图结构压成了一维的线性顺序。拓扑序一旦建立,"时间"就诞生了:所有信息只从前往后流,不会回流。于是递推式的计算(最短路、最长路、路径计数、概率传播)都变成一趟扫描。这个"线性化"思想远远超出最短路的范围:动态规划本质上就是在 DAG 上做递推——状态是顶点,转移是边;把一个问题建成 DAG 后,拓扑序就是"安全的计算顺序"。反过来,如果你的动态规划出现"循环依赖",等价于图里有环,正是拓扑排序无法完成的那类结构。
值得收藏的还有"最长路"的联动价值:把边权取反跑 DAG 最短路,得到的路径就是原权下的最长路。项目管理的关键路径法(哪条依赖链决定总工期)、编译流水线的瓶颈分析、流水线调度,全是这个转化的直接应用。一般图上的最长路径是 NP 难问题,而 DAG 上线性可解——同一问题在不同结构上的复杂度鸿沟,没有比这更鲜明的例子了。
常见疑问解答
拓扑排序本身怎么实现?
两种主流做法:入度剥离法(反复移除入度为零的点,配队列,就是 BFS 的变体)与 DFS 后序逆序(每个点在递归结束时入栈,最终栈序即拓扑序)。前者直观好写,后者一次 DFS 顺带完成。图中若有环,入度剥离会卡住"剩余点入度全大于零",DFS 逆序则需检测后向边——两种实现都自带环检测。
怎么判断我的问题图是不是 DAG?
直接跑拓扑排序:能排完就是 DAG,排不完就说明有环。业务侧的信号也很有用:依赖关系是否"单向不回头"、流程能否画出清晰的层次。若逻辑上应该无环但排序失败,通常是数据问题(循环依赖),这正是拓扑排序在构建系统里当"依赖检查器"的用法。
无权图上"加权算法"会不会更快?
不会更快,只会更重。Dijkstra 在等权图上退化为"按层扩展",但带着堆的额外开销;直接 BFS 即是最优。反过来,BFS 的"首次标记即最短"依赖等权这一前提,边权一旦不等就必须升级——两个方向的"降级/升级"判断,是选型时的基本 reflex。
DAG 最短路需要处理"不可达"吗?
需要。源点拓扑序之前或不在其下游的顶点,距离保持无穷大。工程上同样要翻译成"不可达"语义;一个细节是拓扑序扫描时跳过无穷大点(示例代码里的 continue),否则会拿无穷大去松弛邻居,产生无意义的大数污染。
动手实验:任务编排里的最短与最长
取一个真实的构建场景:八个编译目标,依赖关系构成 DAG,每个目标的执行耗时已知。先用拓扑排序排出构建顺序;再跑"边权取反"的 DAG 最短路得到每个目标的"最早完成时间";配合从虚拟终点的反向最长路得到"最晚开始时间";两者之差为零的目标串成链——就是决定总工期的关键路径。这四步手算不超过二十分钟,却是项目管理软件"哪些任务一天都不能拖"功能的算法本体。做过一遍,DAG、最长路、拓扑序三个概念就在同一个问题里打通了。
结构识别的练习题
判断下列场景能否套 DAG 特性:课程先修关系求最少学期(是,DAG 最长路);版本依赖树求升级路径(视依赖是否单向,若可共存则退化为普通图);数据处理流水线找瓶颈阶段(是,DAG 关键路径);城市单行道网最短路(不是,单行只保证有向、不保证无环)。最后一例最有迷惑性——"有向"与"无环"是两个独立条件,识别时必须分开验证。
无权图上要"恰好经过 k 步的路径数"怎么算?
把 BFS 换成动态规划计数即可:用"到达每点、恰走 k 步的路径数"做表,每步由上一层邻居求和。这个变体在随机游走、正则表达式匹配的子结构里反复出现——同样的一张图,换"传递的信息"就从最短路变成计数,骨架依然是层序递推。
温故知新
- DAG 最短路:拓扑排序后单趟逐边松弛,线性时间,代码不到十行。
- 三大豁免:DAG 上负权随意、负环不存在、无需优先队列——结构红利集体兑现。
- 最长路彩蛋:DAG 取反边权即得最长路径,是关键路径调度的标准工具,而一般图最长路是 NP 难。
- 无权图结论:BFS 首次标记层数即最短边数,线性时间;BFS 是 Dijkstra 的等权特例。
- 状态图思维:把问题状态建成无权图后用 BFS 找最少步数,是搜索类问题的通用建模。
- 选型四问:有无权重、有无方向、有无环、单源还是全源——答完即锁定算法。
- 本章收束:从 Dijkstra 到 Johnson,所有算法都是"松弛"在不同调度策略下的变奏。
最短路径回答"两点间怎么走最划算"。下一章换一个问题——不关心走哪条路,只关心"把所有点连通起来的最小代价":最小生成树。