3.4 最小生成树的应用:从电网到聚类
3.4 最小生成树的应用:从电网到聚类
本节摘要:最小生成树的应用远超"省钱连通"的字面含义。基础设施领域,它是电网、光缆、交通主干网的设计模型;数据分析领域,"对 MST 删除权重最大的 k 减 1 条边"得到单链接聚类的等价结果;它还活跃在图像分割(区域相邻图)与基因组组装(读段重叠布局)中。本节按"基础设施—网络设计—数据分析—其他"四类展开,并给出完整的建模流程与案例复盘。
本节目标
阅读完本节,你应当能够:
- 把"铺设类"工程问题翻译成最小生成树模型,包括隐式完全图的构造;
- 说明"MST 删最长边聚类"与单链接聚类的等价性及使用要领;
- 识别图像分割、基因组组装等跨学科场景中的 MST 结构;
- 按标准建模流程(实体—关系—权重—约束)完成一次端到端分析。
一、基础设施:一切"铺设"问题的原型
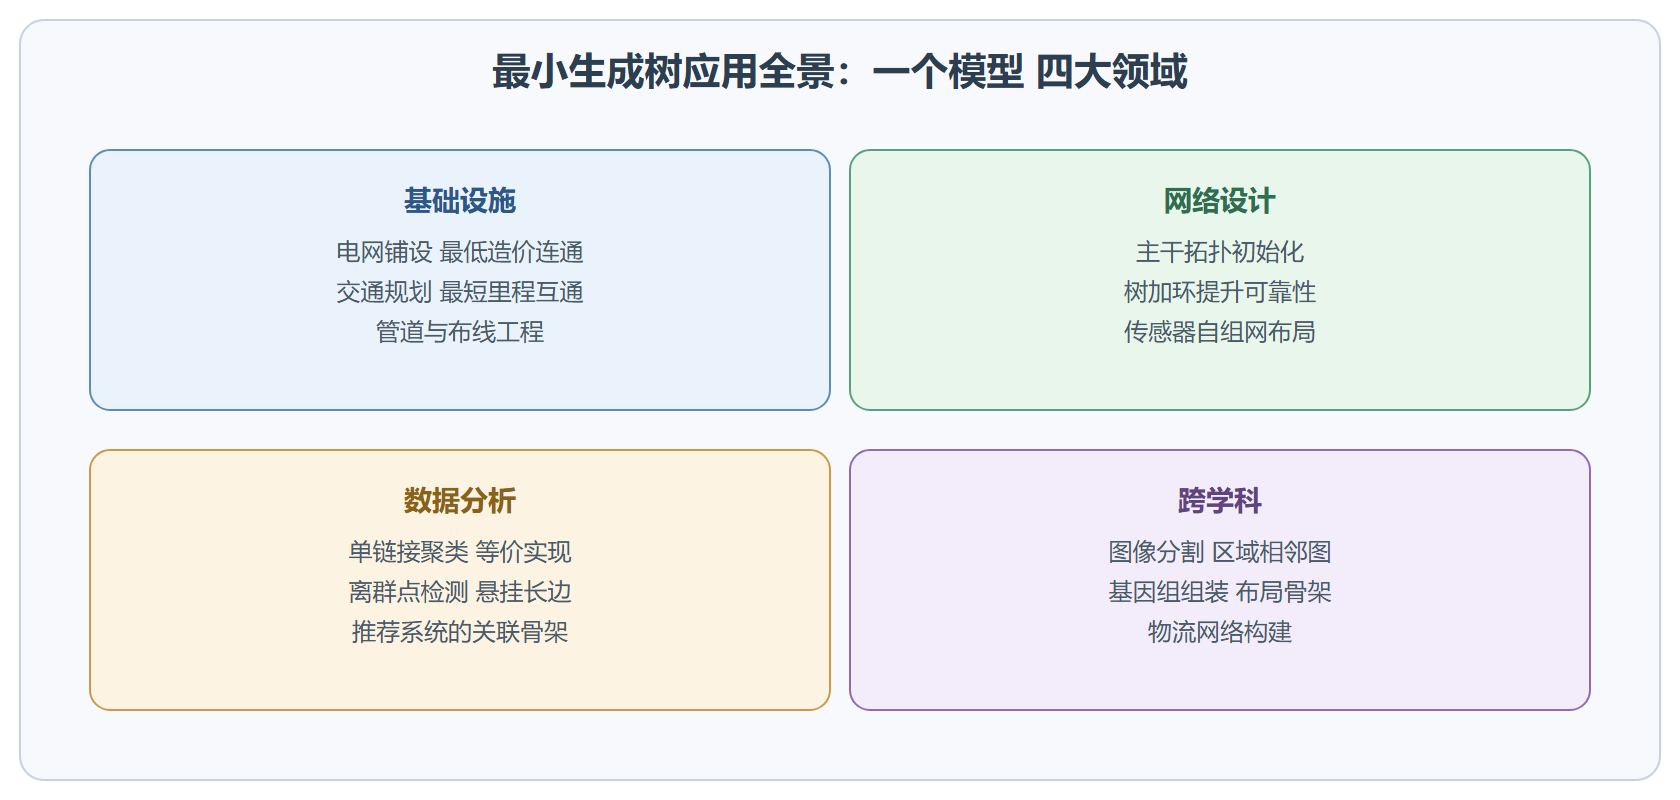
电网设计是最教科书级的场景:变电站与住户为顶点,候选线路为边,造价为权重,MST 就是最低成本的"人人通电"方案。通信网络同构:机房与光缆、基站与传输链路,建设成本最小化的数学形式一模一样。原始文集把这类问题统称为"基础设施建设:降本增效的利器",并强调其共同结构——一次性投入、覆盖全部节点、总成本最小。
交通网络规划需要多说一句:若目标是"让所有地点互通且修路总里程最短",它仍是 MST;但若目标含"任意两地通行时间"这类路径级指标,MST 就不够了——通常的做法是 MST 保证骨架连通,再按预算逐条补充"高流量捷径",或直接转向第 2 章的全源最短路做评估。目标决定模型,这句话在应用篇里值得反复默念。
一个常被忽略的工程点:现实候选线路未必两两直连(不能铺线的地方没有边),图可能是稀疏的;甚至可能出现"理论上可连任何两点"的隐式完全图(如无线自组网,任意两节点都可通信,代价随距离变化)。后者边数是平方级,构造时只保留"每个点最近的若干邻居"做近似,是控制规模的常规手段。
二、网络设计:优化布局与性能
网络主干设计里 MST 兑现为两类价值。其一是初始拓扑:新建园区网、传感器网络的骨干首先要求"连通且便宜",MST 给出起点方案。其二是环路增强:纯树拓扑有单点故障风险——树上一条边断开,整个网络分裂成两半。运营上常在 MST 之外追加少量关键边形成环(所谓"树加环"结构),在成本与可靠性之间折中;追加哪些边,往往参考"被 Kruskal 划掉的边里权重最小的一批"。
聚类分析是 MST 最出彩的跨界应用。思路:把每个数据点视为顶点,点间距离为边权(隐式完全图),先求 MST,再删除树上权重最大的 k 减 1 条边,树裂成 k 段,每段就是一个簇。直觉很好懂:MST 用最短的 n 减 1 条"桥"把所有点串起来,而簇与簇之间的"桥"必然是最长的几条——砍掉它们,自然分组浮现。
MST 聚类流程: 数据点 → 距离边权 → 求MST → 按边权从大到小删 k减1 条 → 得 k 个簇 等价性:结果与 单链接层次聚类 完全一致
这并非"碰巧像":单链接聚类每轮合并"距离最近的两个簇",而 Kruskal 逐条并入最小边的顺序与之严格对应——删边前的每个 Kruskal 中间森林,恰好是单链接树的一个切面。使用要领:k 的选取可借助"MST 边权的最大跳变"(删到哪条边时权重陡增,那里往往就是自然的簇边界);对链状数据(两簇之间拉出一条细长点桥)要警惕,单链接的"链式效应"会顺着桥把两簇悄悄连通。
图像分割:把像素(或超像素)视为顶点、相邻像素的颜色差异为边权,对区域相邻图求 MST 后删大边,得到视觉均匀的分割块。基因组组装:测序读段之间的重叠度为边权,先建"骨架式"的连接结构帮助确定读段的大致布局,是组装流水线里控制复杂度的经典环节。原始文集还列举了更多触类旁通的场景,共同点都是"用边权度量相似或代价,用最小连通提取骨架"。
三、建模流程与案例复盘
标准流程四步:
| 步骤 | 内容 | 电网案例 | 聚类案例 |
|---|---|---|---|
| 定实体 | 什么当顶点 | 变电站、住户 | 数据点 |
| 定关系 | 什么当边 | 可铺设线路 | 点对距离 |
| 定权重 | 边的代价或相似度 | 造价 | 距离或负相似度 |
| 查约束 | 连通吗 有无特殊要求 | 提前查连通分量 | 是否需处理链式效应 |
原始文集给过一个值得复盘的分析要领:拿到应用先问"最优解需要什么结构"。电网答案是多棵"局部子树"逐步拼合——直接上 Kruskal;聚类答案需要"按边权层次逐段断开"——同样落在 Kruskal 的中间过程上。选算法先看解的结构,再套复杂度,比背"稠密用 Prim、稀疏用 Kruskal"更接近问题的本质。
MST 应用全景
⚠️ 常见坑:把所有"连起来"的问题都套 MST。导航问"走哪条路最快"是最短路径;调度问"任务顺序"是拓扑排序;只有"以最小总代价让所有节点互通"才是 MST。另一个坑:聚类时拿业务距离直接当权重却不做量纲归一——不同量纲的特征会让某一维独裁边权,簇结构随之失真。
💡 关键直觉:MST 是数据的"最短骨架"——它保留了"谁和谁最该挨着"的全部信息,扔掉的只是冗余的边。聚类(砍骨架)、离群检测(看哪根骨头特别长)、网络增强(往骨架上加环),都是在这副骨架上做手术。
常见疑问解答
数据点上万时,"隐式完全图"的 MST 还能算吗?
能,但不要显式建出平方条边。两条路:其一,只保留每个点最近的 k 个邻居建稀疏图(k 取几十通常足够),在其上求 MST,结果绝大多数情况下与全量一致;其二,改用专门的空间结构(如 Delaunay 三角剖分)保证包含 MST 必需的边。显式建完全图再排序,内存与时间都会在几千点时就崩。
MST 聚类和 k-means 有何优劣?
MST 聚类(单链接)能识别任意形状的簇(月牙形、环形都行),k-means 只擅长凸形簇;但单链接怕链式效应(细长的点桥会把两簇悄悄连通),k-means 对初值敏感。实务中常见组合拳:先用 MST 快速粗分、检查边权分布,再决定要不要换更精细的模型。快、可解释、无需迭代收敛,是 MST 聚类的三大卖点。
"删最长边"的 k 是拍脑袋定的吗?
不必。两个客观辅助:看 MST 边权从大到小排列的"断层"——相邻权值出现陡降的位置往往就是自然簇边界;或结合业务指标(如簇内直径上限)反推删几条。把"删边数"当成可解释的调节旋钮,比网格搜索 k-means 的 k 更有依据。
工程里 MST 结果要"热更新"怎么办?
点或边动态变化时分三种情况:新增一个点,Prim 式地把它接到现有树的最近邻居即可(增量最优);新增一条边,看它能否替换树上环路中的最大边(维护 MST 的经典交换操作);删除边最麻烦,可能引发局部重算。高频变更场景建议定期全量重算加增量修补的双轨制,简单可靠。
动手实验:两簇数据的删边时刻
生成两团高斯分布的点各五十个,以欧氏距离为边权求 MST(用 k 近邻稀疏化建图),然后按边权从大到小打印前十条边。你会看到一条清晰的"断层"——最大的一条边比其余边大一个数量级,它就是连接两簇的那根"桥";删掉它,两簇自然分开。再把其中一簇拉成月牙形,观察 MST 聚类依然正确,而预先跑一次 k-means 会把月牙切断。这个十分钟实验同时演示了删边选 k、断层判据与"任意形状簇"三大卖点。
建模审阅清单
把本节的建模流程收尾成一张可打印的审阅清单:顶点是否有明确业务含义(还是为凑模型硬造的);边是否完整覆盖了可能的连接(漏边比错权更隐蔽);权重是否与优化目标同向(越大越好看似能反转,但要防零与负值陷阱);连通性与规模是否已探明(分量数、点边量级、是否需要稀疏化)。四项全过再动手写算法,能拦下绝大多数"模型层面就错了"的返工。
MST 建模最常见的"隐性翻车点"是什么?
是权重的方向。MST 最小化权重和,因此"相似度"必须先转成"距离"(比如取倒数或用一减相似度)才能当权重,直接拿相似度建图求出来的是"最不相似的骨架",南辕北辙。同类错误还包括量纲未归一、异常值主导边权。上线前抽查三件事:最大的几条边是否业务上讲得通、最小的几条边连接的样本是否真的相近、删边后的簇分布是否符合直觉——三问都能过,权重方向大概率没错。
重点提炼
- 基础设施类:电网、光缆、交通主干是最原型的 MST 场景,注意"路径级指标"要转回最短路径章。
- 网络设计:MST 作初始拓扑,"树加环"折中成本与可靠性,追加边可参考被 Kruskal 划掉的小边。
- 聚类等价性:MST 删最大 k 减 1 条边 = 单链接聚类的 k 簇划分,Kruskal 中间森林即层次聚类切面。
- 聚类要领:用边权最大跳变选 k;警惕链式效应与量纲未归一。
- 跨学科:图像分割与基因组组装共享"相似度建图—骨架提取"的建模套路。
- 建模四步:定实体、定关系、定权重、查约束——先看解的结构再选算法。
- 骨架视角:MST 是数据的最短骨架,聚类、离群检测、网络增强都是骨架上的"手术"。
"怎么连最省"至此闭环。下一章把图变成有容量的管网,追问一个新问题:从源头到出口,最多能送多少货——最大流。