3.3 Kruskal算法与并查集:化零为整
3.3 Kruskal 算法与并查集:化零为整
本节摘要:Kruskal 算法把图中全部边按权重升序排序,从最便宜的开始逐条尝试并入结果集,唯一的准入条件是"这条边的两端尚未连通"(用并查集在近似常数时间判定),直到收入 n 减 1 条边。排序主导了复杂度(边数乘 log 边数),配合并查集后整体极轻,是稀疏图上求最小生成树的默认选择。本节讲清算法流程、并查集的两项核心优化,以及与 Prim 的完整对比。
学习目标
阅读完本节,你应当能够:
- 手工模拟 Kruskal 的"排序—逐条裁决"过程;
- 说明"跳过成环边"为何不损害最优性(环性质);
- 实现带路径压缩与按秩合并的并查集,并分析其复杂度;
- 按图形态在 Kruskal 与 Prim 之间选型。
一、问题与直觉:从最便宜的生意做起
换一个经营视角:你手里有一张所有候选线路的报价单,目标是花最少的钱把所有站点连通。最自然的策略是按价格从低到高逐单审阅:只要这条线路连接的是两个"还不连通"的阵营,就成交;如果两端本来就通了(买它只会造出冗余环路),就划掉。成交满 n 减 1 单,收工。
为什么"两端已连通就跳过"是安全的?两端连通意味着选中这条边后会形成一个环,而它是这个环里最晚被审到(即不小于环上所有其他边)的边——环性质说"环上的最大边可弃",跳过它不损失最优性。原始文集称之为"化零为整、逐个合并"的过程:初始每个顶点自成一个阵营,每笔成交合并两个阵营,结束时全体归一。
用原始文集的 9 顶点例图看开头几步(边权含 1、2、4、4、6、6、7、7、8、8、9、10、11、14):
排序后逐条裁决: 权1 H-G 两端异阵营 成交 合并 {H,G} 权2 I-G 异阵营 成交 合并 {H,G,I} 权4 A-B 异阵营 成交 {A,B} 权4 C-D 异阵营 成交 {C,D} 权6 I-C 异阵营 成交 {H,G,I,C,D} 权6 G-F 异阵营 成交 ... 权7 C-F 两端已在同一阵营 划掉(成环) ... 直到累计 n减1 = 8 条边
注意权 7 的 C-F 被跳过——它两端已经通过 G、I 相连,买它只会造环。这正是环性质在流水线上的每一次落地。
二、并查集:几乎免费的连通判定
Kruskal 每审一条边都要回答"这两端连通吗",成交后还要"把两个阵营合起来"。朴素做法(维护每个阵营的成员表,或每次 DFS)会让整体复杂度恶化。并查集(union-find)就是为这两个操作量身定制的结构:
- 查(find):给出元素所在阵营的"代表";
- 并(union):把两个阵营合成一个。
实现是一个 parent 数组,初始每元素自为代表。两项经典优化让它飞起来:
class DSU: def __init__(self, n): self.parent = list(range(n)) self.rank = [0] * n def find(self, x): root = x while self.parent[root] != root: root = self.parent[root] while self.parent[x] != root: # 路径压缩 self.parent[x], x = root, self.parent[x] return root def union(self, a, b): ra, rb = self.find(a), self.find(b) if ra == rb: return False # 已同阵营 if self.rank[ra] < self.rank[rb]: # 按秩合并 ra, rb = rb, ra self.parent[rb] = ra if self.rank[ra] == self.rank[rb]: self.rank[ra] += 1 return True
- 路径压缩:find 过程中把沿途节点直接挂到根上,树越查越扁;
- 按秩合并:矮树挂到高树下,避免越并越深。
两者齐用后,单次操作的平均代价是"阿克曼函数的反函数"级别——对一切现实规模可以当常数看待。并查集的更多工程细节在第 5 章 5.1 节还会展开。
有了它,Kruskal 主体只剩几行:
def kruskal(n, edges): # edges 为 边集数组 每项为 w u v dsu = DSU(n) total = 0 picked = [] for w, u, v in sorted(edges): if dsu.union(u, v): # 异阵营 成交 picked.append((u, v, w)) total += w if len(picked) == n - 1: break return picked, total # 不足n减1条则图不连通
三、复杂度拆解与 Prim 对比
Kruskal 的时间几乎全部花在排序上:"边数乘 log 边数";主循环里每条边一次 find、可能一次 union,都是近似常数。总账就是排序的账。空间为边集数组加并查集数组,线性。
| 维度 | Kruskal | Prim |
|---|---|---|
| 视角 | 全局:所有边一起排序 | 局部:树边界逐轮扩张 |
| 正确性依据 | 环性质(跳过成环边) | 切割性质(吸入横跨最小边) |
| 复杂度 | 边数乘 log 边数 | 平方 或 边数乘 log 点数 |
| 依赖结构 | 并查集 | 优先队列 |
| 适合形态 | 稀疏图 | 稠密图 |
| 不连通输出 | 天然得到生成森林 | 需检查覆盖数后报告 |
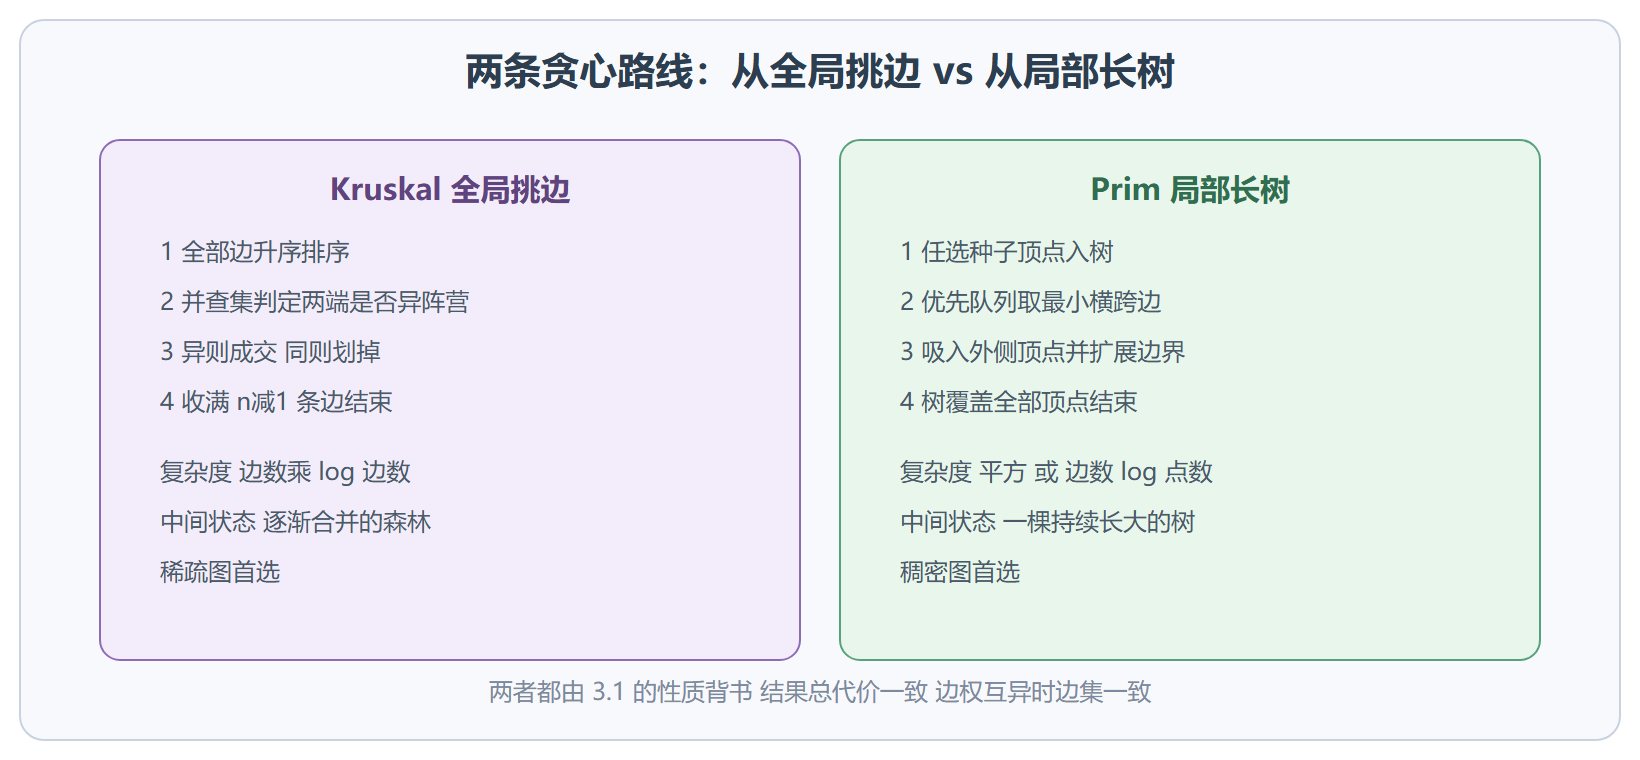
| 中间状态 | 若干互不相连的子树 | 始终是一棵连通的树 |
两个值得强调的细节:其一,Kruskal 的中间结果是"森林"——一堆逐渐长大的子树相互靠近最后拼合,而 Prim 的中间结果永远是单棵树;其二,图不连通时 Kruskal 会自然跑完所有边、产出"生成森林",无需特判,这个鲁棒性在预处理质量参差的数据时很实用。
Kruskal 与 Prim 的路线对比
⚠️ 常见坑:只写"按秩合并"不写"路径压缩"(或反之),复杂度保证就缺一半;更大的坑是 union 时忘了先 find 根、直接把代表元素挂接,阵营悄悄"分裂"。检验并查集写对了没有,最简单的办法是单元测试里反复随机 union 后 find 全量元素,核对代表一致。
💡 关键直觉:Kruskal 像"拍卖会"——最便宜的标的先出场,出价(权重)相同的谁先谁后无所谓;主持人的唯一问题是"这单买完会不会买重复的连通"(成环)。并查集就是这位主持人手里的登记簿,翻一页几乎不花时间。
四、深入一层:并查集的"均摊奇迹"与实用变体
并查集的复杂度"阿克曼反函数级"值得用一个直观说法翻译:哪怕全宇宙的原子数当元素个数,单次操作的均摊代价也不超过 5。这个均摊性质有个工程含义——单次操作可能偶尔较慢(树还较高时),但总代价被严格看管,适合"整体吞吐敏感、单次延迟不敏感"的批处理场景;反之,若你的服务要求"每次操作都有严格延迟上界",就要留意最坏情况的尖刺。
三个实用变体值得收藏。按大小合并:用"阵营人数"代替"树高"做合并依据,效果与按秩相当,且顺手维护了"每个阵营的规模"——求"连通块大小"时白拿。带权并查集:在边上附加"到父节点的距离/关系",find 压缩时同步累加,能回答"a 与 b 的相对距离"这类问题。可撤销并查集:不做路径压缩(改为按秩合并保证树高可控),就能用栈记录操作、逐条撤销——动态连通性的离线算法(如整体二分)靠它运转。
常见疑问解答
排序能用"桶"或"基数"再提速吗?
可以。边权是整数且范围可控时,基数排序把"边数乘 log 边数"压成近线性,Kruskal 总复杂度随之线性化——这是竞赛中处理百万级边图的标配组合。权为浮点或范围极大时,比较排序的 log 因子省不掉,也不必强求。
Kruskal 跑到一半能停下吗?
可以,且有两个有意义的停点:收满 n 减 1 条边(MST 完成,可提前终止);或"只关心权不超过某阈值的连通结构"(相当于单链接聚类到指定半径)。中途停止得到的森林本身就是有用的输出——这是 Kruskal 相对 Prim 的一个灵活性优势。
排序时权重并列的边,顺序影响结果吗?
可能影响"选哪一棵"(多解时不同的并列选择得到不同的最优树),但不影响总权。若业务要求确定性输出,给排序加上"次级键"(如边编号)即可固定行为。
为什么 Kruskal 不需要优先队列?
优先队列适合"边动态到来、反复取最小"的场景;Kruskal 一开始就拿到全部边、按序扫一遍就完——排序一次比维护堆更省。若你的边是流式到达或带权重更新,才需要重新考虑堆或"延迟排序"等结构。
动手实验:亲眼看森林拼合
把 Kruskal 的执行过程可视化:每轮成交后画出当前的森林(用不同颜色标阵营),你会看到若干小岛逐轮合并、成环的边被弹开,最后九个点收拢成一棵树。纸上画十轮不如代码里看一次——用一个简单的文本输出(每轮打印各点所属的代表元素)就能复现全过程。同图再跑一遍 Prim,对比两者最终选中的边集:总权必然相同,边集在权重互异时也相同,这份"殊途同归"的对照是理解两个算法共用一条定理的最佳注脚。
并查集的三分钟单元测试
给你的并查集配一份固定测试:随机生成一千次 union 与 find 混合操作,同时维护一个"暴力参照"(每次查询用 DFS 判连通),两边结果必须逐次一致。再单测路径压缩:连续 find 同一深层节点两次,第二次的遍历步数应显著少于第一次。这份小测试写一次防终身——并查集的 bug 几乎都藏在"代表元素漂移"和"压缩遗漏"这两个点上。
图很大但只关心"前若干小的连通结构"怎么办?
这是 Kruskal 的舒适区:排序后只扫前若干条边即停,得到"权重不超过阈值的连通结构"——聚类半径控制、 Communities 检测的粗筛都这么用。配合"提前终止在目标边数"或"终止在权重阈值",算法天然支持部分执行,这是 Prim 做不到的另一个维度。
本节速览
- 算法流程:边全量升序排序;逐条用并查集裁决;异阵营成交并合并;收满 n 减 1 条边即 MST。
- 正确性依据:跳过的边必与已选边成环且不小于环上其他边,环性质保证放弃无损。
- 并查集:find 加 union 两操作;路径压缩加按秩合并后单次近似常数。
- 复杂度:排序主导,边数乘 log 边数;空间线性。
- 与 Prim 分工:稀疏图 Kruskal、稠密图 Prim;Kruskal 天然输出森林,对不连通图更鲁棒。
- 中间状态差异:Kruskal 是"森林拼合",Prim 是"单树生长"——可视化调试时一眼可辨。
- 选型一致性:两算法结果总代价相同,边权互异时边集也相同,可互为交叉验证。
算法在手,下一章之前先把 MST 送进真实世界——电网、光缆、聚类、图像分割、基因组组装,看"最小连通"这个模型还能吃到多宽的应用面。