4.3 Ford-Fulkerson与Edmonds-Karp算法
4.3 Ford-Fulkerson 与 Edmonds-Karp 算法
本节摘要:Ford-Fulkerson 给出最大流的算法框架——在残存网络中反复寻找增广路径并沿瓶颈增广,直到无路可走,其正确性由最大流最小割定理背书;但它不规定"怎么找路",容量为无理数甚至整数时都可能收敛缓慢。Edmonds-Karp 把找路固定为 BFS(总选边数最少的增广路),使总复杂度稳定在"点数乘边数平方",是工程默认实现。本节给出完整代码骨架、收敛性分析、复杂度对比与实现陷阱清单。
核心问题
阅读完本节,你应当能够:
- 写出 Ford-Fulkerson 框架并说明终止时流必为最大流;
- 解释"选路策略决定收敛速度",举一个贪心选路吃亏的构造;
- 说明 Edmonds-Karp 的复杂度来源(增广轮数的上界);
- 用"残存容量成对更新"的正确姿势实现反向边;
- 落地时避开整数溢出、平行边、自环等典型陷阱。
一、从框架到实现:补上"怎么找路"
前两节已经备齐全部零件:残存网络给出调整空间(4.1),定理保证"无增广路即最大"(4.2)。Ford-Fulkerson 把它们串成循环:
def ford_fulkerson(cap, s, t): # cap 为容量矩阵 亦可改用邻接表加成对残存边 flow = 0 while True: found, path = find_path_in_residual(cap, s, t) # 策略可换 if not found: return flow # 无增广路 即最大 # 求瓶颈 bottleneck = min(cap[u][v] for u, v in path) for u, v in path: cap[u][v] -= bottleneck # 正向残存减少 cap[v][u] += bottleneck # 反向残存增加 关键一步 flow += bottleneck
框架本身只有四个动作:找路、算瓶颈、双向更新、累加。框架的空白是"find_path 怎么实现"——DFS、BFS、贪最宽路都合法,答案也都正确(定理兜底),差别只在"要跑多少轮"。
为什么选路策略能决定速度:想象一个"梯形"网络——源到 a、b 各 1,a、b 之间横着一条大容量边,a、b 到汇各 1。若第一轮恰好走"经横边的斜路",只送 1 单位还占用了中转通道;有反向边兜底仍能到达正确答案,但要多绕一轮"撤销"。更极端的构造里,每轮只增广 1 单位、总流量却高达百万,轮数随容量线性膨胀——当容量以数值方式输入时,Ford-Fulkerson 的复杂度与流量数值本身挂钩,这在算法复杂度意义上不算多项式。原始文集对其"效率较低、可能需要多次迭代"的批评正指于此。
二、Edmonds-Karp:把找路固定成 BFS
Edmonds-Karp 的全部改动是一句话:每轮用 BFS 找一条边数最少的增广路。就这么一换,轮数有了硬上界——"点数乘边数除二"级别,每轮 BFS 花"点数加边数",总复杂度即"点数乘边数的平方"。
轮数上界的直觉:可以证明每条边的"成为瓶颈"次数被点数约束——每轮增广后,源到各点的最短距离(按边数)单调不降,而一条边要再次成为瓶颈,两端点的距离层级必须至少抬升一次,层级至多 V 层。证明细节不必背,记住结论即可:选最短路增广,不会反复在同一个位置"拉锯"。前面梯形网络的例子里,BFS 会直接走两条两段式的直路,根本不碰中间横边,一轮不多跑。
实现上最稳妥的形态是成对边:邻接表中每条残存边都带一个"伙伴索引",指向反方向的边;增广时两边同步修改。这样不需要区分"原图的边"和"反向虚边",代码统一且不会漏更新。
| 维度 | Ford-Fulkerson 框架 | Edmonds-Karp |
|---|---|---|
| 找路策略 | 不规定 DFS或贪心均可 | 固定 BFS 最少边数 |
| 复杂度 | 与流量数值相关 理论可退化 | 点数乘边数平方 |
| 轮数保证 | 无 | 点数乘边数的一半级 |
| 实现难度 | 低 | 低 |
| 工程地位 | 教学框架 | 默认实现 |
| 进阶替代 | — | Dinic 单位容量更快 |
补充一句进阶坐标:Dinic 算法在 Edmonds-Karp 之上加"分层图加阻塞流",一般图更快、单位容量图上达到经典最优级别;费用流则在残存边上加价格,用最短路代替 BFS 选路。它们都以本节的概念为地基。
三、实现陷阱清单
- 反向边更新遗漏:只减正向忘了加反向,"反悔"机制失灵,结果偏小。用成对边结构可以从根上杜绝。
- 整数溢出:总流是各轮瓶颈之和,容量用 32 位整数存大网络时要升 64 位。
- 平行边:两点间多条边应各自独立维护残存(邻接表天然支持),合并成一条会丢失容量。
- 自环:对流无贡献,建图时直接过滤。
- 找不到汇点:BFS 打到残存网络源点可达集后顺手标记,即可同时输出最小割(4.2 的构造性读法)——建议把"最大流加最小割"做成一个接口一起返回。
算法执行过程全景
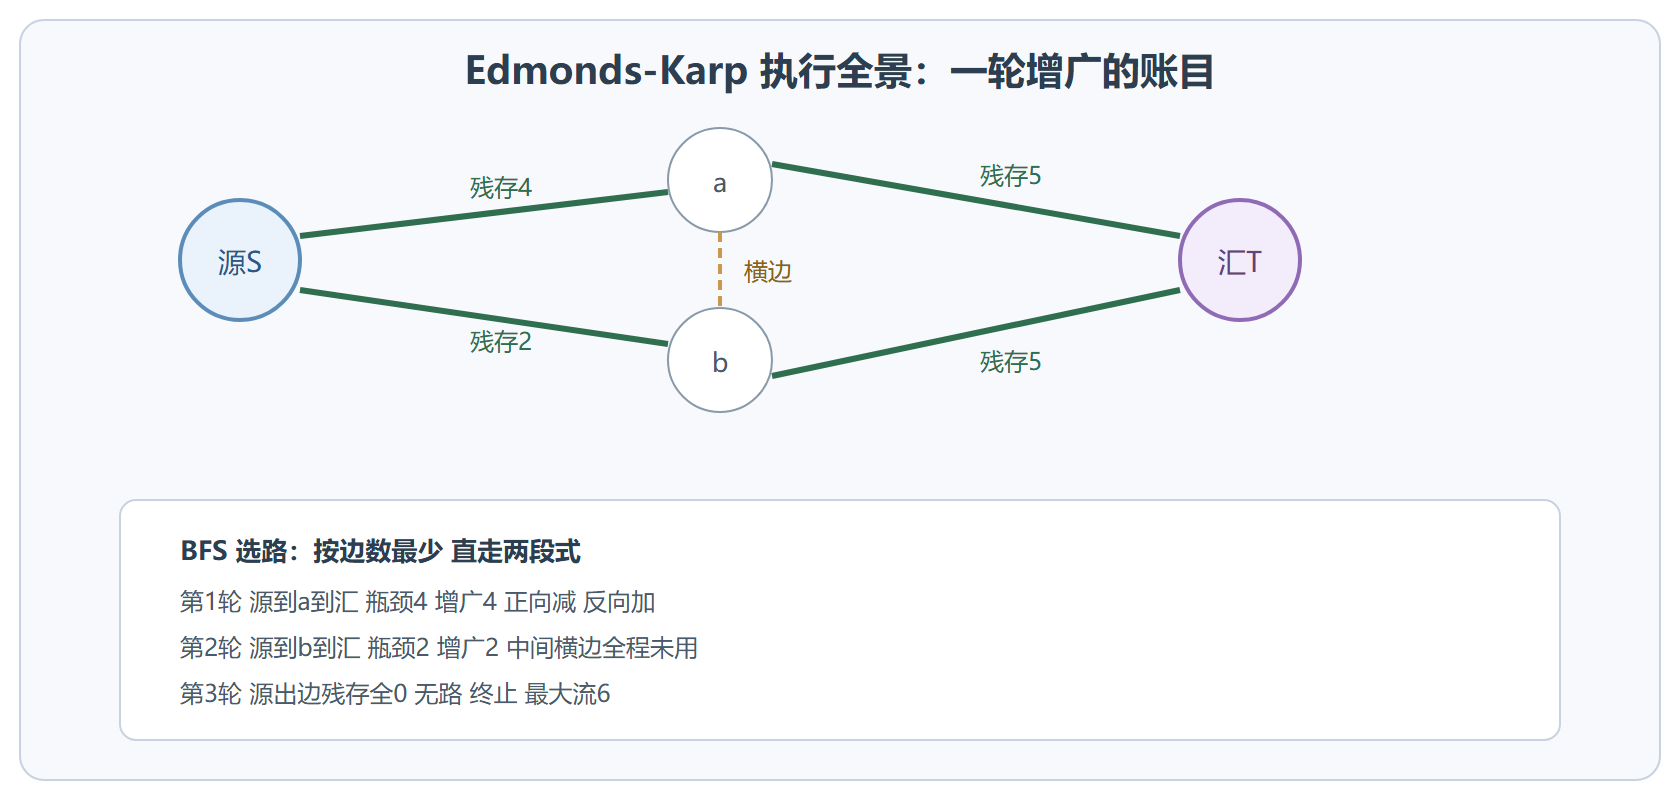
⚠️ 常见坑:在残存网络里用 DFS 找路并自以为"反正都会收敛"。答案确实对,但轮数不受控——遇到大容量数值或刁钻结构会慢到不可用。线上服务一律 BFS 起步,规模再大换 Dinic。
💡 关键直觉:Ford-Fulkerson 是"合同法"(允许签了再改),Edmonds-Karp 是"就近原则"(每次只改离目标最近的合同)。就近改合同看似保守,却避免了在横边上反复签了又撤的拉锯——多项式复杂度就省在这里。
四、深入一层:Dinic 与"选路哲学"
Edmonds-Karp 把选路定为"边数最少",Dinic 再往前一步:先 BFS 分层(每个点标上到源的最少边数),再在分层图内沿"层数递增"的方向做 DFS,一口气推完多条增广(阻塞流),然后重新分层。一般图的复杂度是"点数平方乘边数",单位容量图上更能达到"边数乘根号点数"的经典界。选型梯度因此清晰:教学与小规模用 Edmonds-Karp,竞赛与中等规模用 Dinic,超大或特殊结构再上专用算法(预流推进、匹配专用)。
把三种选路策略并排看,"选路哲学"一目了然:Ford-Fulkerson 随缘(框架不管)、Edmonds-Karp 求短(避免绕远拉锯)、Dinic 分层成批(把同方向的路一起走完)。这与快速排序里"选基准"的谱系(随机、三数取中、内向排序切换)异曲同工——同一框架下,调度策略的演进就是算法史的主线。
常见疑问解答
容量全是小整数时,Ford-Fulkerson 的轮数为什么可控?
每轮增广至少推进 1 单位流量(瓶颈是整数),总轮数不超过最大流值本身。于是"容量是 1 或 2"的图(比如二分图匹配,源汇侧容量全 1)上,DFS 版 Ford-Fulkerson 反而简洁够用。它的恶名只在大容量数值与无理数的构造性反例上成立。
Edmonds-Karp 的 BFS 要每次从头跑吗?
是的,每轮增广后残存网络都变了,上一轮的分层信息作废(这也是 Dinic 的改进点:一批增广共用一次分层)。别试图缓存路径复用——失效路径推流会违反容量约束。
增广路径的"瓶颈"记录成流之后,怎么还原每条边的实际流量?
维护一个"流矩阵"或在成对边上记"已用容量":增广时正向加、反向减。算法结束时,每条原网络边的净流量就是正向已用减去反向已用(非负)。校验时用 4.1 的两条铁律过一遍,任何违例都是实现 bug。
最大流算法是"增量友好"的吗?
不友好。容量变化或加边后,从旧流出发的再增广虽然可行(残存网络按新容量重建),但缺少保证收敛轮数的增量理论;实务上通常直接重跑,或用"退流"技巧做局部修复。高频变更场景要在架构层面考虑缓存与批量重算。
动手实验:DFS 与 BFS 选路的正面对决
写一个允许自定义找路策略的最大流框架,分别接 DFS 与 BFS。构造那个经典的"梯形反例"(源到 a 与 b 各一个大容量、中间一条容量 1 的横边、a 与 b 到汇各一个大容量),交替观察两种策略的增广轮数:DFS 版会反复经过横边做"进二退一"式的拉锯,轮数随容量增长;BFS 版两轮结束。再把容量改成单位 1,两者轮数趋同。这个实验把"选路策略决定收敛速度"从结论变成眼见为实,也解释了为什么框架正确性免费、性能却要靠策略挣。
实现自检清单
上线一个 Edmonds-Karp 实现前过一遍:成对边的索引是否互指正确(反例测试:单边网络增广后能否"撤销");容量类型是否足够宽(总流是各轮瓶颈之和);BFS 是否在残存容量为零的边上正确止步;终止后是否输出最小割;结果是否通过 4.1 节的合法性校验函数。五项全绿,这个实现基本可以在生产环境安家。
怎么向非技术同事解释这个算法?
一个三句话版本:网络像一张水管图,我们先随便找一条能通的路把水送过去;每送一次就更新"每段管还剩多少、能退回多少"的账本,再找下一条;账本上再也找不出能通的路时,送出的总量就是极限,而"最后被卡住的那排管子"就是该扩容的地方。三句话分别对应增广、残存网络、最小割——技术内核与通俗叙事一一对应,这也是检验自己是否真懂的一个标尺。
要点速记
- 框架四动作:找增广路、算瓶颈、双向更新残存、累加流;无路可走时由定理保证已达最大。
- 策略空白:框架不规定找路方式,正确性无虞,速度天差地别。
- 退化风险:选路不当时轮数可与容量数值挂钩,复杂度意义上非多项式。
- Edmonds-Karp:固定 BFS 选最少边数的增广路,轮数上界"点数乘边数一半",总复杂度"点数乘边数平方"。
- 最短距离单调性:BFS 选路让源到各点的边数距离不降,是轮数上界的核心引理。
- 实现姿势:成对边结构同步更新正反残存;防溢出、拆平行边、滤自环。
- 一鱼两吃:终止后的可达标记顺手产出最小割,建议接口同时返回。
算法闭环之后,最后一节把最大流放归现实——任务分配、交通调度、网络资源,以及多源多汇与节点容量的建模变体。