4.4 最大流的应用与扩展
4.4 最大流的应用与扩展
本节摘要:最大流的落地远不止"管网送水"。二分图匹配(任务分配、人员排班)通过"源到左部容量 1、右部到汇容量 1"的转化成为最大流的特例;交通调度、网络流量管理、资源分配共享同一套容量建模。扩展方向上,多源多汇用超级源汇归一、节点容量用拆点处理、带费用的输送问题引出最小费用最大流。本节覆盖这些转化的"套路清单"与建模陷阱。
本节地图
阅读完本节,你应当能够:
- 把二分图匹配问题转译成流网络,并说明两侧容量设 1 的理由;
- 用超级源点、超级汇点、拆点三个套路改造非常规网络;
- 识别最大流模型的适用边界与失败信号;
- 了解最小费用最大流等进阶方向的入口。
一、经典应用:从送水到送任务
二分图匹配是最大流最经典的转化。场景:n 个任务、m 个工程师,每人只会其中若干任务,一人一岗,最多能同时安排多少任务?把任务放左部、工程师放右部,"会做"连边;再补一个超级源点连向所有任务(容量 1)、所有工程师连向超级汇点(容量 1)。容量 1 表达"一岗一人、一人一岗"的硬约束,于是任何可行流都对应一个匹配(每条经任务的流至多 1 单位),最大流即最大匹配。
这个转化的价值在于复用:Edmonds-Karp 直接拿来就能算匹配,还能顺便输出"哪些任务没被匹配、卡在哪个割上"。原始文集列举的其他场景同构性都很高——交通流量控制(路口通行能力为容量,求不超载的最大疏散量)、网络流量管理(链路带宽为容量,评估源到宿的最大吞吐)、资源分配(机器加工能力为容量)。共同语法:"每条通道有上限、总量越大越好、中途不生不灭"——三条全中,就往最大流上靠。
二、三个改造套路
真实需求很少长得像教科书,三个固定套路能覆盖绝大多数变体:
超级源汇(多源多汇):有多个产地、多个销地?新建一个超级源点向每个产地连"产能容量"的边,每个销地向超级汇点连"需求容量"的边,原网络夹在中间。多源多汇瞬间归一为标准形。
拆点(节点容量):限制不在边而在点——比如中转仓库最多囤 100 单位。把该点拆成"入点"与"出点",中间连一条容量 100 的内部边,所有入边接到入点、出边从出点出发。节点约束就变成了边约束。
取反(必经或损耗):某些边"必须流过"?给它连一条容量下界的边(转化为标准形需补"盈余调整"技巧);带损耗的通道可按比例衰减——不过这些已滑向更专门的流量下界与广义流问题,建模时先确认是否真的需要。
| 套路 | 场景 | 改造 | 备注 |
|---|---|---|---|
| 超级源汇 | 多产地多销地 | 新源连产地 新汇连销地 | 最常用 一学就会 |
| 拆点 | 中转点有容量上限 | 一点变两点 中连容量边 | 也用于分层限制 |
| 成对反向 | 需要"撤销"语义 | 残存机制天然支持 | 算法内置 |
| 容量下界 | 某边必须至少流 x | 补超级点做盈亏平衡 | 进阶 慎用 |
三、建模边界与失败信号
最大流不是万金油。三问不满足时要换模型:目标不是"总量最大"而是"成本最小"(转最短路或最小费用流);流量守恒不成立(可在中途产生消耗——转广义流或仿真);约束是组合互斥而非容量(往往是图着色或整数规划类难题)。
即便模型对路,也有两个实操层面的问题值得记录在案。其一,规模敏感:点边数千级 Edmonds-Karp 游刃有余;上万级就应换 Dinic 或专门的匹配算法(如 Hopcroft-Karp,匹配场景比通用流快一个档)。其二,数据噪声:容量来自测量(如带宽探测)时,微小扰动可能让最大流值跳变——对结果做鲁棒性分析比精算更重要。原始文集把这类讨论归入"最大流算法的局限性与改进",并指出并行化处理与更高效的增广策略是主流改进方向;而"未来发展趋势"一节则指向了更大规模网络下的算法工程化——这两个判断与今天大规模图计算的实践吻合。
四、进阶入口:费用流与匹配加速
最小费用最大流:在"流最大"之外再问"在最大流里,哪 个总运费最省"。做法是把 BFS 选路换成"按费用跑最短路"(边权可负时配 Bellman-Ford 或 SPFA——第 2 章的算法在这里返场)。物流、通信里"既要多送又要便宜"的需求都落在这个模型上。
匹配加速:纯匹配问题可用 Hopcroft-Karp,复杂度"边数乘根号点数",比通用最大流跑匹配更快。选择逻辑:问题只是匹配、规模大,专用算法;问题还有其他容量约束,留在通用流框架内。
模型选择速查: 只要最大总量 → 最大流 Edmonds-Karp 最大总量加最小费用 → 最小费用最大流 纯二分图匹配且规模大 → Hopcroft-Karp 需要最小割诊断瓶颈 → 任意最大流算法加可达标记
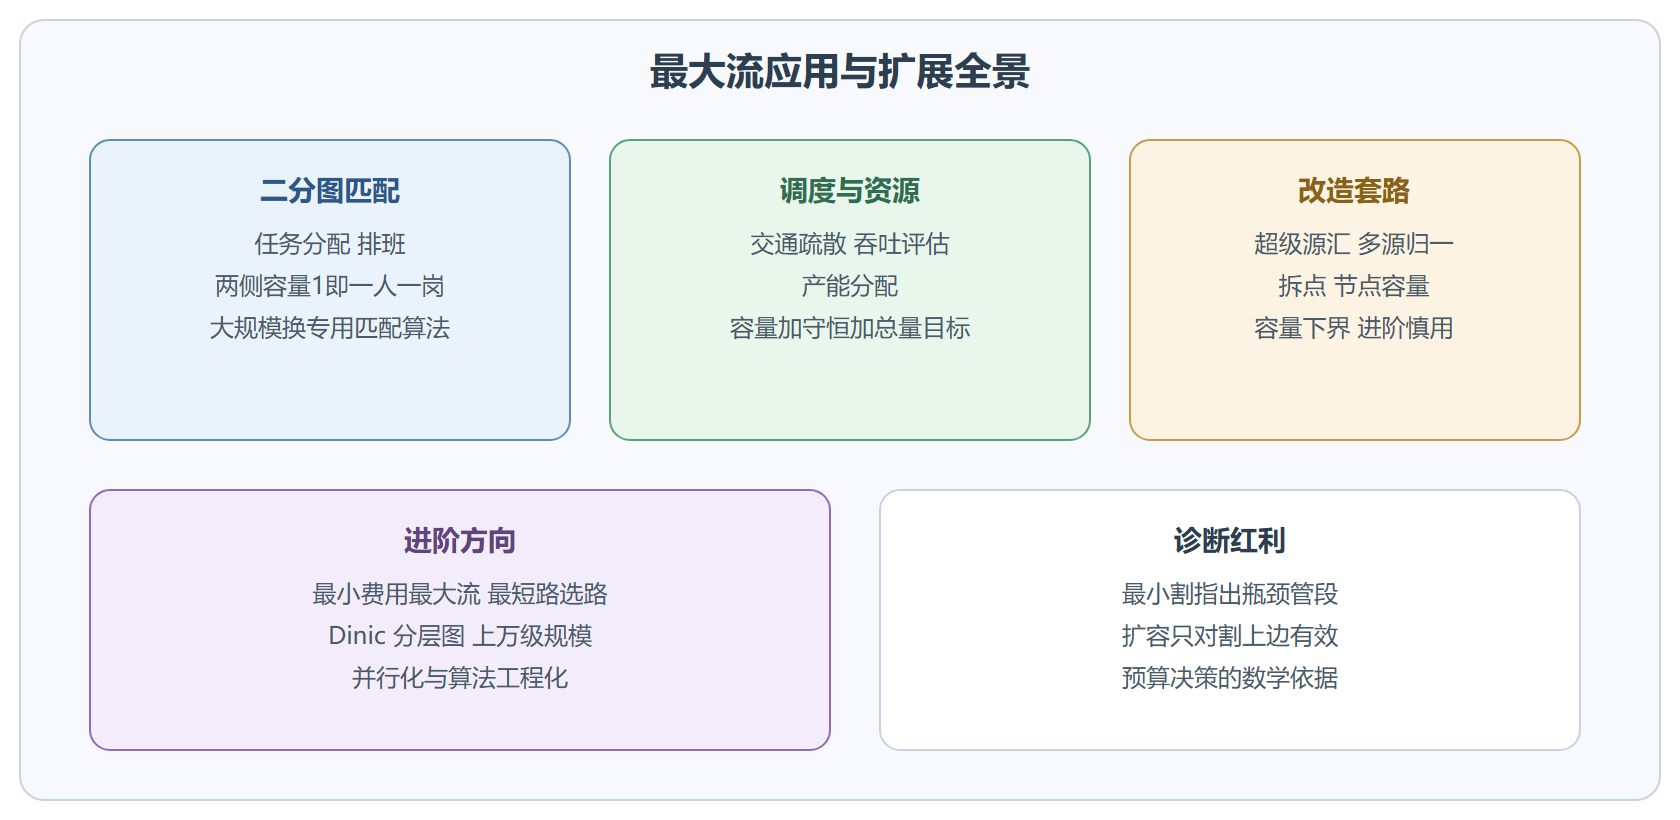
应用与扩展全景
⚠️ 常见坑:把"最短路径式"的诉求硬塞给最大流。求"单件货从产地到销地最便宜走一条路"是最短路;求"整批货最多送多少、走法可分摊"才是最大流。混用两者的典型症状是结果数值"看起来合理但偏小/偏大"——用小规模手算交叉验证能快速暴露。
💡 关键直觉:最大流建模像接线配电板——超级源是总闸,超级汇是总负载,中间每条接线有保险丝(容量)。三个套路(超级源汇、拆点、成对边)就是三种改线手法,掌握后 90% 的变体题目都是"换皮不改骨"。
常见疑问解答
怎么快速判断一个问题"不是"流模型?
三个否定信号任占其一就要警惕:目标不是单一总量(比如要求每条路径都均衡——那是多目标或公平分配问题);中间点可以生成或销毁流量(守恒破坏——考虑广义流或直接仿真);约束是"互斥选择"而非容量(比如两个任务抢同一时间段——更接近图着色或整数规划)。硬套流模型跑出"看似合理"的错误答案,比报错更危险。
二分图匹配的流模型里,中间那些"会做"的边容量设多少?
设为足够大的值(或 1 即可,因为两侧的 1 已经限流)。瓶颈永远在源汇两侧的容量 1 上,中间边的容量只要不小于 1 就不影响结果。这是"约束放在哪一侧"的典型技巧:把语义约束放在源汇边,中间边只表达"允许"。
最小费用最大流和"最大流里挑最省"是一回事吗?
是同一件事的两种说法:先保证流值最大,再在所有最大流中选总费用最小。实现上用"按费用找最短路"替代 BFS 增广,边费用可负时配 Bellman-Ford 或 SPFA(第 2 章返场)。注意它与"最小费用任意流"(不要求最大)不同——后者允许少送一点换更低费用,模型又要另建。
跑最大流前要做哪些数据预处理?
三件常规事:过滤自环与容量为零的边(无贡献、白占内存);合并平行边(或确认实现支持);校验容量非负。另外建议保留"原始容量"副本——残存更新会覆盖工作副本,诊断时经常要对照原始值。
动手实验:把排班问题送进流水线
完整走一遍转化:五个任务、四个工程师、每个任务有候选集,目标是最大化同时安排数。第一步画二分图(任务在左、工程师在右、会做连边);第二步补超级源汇、两侧容量设 1;第三步跑 Edmonds-Karp 得最大匹配数;第四步在残存网络上做可达标记,读出最小割——左侧未被匹配的任务与右侧被匹配的工程师的分布,会告诉你"卡在人手还是卡在技能面"。四步总共三十行代码,做完你就拥有了一个可复用的排班内核,换数据即换业务。
建模错题本的三条高频记录
实际项目里最常翻车的三条:把"两人不能同时上同一班"建成图的边(应为约束而非连接,模型选错族);容量设了小数导致增广轮数失控(容量应整数化或换容忍浮点的实现);超级源的边容量误设为无穷大导致"单人接多任务"(应设为 1,约束的语义全在源汇边上)。把这三条贴在显示器边框上,能挡下一半的流模型返工。
流模型的答案"稳定"吗?改一条容量会怎样?
取决于改的是哪条边:改在最小割上,最大流通常随之变化;改在松约束上,答案纹丝不动。这个"稳定性结构"可以反过来用——对容量做扰动实验,观察流值是否敏感,就能低成本地识别出"哪些边是关键路径"。相比正式的灵敏度分析,这种蒙特卡洛式的抖动测试在工程上便宜得多,也直观得多。
一节小结
- 判定三问:通道有上限、中途不生不灭、总量越大越好——三中即最大流模型。
- 匹配转化:源到左部容量 1、右部到汇容量 1,最大流等于最大匹配;大规模用专用匹配算法。
- 改造套路:多源多汇加超级源汇;节点容量用拆点;特殊需求再考虑容量下界等进阶形式。
- 诊断红利:最小割指出瓶颈,扩容决策只对割上边有效。
- 模型边界:目标非总量、守恒不成立、约束为组合互斥时,换模型别硬套。
- 进阶入口:最小费用最大流(最短路选路)、Dinic(更大规模)、并行化与工程化(发展趋势)。
- 交叉验证习惯:小规模手算加容量守恒断言,是流模型上线前的两道保险。
三大问题至此全部闭环。最后一章回到算法本身——优先队列与并查集的实现细节、复杂度驱动的优化路径,以及导航、社交、物流、推荐里的综合实战。