5.2 性能优化与复杂度分析
5.2 性能优化与复杂度分析
本节摘要:复杂度分析用"随规模增长的速度"刻画算法代价,是选型与优化的导航仪。本节先讲时间与空间复杂度的读法与分析意义,再给出四条优化路径(数据结构、算法改进、并行化、空间优化),最后以 Dijkstra 的三档实现——朴素数组的点数平方、二叉堆的边数乘 log 点数、斐波那契堆的理论更优——做完整解剖,展示"理论优雅"与"工程实用"如何分道扬镳。
本节导航
阅读完本节,你应当能够:
- 读出常见复杂度级别的优劣排序,并做数量级估算;
- 按四条路径为慢代码制定优化方案;
- 复述 Dijkstra 三档实现的结构差异与复杂度推导;
- 用"复杂度选型 + 常数与实测"的双重视角做工程决策。
一、复杂度:增长速度的语言
时间复杂度回答"输入规模翻倍,耗时翻几倍":线性翻倍;"n log n"略超翻倍;平方翻四倍;立方翻八倍。数量级直觉值得内化——100 万顶点的图,线性算法约百万次操作(毫秒级),"n log n"约两千万次(几十毫秒),平方级是万亿级操作(小时起步),立方级直接不可行。复杂度差一个档位,机器再快也救不回来。
空间复杂度同理:Floyd-Warshall 的距离矩阵是平方级内存,百万顶点需要 TB 级数组——纵然时间可忍,空间先宣判死刑。分析的意义正在于此:写代码之前先算复杂度,等于上线之前先做容量规划。原始文集把这一节的意义总结为三句话:选对算法、指导优化方向、避开复杂度陷阱——顺序即工作流。
各章主算法的复杂度速查(表):
| 算法 | 时间复杂度 | 空间 | 主导瓶颈 |
|---|---|---|---|
| BFS 或 DFS | 点数加边数 | 线性 | 遍历本身 |
| Dijkstra 朴素 | 点数平方 | 线性 | 找最小的线性扫 |
| Dijkstra 二叉堆 | 边数乘 log 点数 | 线性 | 堆操作 |
| Dijkstra 斐波那契堆 | 边数加 点数 log 点数 | 线性 | 降键的摊还 |
| Bellman-Ford | 点数乘边数 | 线性 | 全量重复松弛 |
| Floyd-Warshall | 点数立方 | 点数平方 | 距离矩阵 |
| Kruskal | 边数乘 log 边数 | 线性 | 排序 |
| Prim 堆版 | 边数乘 log 点数 | 线性 | 堆操作 |
| Edmonds-Karp | 点数乘边数平方 | 线性 | 增广轮数 |
二、四条优化路径
路径一:数据结构换挡。瓶颈若是"反复线性找最小",换堆;"反复全量判连通",换并查集。5.1 节的全部内容就是为这条路径服务的。识别信号:内层循环里出现"扫描全部候选挑一个"的模式。
路径二:算法改进。换复杂度档位更低的算法或加预处理:提前终止的 Bellman-Ford、拓扑序的 DAG 特例、双向搜索、A 星启发式——都是"利用额外结构或信息换时间"。
路径三:并行化。图算法天然有局部并行性(各起点的 Dijkstra 互不依赖、松弛可按边分片),分布式图计算框架把大图切分到多机。代价是通信与负载均衡,适合规模确实到了单机极限的场景。
路径四:空间优化。距离矩阵改滚动数组、visited 用位图压缩、邻接表用 CSR 紧凑编码——内存带宽常是图算法的真实瓶颈,压缩访存有时比换算法更见效。
三、解剖标本:Dijkstra 的三档实现
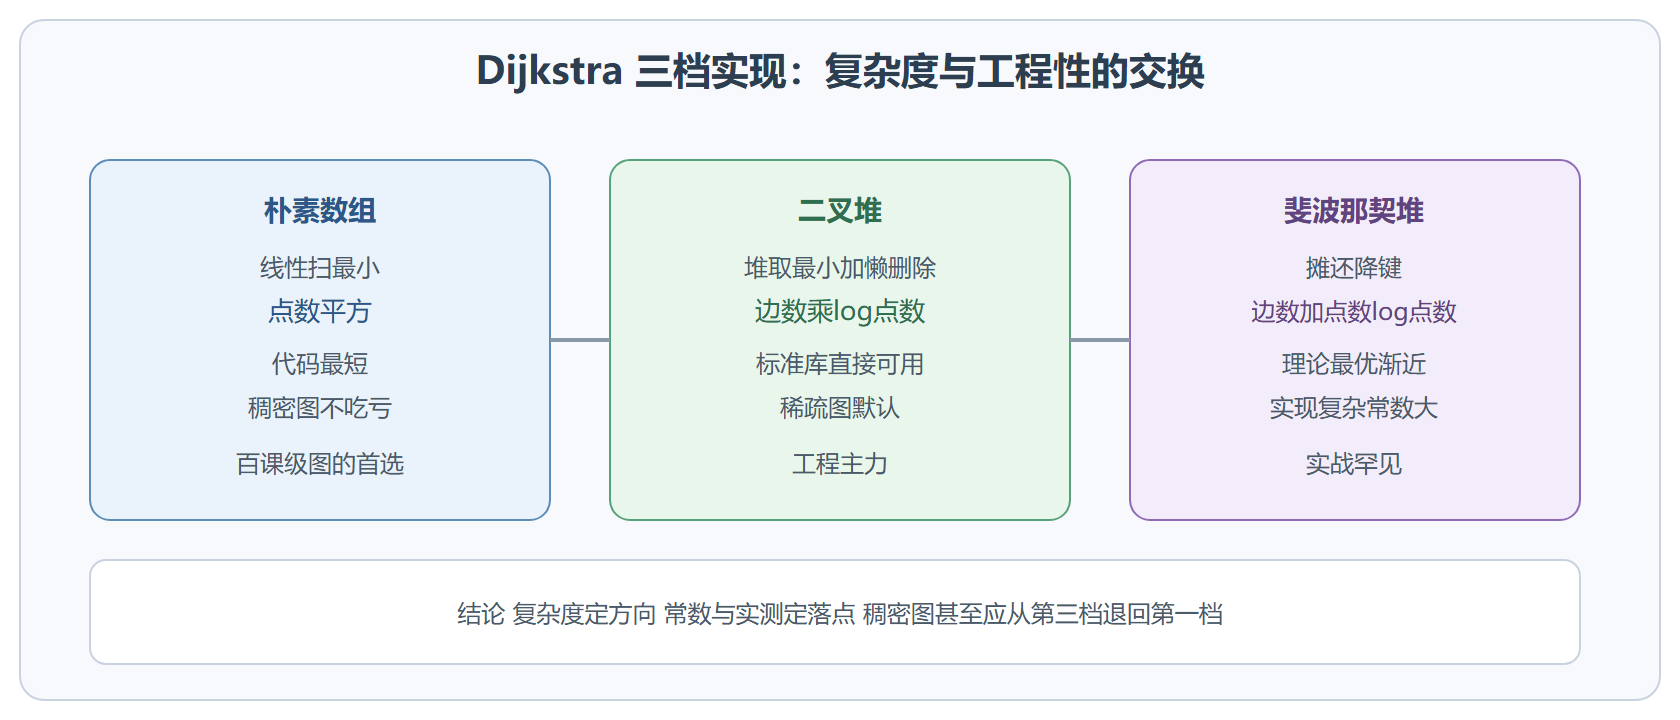
第一档:朴素数组。距离存数组,每轮扫全数组找未确定的最小点。找最小是"点数次乘 log 1",总代价点数平方。原始文集给出的代码骨架正是这一版(线性扫 min_node 的循环)。
def dijkstra_naive(graph, start): distances = {node: float('inf') for node in graph} distances[start] = 0 visited = set() while len(visited) < len(graph): min_node, min_d = None, float('inf') for node in graph: # 线性扫最小 if node not in visited and distances[node] < min_d: min_node, min_d = node, distances[node] if min_node is None: break visited.add(min_node) for neighbor, weight in graph[min_node]: if min_d + weight < distances[neighbor]: distances[neighbor] = min_d + weight return distances
第二档:二叉堆加懒删除。找最小交给堆,每次对数级;主循环由"点数轮、每轮全扫"变为"至多边数轮、每轮 log 级",总代价"边数乘 log 点数"。原始文集的堆版代码与本教程 2.1 节的实现一致——弹堆后先比对账面距离再决定是否处理,就是懒删除。
第三档:斐波那契堆。支持真正意义的降键且摊还代价低,把复杂度压到"边数加 点数乘 log 点数"——理论上逼近 Dijkstra 的最优。但原始文集的评价一针见血:实现复杂、常数因子大,实际应用中可能不如二叉堆高效。理论与工程在此分道扬镳:复杂度分析告诉我们"渐近上界",常数与缓存友好度决定"真实秒数"。
三档的选型结论:
| 档位 | 复杂度 | 工程评价 |
|---|---|---|
| 朴素数组 | 点数平方 | 稠密图不输堆 代码最短 |
| 二叉堆 | 边数乘 log 点数 | 稀疏图默认 内置库即得 |
| 斐波那契堆 | 边数加 点数 log 点数 | 理论优美 常数吃亏 实战罕见 |
这组对比传递的方法论比结论本身更重要:优化决策 = 复杂度定方向 + 常数与实测定落点。复杂度同档的两个实现,跑分差 3 到 10 倍是家常便饭(缓存局部性、分支预测、语言运行时都在掺和),所以"按复杂度选完算法,再拿真实数据跑一次基准"才是完整流程。原始文集同样强调在不同规模、不同稀疏度的图上对比两版 Dijkstra——通常堆版在稀疏图上明显占优,而这正是真实路网、社交网的形态。
三档实现演化时间线
⚠️ 常见坑:把复杂度当唯一准绳。复杂度同档的两个实现,实测差数倍很正常;更隐蔽的是"更高档结构在特定数据分布下反而更慢"(堆版 Dijkstra 在稠密图上的翻车)。任何优化承诺都要用目标规模的真实数据回测。
💡 关键直觉:复杂度是"斜率",常数是"截距"。规模小时截距主导、朴素方法舒服;规模大时斜率定生死。优化前先估算目标规模落在哪一段,免得为不存在的规模提前付费。
常见疑问解答
复杂度分析显示已经最优,还能再快吗?
能,优化空间换到了常数层:缓存友好布局(数组化、紧凑编码)、减少分支与函数调用、批量化相邻操作、选更贴近硬件的实现语言或 SIMD。经验上复杂度同档的实现之间 3 到 10 倍差距很常见——这部分收益不上复杂度账本,只上秒表。
怎么设计公平的基准测试?
三个要领:固定随机种子保证可复现;用多组不同规模(数量级递增)与不同形态(稠密、稀疏、链状)的数据,别只测一种;预热后多次取中位数,剔除抖动。测出来的"交叉点"(如朴素版与堆版 Dijkstra 的反转点)是选型的黄金数据,比任何理论推导都有说服力。
空间优化会不会反而拖慢时间?
可能。位图压缩省内存但增解码开销;滚动数组破坏访问局部性。空间与时间的交换没有免费午餐,改完必须回测时间。一个例外是"压缩反而变快"——内存带宽紧张时(图算法常见),减少访存量直接提速。
什么时候该停止优化?
三个止损信号:当前耗时已满足需求一个数量级以上;瓶颈已转移到算法之外(网络、磁盘、下游服务);进一步优化需要引入显著复杂度(自研堆、多线程改造)而收益预估不足两倍。性能工程的纪律在于知道在哪里停,而不只在于跑得多快。
动手实验:一次完整的优化闭环
选一个跑得慢的 Dijkstra 服务(或自己造一个百万边的),走一遍标准闭环:先量——记录耗时分布与图形态,确认瓶颈在"找最小"的线性扫描;再换——切到堆优化,复杂度降档;后测——同数据集重跑,记录加速比;最后审视——压测发现堆条目中过期比例高达九成,进一步用"降键索引堆"或减小入堆频率再抠一档常数。四步走完,"剖析、换挡、回测、抠常数"的流程就从方法论变成肌肉记忆。多数性能问题不需要天赋,需要的是这样一套可重复的流程。
复杂度的口头翻译练习
拿本节的速查表做三分钟口头练习:随机指一个算法,用一句话说出它的复杂度与主导瓶颈("Kruskal 是边数乘 log 边数,账几乎全在排序上")。能流畅翻译十个,面试里任何复杂度追问都不再是威胁——因为你要说的不是背诵结果,而是推导路径。
大数据规模下"内存放不下图"的复杂度还成立吗?
复杂度刻画的是计算量,不刻画通信量——分布式场景里,跨机搬一份数据可能比本地算一百步还贵。此时要引入"通信复杂度"的视角:算法总计算量照旧成立,但真实耗时被网络带宽与分区策略主导。这也是 5.3 节反复强调"先确认是否真需要分布式"的原因:它不是优化的延伸,而是另一个成本结构的开始。
重点提炼
- 复杂度的意义:写码前算复杂度等于上线前做容量规划;差一个档位,硬件救不回。
- 空间同样致命:Floyd 的平方级矩阵在百万顶点上先死于内存而非时间。
- 四条优化路径:结构换挡、算法改进、并行化、空间优化——按瓶颈类型对号入座。
- 三档 Dijkstra:朴素平方、二叉堆"边数 log 点数"、斐波那契堆理论更优但常数吃亏。
- 稠密图反转:边数接近平方级时朴素版反超堆版,选型要看图的形态。
- 双重视角:复杂度定方向,常数与实测定落点;优化承诺必须用真实数据回测。
- 方法论迁移:这套"剖析瓶颈—选路径—回测"的流程适用于一切性能工程,不限于图算法。
万事俱备。最后一节把三大算法族拉进导航、社交、物流、电路与推荐五个战场,完成从模型到生产的全链路演练。