5.3 典型应用场景:导航、社交与物流
5.3 典型应用场景:导航、社交与物流
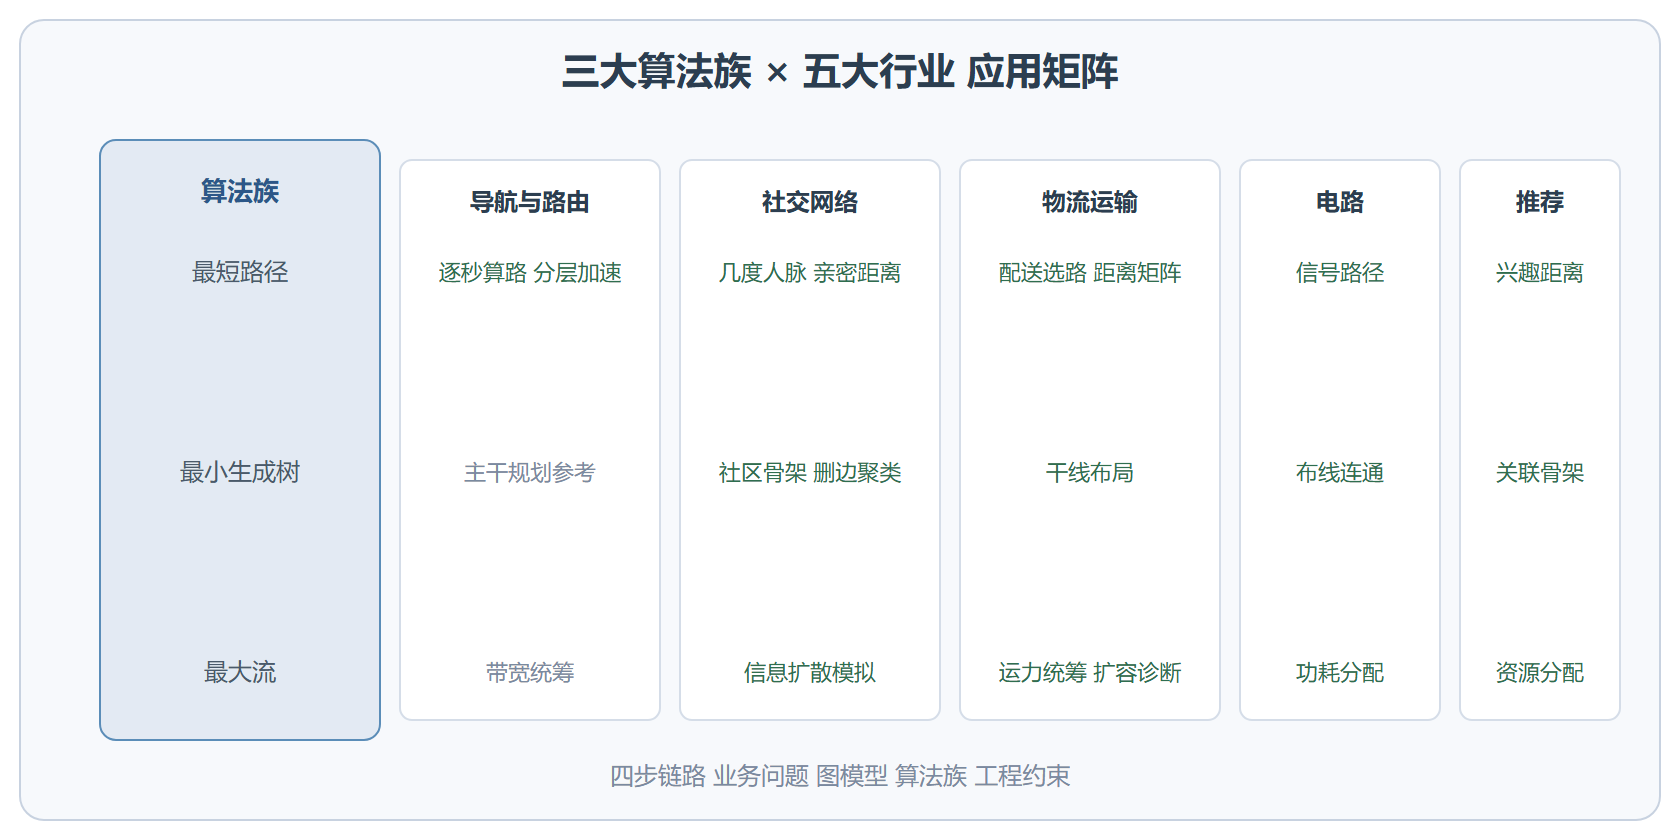
本节摘要:三大算法族在真实产业中各就各位:导航与网络路由靠最短路径(Dijkstra 及其工程变体)逐秒算路;社交网络用最短路径度量"几度人脉"、用最小生成树构建社区骨架、用最大流模拟信息扩散;物流配送同时消费三族算法——配送选路用最短路、仓储骨干用生成树、运力统筹用最大流;电路设计优化信号路径与布局;推荐系统用图距离挖掘兴趣、用关联骨架组织商品、用流模型做资源分配。本节按行业逐个拆解"业务问题—图模型—算法—工程约束"的完整链路。
读前必看(上)
阅读完本节,你应当能够:
- 为五个行业的问题选择正确的算法族并说明理由;
- 识别真实场景中"教科书模型"需要的改造(分层、近似、增量);
- 用统一的四步链路(业务—模型—算法—约束)分析任何新的图问题。
一、导航与网络路由:最短路径的主场
地图导航是 Dijkstra 的招牌场景:路口为顶点、道路为边,权重可以是距离、预计耗时或加权代价。工程改造有三板斧:其一,分层路网——把高速路网与地方路网分层,长途查询先在高层粗定位再下钻,避免在全国图上裸跑 Dijkstra;其二,代价函数动态化——实时路况让边权随时间波动,需要增量重算或定期刷新;其三,预处理加速——收缩层级、终点带(ALT)等技术预计算部分信息,把在线查询压到毫秒级。这些变体的共同底座仍是 2.1 节的贪心与堆优化。
网络路由同构:路由器为顶点、链路为边,权重可取延迟或跳数。选路协议(如链路状态一类)在每台路由器上维护全网拓扑并独立跑最短路——这正是"分布式的 Dijkstra"。与导航的差别在约束:链路权重的震荡会引发路由抖动,工程上要做平滑与迟滞。
原始文集把导航称为"幕后英雄",一个值得回味的细节是:用户看到的"推荐路线"未必是数学最优——系统常在最优解附近生成若干条差异明显的候选(收费少一条、转弯少一条),把最终选择权交还用户。算法给出最优,产品运营最优的邻域。
二、社交网络:三族算法的联合应用
最短路径量"关系距离":"六度人脉"本质是无权图上两点间的最少边数——大规模图上用 BFS 的双向变体在线查询;带互动权重的"亲密度距离"则是带权最短路。最小生成树构"社区骨架":以互动强度为边权,MST 及其删边聚类给出社区的粗粒度划分,作为社区发现的快速预处理或冷启动方案;原始文集还提到用生成树构建"信息传播的主干道"——消息沿骨架推送,控制冗余。最大流演"信息扩散":把用户间的转发意愿建模为容量,最大流估算一条话题从种子用户出发最多能"冲刷"到多少人;配合 4.2 节的最小割,还能定位"哪个圈层是传播的瓶颈"。
社交场景的特殊工程约束:图规模巨大(十亿顶点)、增量变化频繁(好友关系随时增删)。离线预计算加在线增量修正是常态,纯粹的每次全量重算不可行。
三、物流与运输:三族算法的一体化
物流是三族算法协同的最典型行业。配送选路:每辆车的行程是"多点途经"的最短路组合(点数多时退化为经典的巡回商问题近似——但任意两仓两站间的距离矩阵仍靠全源最短路预计算,正是 2.3 节 Floyd 或 Johnson 的用武之地)。仓储骨干:区域仓之间的干线布局要"全连通且总成本最小"——最小生成树的原型题;再按可靠性需求"树加环"。运力统筹:仓库到门店的运力受每条线路车辆数上限约束,"最多能发多少货"就是最大流;最小割指出"加哪条线的车才能真正扩量"。
| 环节 | 问题 | 算法族 | 关键约束 |
|---|---|---|---|
| 干线布局 | 全连通最小成本 | 最小生成树 | 可靠性加环 |
| 距离矩阵 | 全源两两距离 | Floyd 或 Johnson | 稠密与稀疏之分 |
| 配送选路 | 多点途经排序 | 最短路加组合近似 | 时效窗 |
| 运力统筹 | 线路容量下总量最大 | 最大流 | 最小割诊断瓶颈 |
电路设计是另一个三族合用的领域:信号传输路径优化(时延为权重的最短路)、电路布线的最小成本连通(生成树)、功耗与电流分配的容量规划(流模型)——原始文集对这三点均有对应论述。推荐系统同样如此:图距离挖掘用户兴趣相似性、商品关联网络用骨架组织类目、资源分配(曝光预算、库存)用流模型统筹——一套图算法课本支撑了看似不相干的多个行业。
四、统一链路与选型演练
五个行业归纳下来,分析任何图问题的链路都是四步:
最后一格的"工程约束"往往才是真正的决策点:规模决定复杂度档位(第 5.2 节);时效决定能否离线预计算;增量变化决定维护策略。做一次完整演练——"外卖平台想估算从某商圈出发,配送员网络一小时最多送达多少单":配送员与商户为顶点、接单与配送能力为容量,源连商圈、汇连订单,最大流一算即得;若再问"加哪个商圈的配送员最能提升总单量",最小割直接给答案。从业务到模型到算法到约束,四步一气呵成。
行业应用矩阵
⚠️ 常见坑:拿教科书算法硬吃生产规模。全国路网裸跑 Dijkstra、十亿顶点社交图全量重算 MST,都会在生产环境翻车;务必先过"规模、时效、增量"三道约束关,再决定算法档位与改造方式。
💡 关键直觉:行业会变,链路不变。无论下一个题目来自外卖、芯片还是推荐流,先问"目标类型是路径、连通还是容量",再套四步链路——三大算法族就是图世界的"三原色",足以调出绝大多数业务问题的底色。
常见疑问解答
业务问题"既能建成最短路又能建成流",怎么取舍?
看优化的量:若"每笔业务各自最优"是核心(每个订单走最快的路),建最短路;若"系统总吞吐"是核心(所有订单加起来最多完成多少),建流。两者混搭时常见架构是"流模型定盘子、最短路定走法"——先用最大流确定各链路的分配额度,再对每笔业务在额度内跑最短路。
实时性要求毫秒级,图算法来得及吗?
来得及,但几乎必然要"预计算加增量":导航的分层索引、社交的离线距离索引、物流的预生成矩阵,都是把在线查询变成查表或小范围计算。设计时的黄金问题是"哪些结果可以提前算好、变化来了只修哪一小块"——这个问题想清楚,毫秒级响应并不神秘。
图算法服务怎么监控健康度?
三个层次的指标:算法层——结果合法性断言(最短路的距离一致性、流的守恒校验)采样通过率;性能层——查询延迟分位数、预计算任务耗时;业务层——推荐路线采纳率、配送准时率。图算法的线上事故往往先在"结果合法性"露出马脚(脏数据进图),把它做成常态断言是最划算的保险。
动手实验:给一个虚构县城做全套规划
一个覆盖全书的综合练习:虚构一个县城,二十个路口、三个仓库、八个加油站、两所学校。任务一,为救护车规划"任意路口到县医院"的最快路线(路宽限速折算权重,最短路径族,可分层);任务二,规划"把八个加油站接入输油管网"的最省方案(生成树,含可靠性加环讨论);任务三,评估"三个仓库向全县配送的日极限运量"并指出应拓宽哪条路(最大流加最小割)。三个任务共用同一张底层图,产出三份互相衔接的方案。做完这个练习,你不仅复习了三大算法族,更体验了真实规划工作里"一张图、多个问题、共享建模"的常态——这正是图算法工程师的日常。
学完这些场景,怎么证明自己真的掌握了?
给自己出一道"改编题":把本节某个场景的业务约束改一处(比如给物流加上"冷链车只能走高速"),推演建模与算法选择的连锁变化——顶点、边、权重哪里要动,算法族是否要换,复杂度档位是否够用。能独立完成一次完整的推演并说清每步理由,掌握就是真的;说不出理由只是背熟了案例,而改编题恰好无处可背。
本章回顾
- 导航与路由:Dijkstra 的主场,工程三板斧是分层路网、动态代价、预处理加速;推荐路线常是最优解的"邻域组合"。
- 社交网络:最短路量关系距离、生成树构社区骨架、最大流演信息扩散;规模约束逼出离线预处理加增量修正。
- 物流运输:三族协同的样板——选路用最短路、干线用生成树、运力用最大流加最小割诊断。
- 电路与推荐:同构复用——信号路径、布线连通、功耗分配;兴趣距离、关联骨架、资源分配。
- 四步链路:业务问题、图模型、算法族、工程约束——最后一格(规模、时效、增量)常是真正的决策点。
- 约束意识:复杂度档位看规模,响应要求看时效,变化频率决定维护策略。
- 全书收束:概念筑基(第 1 章)→ 三大问题(第 2 到 4 章)→ 工程落地(第 5 章),图算法的进阶之路至此闭环。
走完五章,你已经能对绝大多数"关系型"问题给出模型、算法与工程方案。接下来最好的练习是拿自己业务里的一个真实问题,走一遍四步链路——从问题到图,不过一步之遥。