边表、关联矩阵与表示法选型
边表、关联矩阵与表示法选型
「边表」听起来朴素得不像数据结构——它就是一份"谁连谁"的流水账。但正是这份流水账,撑起了图数据的交换格式、稀疏矩阵的标准存储与一批逐边作业的算法。本节先讲边表与关联矩阵这两种补位表示,再把本章三种画法放上同一张决策台,给出可以直接照做的选型规则。远征队出发前的最后一件实务,就是为地图选定画法。
边表:一份流水账的能量
边表把图压成若干行记录,每行一条边:起点、终点、(可选)权重。它的第一个优势是流式友好:数据从日志、CSV、数据库导出里源源涌来时,天然就是一行行的边记录,读入即建图,不必预先知道顶点数。第二个优势是逐边作业:第 6 章的 Kruskal 要给全部边排序,第 7 章的最大流要反复挑选增广边,边表就是它们的主战场。第三个优势是交换格式:许多图数据文件格式本质就是带表头的边清单。
代价同样明显:查邻与枚举邻居都要全表扫描(或先转成邻接表)。所以边表常作为"输入格式"存在,进场后立刻转换成更趁手的结构。
# 从边清单读入并一键转为邻接表(networkx 的标准入场方式) edges = [ ("仓库", "中转站", 12), ("中转站", "前哨", 5), ("仓库", "前哨", 20), ("前哨", "阵地", 7), ("中转站", "阵地", 9), ] import networkx as nx G = nx.Graph() G.add_weighted_edges_from(edges) # 边表 → 内部邻接表 print("边表视角:", list(G.edges(data=True))) print("邻接表视角:", {v: dict(G[v]) for v in G})
关联矩阵:顶点与边的关系账
关联矩阵换了一个记账科目:行是顶点,列是边。无向图里,顶点若与某条边相连,对应格子记一,否则记零;有向图里,边的起点记负一(或加一)、终点记加一(或负一),以区分头尾。它回答的问题是"这条边挂在哪些顶点上",而不是"这两点之间有没有边"。
关联矩阵的用途比邻接矩阵小众,但在两处闪光:一是电路理论(关联矩阵是基尔霍夫定律的代数载体),二是边着色与匹配的某些理论推导。它的空间同样按"顶点数乘边数"计费,工程上多作为理论工具而非日常存储。
# 关联矩阵一览:5 个顶点、4 条边 → 5×4 的矩阵 import networkx as nx G = nx.Graph([(0,1),(1,2),(2,3),(3,4)]) inc = nx.incidence_matrix(G) # 稀疏格式 print(inc.toarray().astype(int)) # 每列恰有两个 1(一条边的两个端点);每行 1 的个数 = 该顶点的度 print("行和 = 度数:", inc.toarray().sum(axis=1).astype(int))
决策台:三种画法怎么选
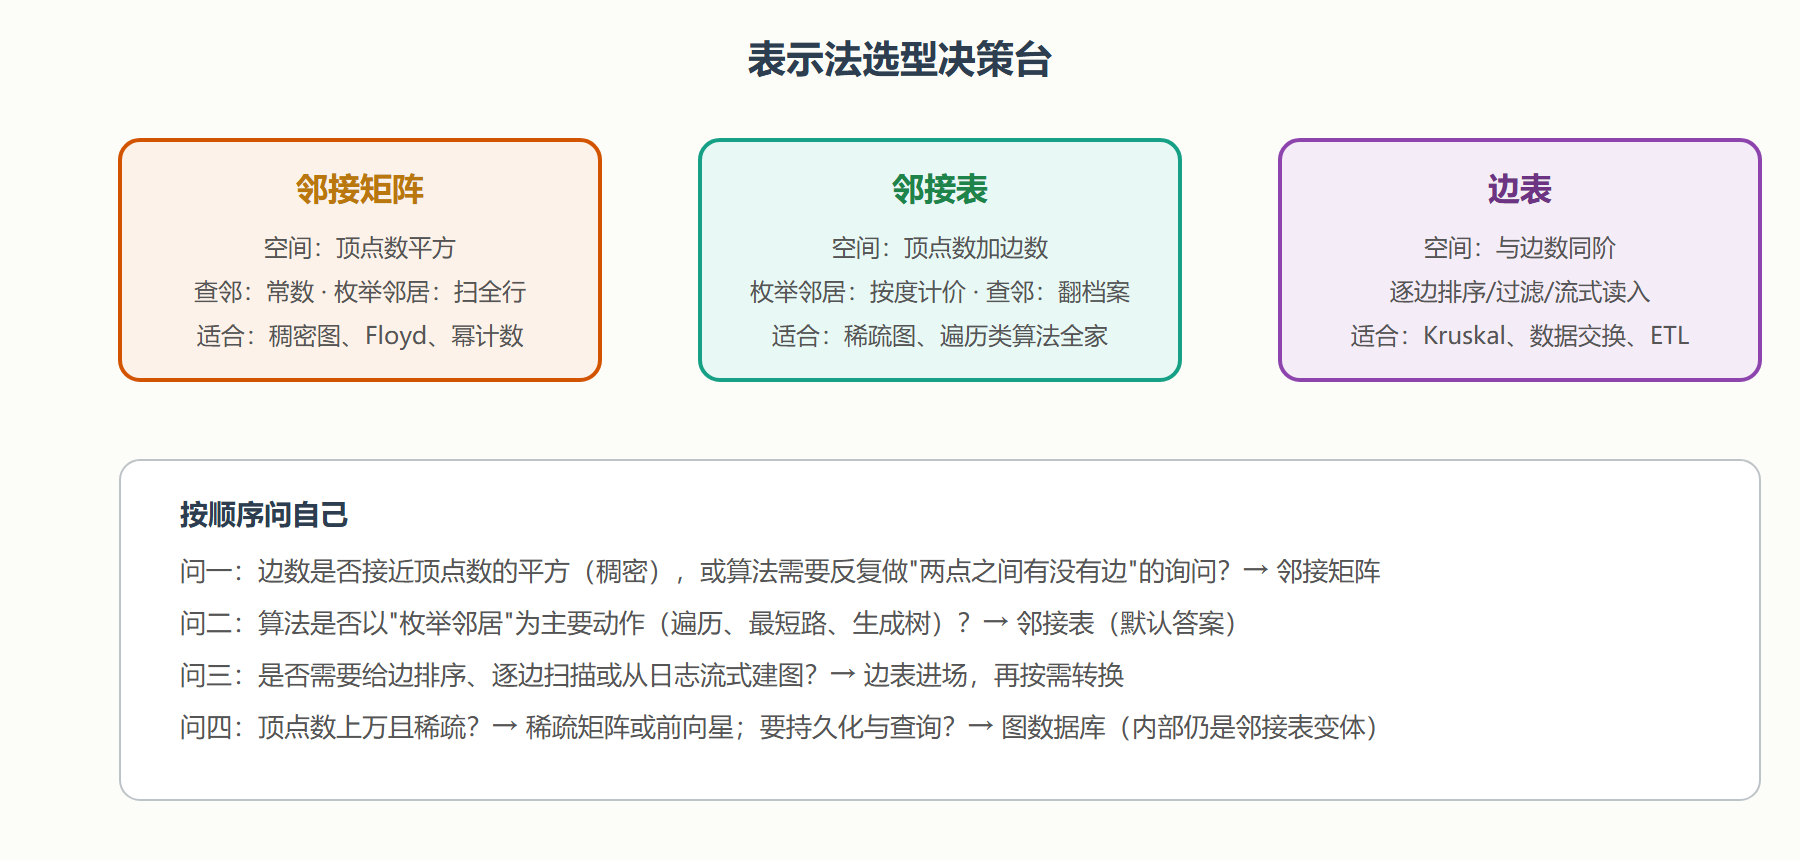
一次完整的换装演习
三种表示的互转是基本功。下面的代码完成"边表读入 → 邻接表 → 邻接矩阵 → 稀疏矩阵"的完整换装,并核对换装前后信息无损:
先把账单汇成一张速查表,方便日后回查:
| 操作 | 邻接矩阵 | 邻接表 | 边表 |
|---|---|---|---|
| 查邻(两点有边吗) | 常数 | 按度翻找 | 全表扫描 |
| 枚举邻居 | 扫全行 | 按度直读 | 全表扫描 |
| 加边删边 | 常数 | 常数 | 追加容易删除难 |
| 空间 | 顶点数平方 | 顶点数加边数 | 与边数同阶 |
| 全边排序 | 不便 | 需先摊开 | 原生支持 |
| 典型雇主 | Floyd、谱分析 | 遍历、Dijkstra、Prim | Kruskal、ETL、图数据库导入 |
import networkx as nx from scipy.sparse import csr_matrix edge_rows = [ (0, 1, 3.0), (1, 2, 2.5), (0, 2, 9.0), (2, 3, 1.5), (1, 3, 7.0), ] # 1) 边表 → 邻接表(networkx 内部即邻接表) G = nx.Graph() G.add_weighted_edges_from(edge_rows) # 2) 邻接表 → 稠密矩阵(小图演示用) dense = nx.to_numpy_array(G, weight="weight", nodelist=sorted(G.nodes)) print("邻接矩阵:\n", dense) # 3) 邻接表 → 压缩稀疏行(大规模图的生产形态) sparse = nx.to_scipy_sparse_array(G, weight="weight", nodelist=sorted(G.nodes)) print("稀疏存储的非零元素数:", sparse.nnz, "(边数的两倍,无向图对称登记)") # 4) 校验:换装无损 assert (abs(dense - sparse.toarray()) < 1e-12).all() print("换装演习完成,信息无损")
演习里值得注意的细节:无向图的稠密矩阵与稀疏存储都把每条边登记两次(对称),所以稀疏矩阵的非零元素数等于边数的两倍——这与握手定理是同一件事的两种说法。
再把决策台拉到一个具体场景上走一遍全流程,体会"按问题选画法"的实操感。设想你要为一家连锁门店做配送分析:原始数据是物流系统导出的发货流水(订单、门店、数量),要做两件事——其一,统计每个门店最常往来的伙伴(高频邻居统计);其二,对全网算一遍配送中心的选址(后续章节的中心性分析)。第一件事的操作是"按端点聚集边、按频次排序",正是边表的主场:一条按起点分组、组内按权重排序的流水线即可,全程不必建任何索引结构;若换成邻接矩阵,就要先为整张网开出方阵、再逐格扫描,纯属绕路。第二件事要反复"枚举某门店的全部往来对象",邻接表立刻接管:一次分组转换,把流水账折叠成每个门店的邻居档案,后续查询按度计价。这个场景里三种画法都没缺席——矩阵只在需要做两两全量演算(比如同时评估所有候选点的总路程矩阵)时才值得请出来。选型的功夫说到底就这一句:先看清操作模式,再让存储跟着操作走,而不是反过来让算法迁就存储。
⚠️ 常见坑:转换时指定顶点顺序。矩阵的行列含义取决于顶点编号顺序,不固定顺序(如上面显式传入排序后的节点表)就可能在两次转换间错位,得到"看起来对、实际全错"的矩阵。
💡 关键直觉:选型不是终身大事。真实系统的常见路线是"边表入场、邻接表作业、矩阵演算"——按算法需要随时换装,转换成本只付一次,收益贯穿全程。
地图画法齐备,行军的靴子该沾泥了。下一章远征队派出侦察兵:深度优先与广度优先,一切图算法的两条基本步法。