广度优先搜索:层层推进的包围网
广度优先搜索:层层推进的包围网
如果侦察任务不是"摸清所有街巷",而是"以最快速度抵达目标据点",孤胆深潜还靠得住吗?深度优先搜索一头扎进长巷,很可能与近在咫尺的目标擦肩而过。本节换上另一种队形:广度优先搜索。它以上一节的邻接表为档案来源,把单兵深潜换成层层合围,由此收获一件深潜步法给不了的装备——距离。它是无权图上货真价实的最短路算法,也是第 5 章加权最短路战役的直接前身。
包围网怎么撒
广度优先搜索的军令只有一条:先发现者先扩展。执行这条军令的数据结构是队列——先进先出。把这条军令展开成行军画面:
站在起点,把它的全部白色邻居编入第一圈包围网;第一圈的所有据点依次扩展,得到第二圈;第二圈再扩展出第三圈。每一圈就是一层"前沿",网撒开的节奏由队列的进出次序严格控制:谁先入队,谁就先把自己的邻居送入下一圈。
于是图上的顶点被切成了清晰的层次:起点的层次为零,任一顶点的层次等于它到起点的最短跳数——沿边走一步算一跳,不涉及任何加权。包围网推进到第几圈,就说明"几步之内可达的据点已全部收网"。这与深潜形成鲜明对照:深度优先的轨迹是一条不断伸缩的线,广度优先的轨迹是一圈圈同心圆。
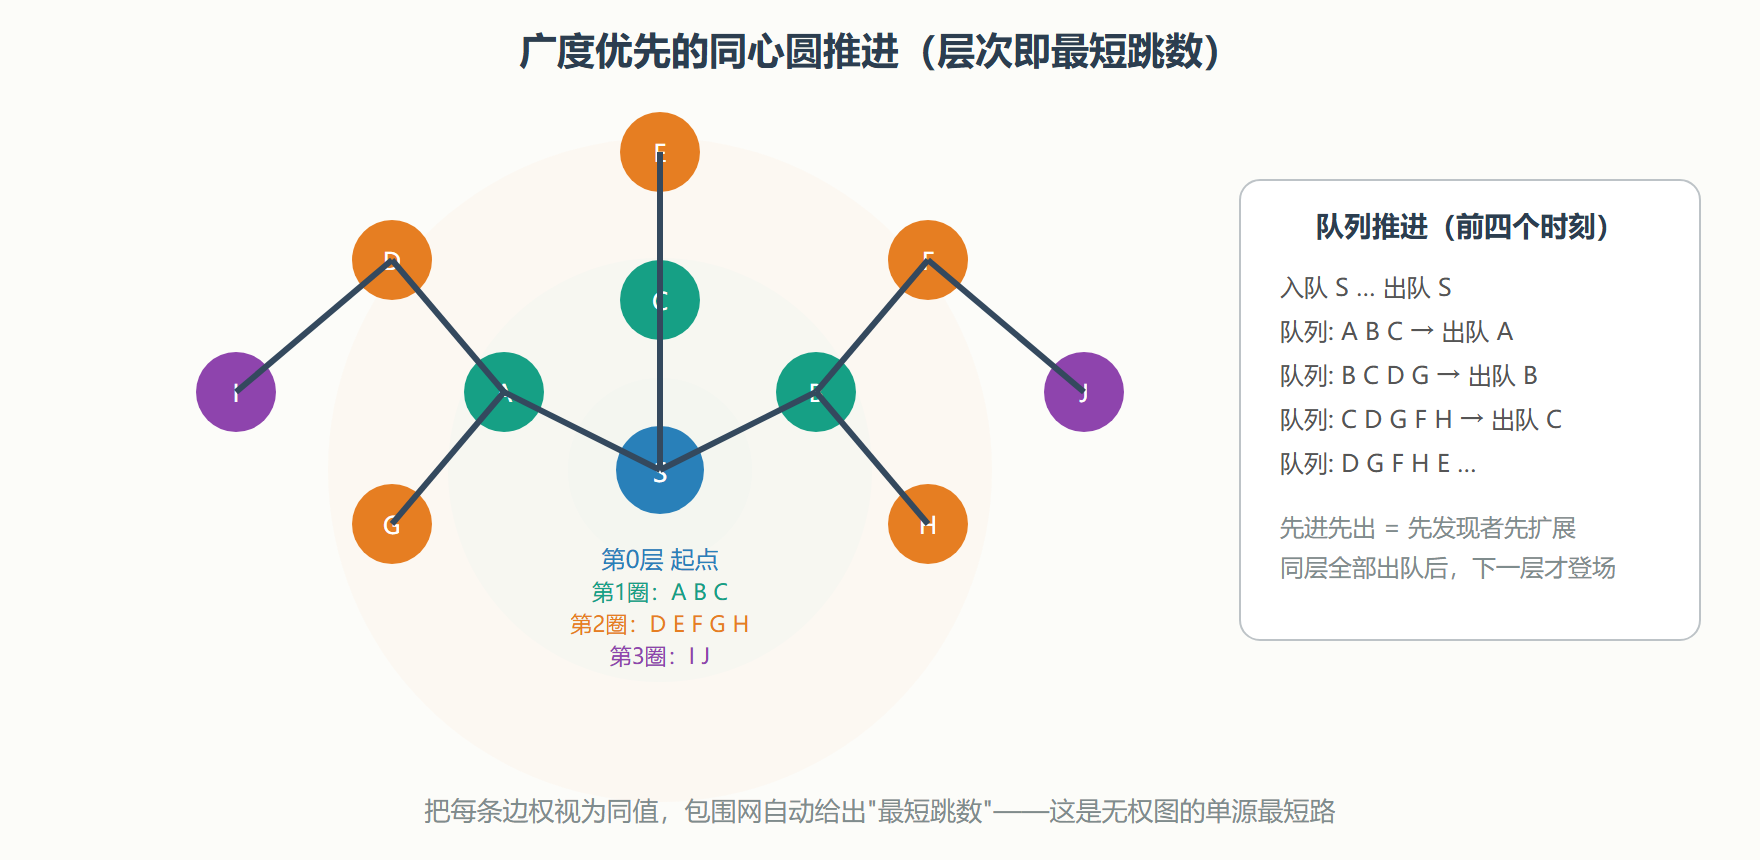
从图中还能读出一件结构性事实:广度优先访问过的边组成一棵广度优先树,树上每个顶点到树根的路径,就是它在原图中最短跳数的一条最短路径。换句话说,最短路径不用另外找,它就藏在父指针链里。
为什么层次就是最短跳数
这条性质值得一个像样的论证,而不是一句"显然"。用归纳法沿层次推进:起点到自身的距离为零,成立。假设包围网推进到某一层之前,所有已收编顶点的层次都等于其真实最短跳数;考虑顶点 v 的最短路径,设它在路径上的前一站是 u,那么 v 的真实距离至多是 u 的距离加一。队列的先进先出保证了:u 入队时,v 若还是白色就会被立刻染灰并记为"u 的孩子",此时 v 获得的层次恰好是"u 的层次加一"。倘若 v 其实存在更短的路线,那条路线的倒数第二站必然更早或同批入队,v 也就会被更早染灰并获得更小的层次——矛盾。所以每个顶点第一次被染灰时拿到的层次就是精确的最短跳数。
论证的关键支点只有一个:先发现者先扩展。一旦把队列换成栈,这条性质立刻作废——这正是深度优先给出的是"某条路径"而广度优先给出的是"最短路径"的分水岭。往后看,第 5 章的 Dijkstra 算法把"先发现者先扩展"升级为"当前距离最短者先扩展",用优先队列替换普通队列,就把无权图的最短路推广到了非负加权图——两章之间的这条演化线索,建议现在就记在心里。
代码实现
标准实现用双端队列维护前沿,父指针与层次随收网同步登记:
from collections import deque import networkx as nx def bfs(G, start): """广度优先:返回每个顶点的父指针与到起点的最短跳数""" parent = {start: None} depth = {start: 0} queue = deque([start]) order = [] # 入队序 = 首次被发现序 while queue: u = queue.popleft() # 先进先出:军令所在 order.append(u) for v in G[u]: # 翻邻接表档案 if v not in parent: # 白色顶点才收编 parent[v] = u depth[v] = depth[u] + 1 queue.append(v) return parent, depth, order G = nx.Graph([("S","A"),("S","B"),("S","C"),("A","D"),("A","G"), ("C","E"),("B","F"),("B","H"),("D","I"),("F","J")]) parent, depth, order = bfs(G, "S") print("入队序:", order) print("层次表:", depth) def shortest_path(parent, start, target): """从父指针链还原一条最短路径""" if target not in parent: return None path = [target] while parent[path[-1]] is not None: path.append(parent[path[-1]]) return path[::-1] print("最短路径:", " → ".join(shortest_path(parent, "S", "I"))) # networkx 官方实现对照 print("nx 最短跳数:", nx.shortest_path_length(G, "S", "I"))
对照 networkx 的结果一致,说明手写版本可信。再看一个经典演练——词梯谜题:每次只许改换一个字母,把一个词变成另一个词,求最少步数。把每个词设为顶点、可一步互变的词对连边,词梯就成了纯粹的无权最短路问题,正好交给包围网:
import string WORDS = ["cold","cord","card","ward","warm","talc","talk","tall","tail", "fail","fall","foul","foul","foil","soil","soul","soup","group"] def word_ladder(words, src, dst): """词梯:邻接表 + 广度优先求最少变换步数""" word_set = set(w for w in words if len(w) == len(src)) def neighbors(w): for i in range(len(w)): for ch in string.ascii_lowercase: cand = w[:i] + ch + w[i+1:] if cand != w and cand in word_set: yield cand parent = {src: None} queue = deque([src]) while queue: u = queue.popleft() if u == dst: path = [dst] while parent[path[-1]] is not None: path.append(parent[path[-1]]) return path[::-1] for v in neighbors(u): if v not in parent: parent[v] = u queue.append(v) return None print(" → ".join(word_ladder(WORDS, "cold", "warm")))
从冷到暖,包围网给出的正是最少步数的变换链。把词换成路由器、把字母位换成链路,词梯就是网络跳数寻径的原型。
变体与陷阱
工程里广度优先有几个常见变体。双向广度优先从起点与终点同时撒网,两网相遇即停,在目标层次较深时能把搜索规模从单网的正比于顶点数压到小得多——社交网络里判断两人隔几跳相熟,工业实现几乎都用双向版。多源广度优先一开始把多个起点全部入队并把层次置零,一次推进同时求得"每个顶点到最近源点的距离",地图服务里"最近的关键设施是哪家"这类查询就是它的地盘。
⚠️ 常见坑:用普通列表的 pop 首元素模拟队列。列表从头部弹出是整体搬移,复杂度暴涨;必须用双端队列或索引游标。另一个坑是忘了在入队时染色、等到出队才染色——这会让同一个顶点被重复入队,队列里混进"影子部队"。
💡 关键直觉:深度优先与广度优先是同一套"染色加翻档案"流程,只差容器一个字——栈还是队列。容器一换,性质从"可达性"换成了"最短跳数",这就是数据结构里"接口相同、语义由容器决定"的教科书案例。
两种步法都已练成。地图上哪些据点连成一片、哪些道路围成回路——下一章远征队将正式勘定疆域,而勘定的第一件工具,正是本章这两种遍历。