Prim算法:从大本营生长的补给网
Prim 算法:从大本营生长的补给网
大本营的篝火旁,工兵队长摊开全区地形图:远征队控制着散落各处的据点,要在据点之间架设通行网——不必每两点直连,只要整体连通,且总造价最低。最朴素的念头是"从大本营开始,每次接上离已建区域最近的新据点",像滚雪球一样把网长出去。这就是 Prim 算法。本章战役开打,本节先把"生成树"这个目标物说清楚,再推演 Prim 的贪心为什么合法,给出朴素与堆优化两种实现,最后与上一章的 Dijkstra 做一次同框对照——两者代码相似到容易抄错的地步。
目标物:生成树与它的硬约束
先明确要造的是什么。连通图的生成树是一棵"用了图中全部顶点、边数恰为顶点数减一"的连通无环子图。这三条性质互为因果:要连通全部顶点至少需要那么多边;恰那么多边又连通则必然无环——再多一条边必然成环(连通性保证新边两端已有通路),再少一条边必然断裂。最小生成树(MST)是全体生成树中边权总和最小的那棵;权互不相同时它唯一,有并列时最小总权值依然唯一。
一个常被初学者忽略的区分:MST 不是"每对顶点间最短路"的并集。某条边可能出现在 MST 里却很长(它是维系某片区域连通的唯一廉价命脉),也可能很短却不入树(两端已有更便宜绕路)。"总造价最低"与"条条最短"是两道题——前者是本章,后者是上一章。
思路推演:安全边定理
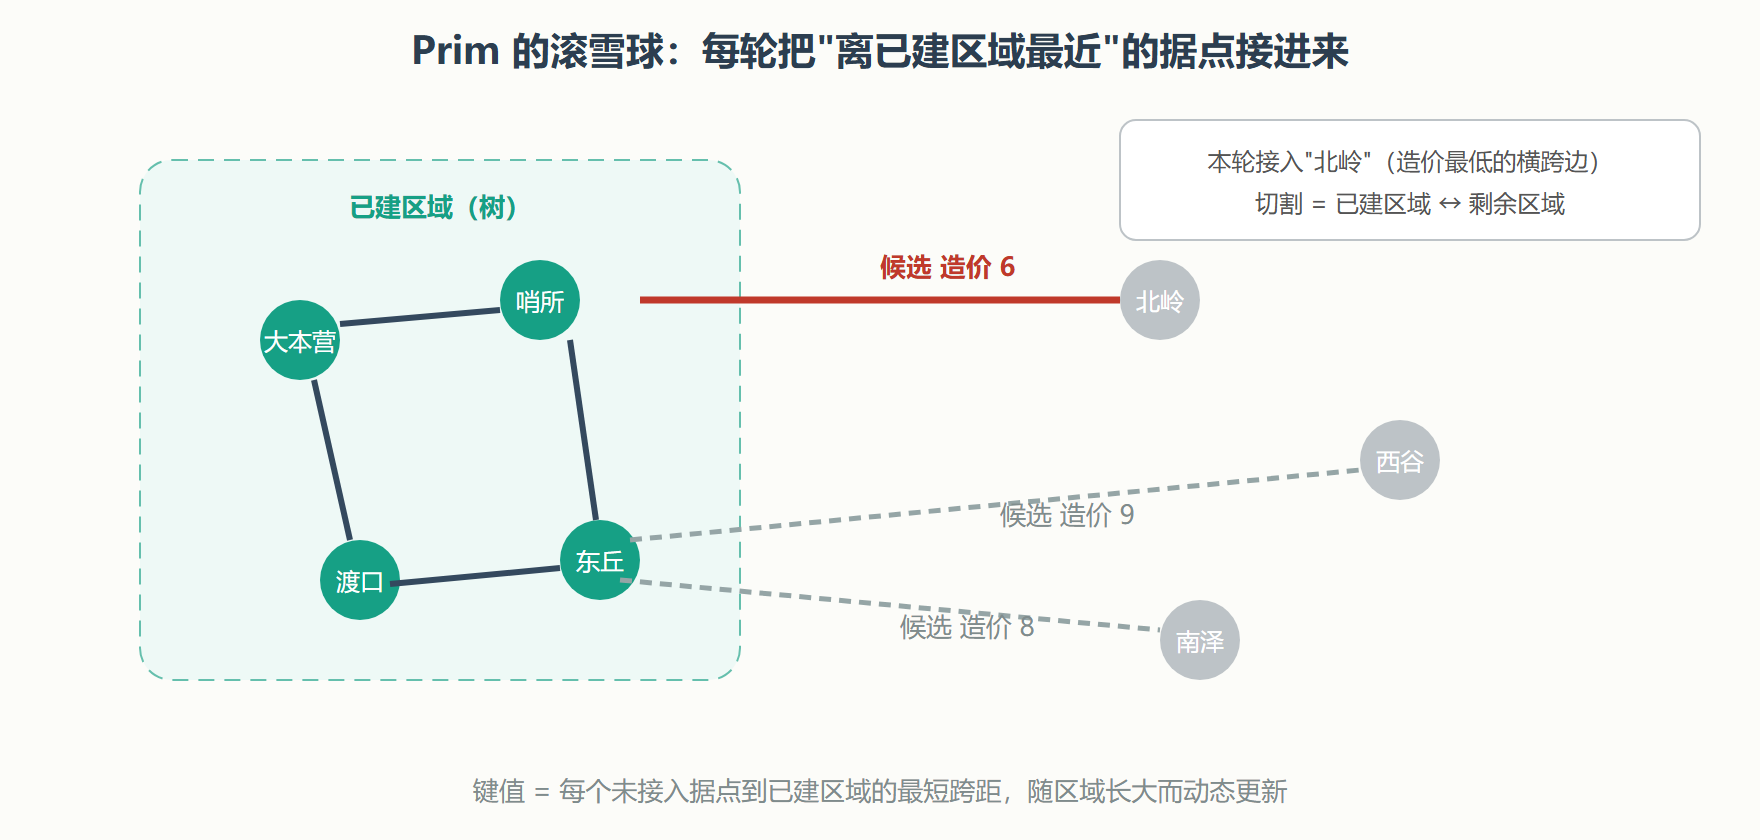
Prim 的每一步都面临同一道选择题:已建区域(一个不断长大的树的集合)与未接入区域之间,横跨着若干候选边,选哪条?算法的回答是:选横跨边里最便宜的那条。
合法性来自一条定理(切割安全定理):把顶点集切成两半(一个"切割"),横跨两半的边中最轻的那条("轻边")必属于某棵最小生成树。反证:任取一棵 MST,若它不含这条轻边 e,把 e 加进去必然成环,环上必有另一条也横跨两半的边 f;由于 e 是轻边,f 不会更便宜——用 e 换掉 f,得到的新树不更贵。故存在一棵含 e 的 MST。Prim 每一步的切割正是"已建区域对剩余区域",选轻边即安全边;归纳到底,长出的树就是 MST。
算法步骤与实现
口诀:区域外人人有键值,键值最小者入网,新据点的边刷新同伴。朴素版每轮线性扫最小键值:
import networkx as nx def prim_plain(G, start): """朴素版 Prim:返回 MST 的边列表与总造价""" INF = float("inf") key = {v: INF for v in G.nodes} # 到已建区域的最短跨距 key[start] = 0 parent = {start: None} in_tree = set() edges = [] while len(in_tree) < len(G.nodes): u = min((v for v in G.nodes if v not in in_tree), key=lambda v: key[v]) in_tree.add(u) # 键值最小者入网 if parent[u] is not None: w = G[parent[u]][u]["weight"] edges.append((parent[u], u, w)) for v, attr in G[u].items(): if v not in in_tree and attr["weight"] < key[v]: key[v] = attr["weight"] # 刷新同伴的键值 parent[v] = u return edges, sum(w for _, _, w in edges) camps = nx.Graph() camps.add_weighted_edges_from([("大本营","哨所",4),("大本营","渡口",3), ("哨所","东丘",2),("渡口","东丘",5),("哨所","北岭",6), ("东丘","西谷",9),("东丘","南泽",8),("北岭","西谷",3)]) edges, cost = prim_plain(camps, "大本营") print("MST 边:", edges) print("总造价:", cost) mst_ref = nx.minimum_spanning_tree(camps, algorithm="prim") print("nx 对照 总造价:", sum(d["weight"] for *_, d in mst_ref.edges(data=True)))
堆优化版与 Dijkstra 的堆优化同构——键值进堆、惰性删除、弹出即入网:
import heapq def prim_heap(G, start): """堆优化 Prim:稀疏图上的首选""" INF = float("inf") key = {v: INF for v in G.nodes} key[start] = 0 heap = [(0, start, None)] edges = [] seen = set() while heap: k, u, p = heapq.heappop(heap) if u in seen: continue # 过期条目 seen.add(u) if p is not None: edges.append((p, u, k)) for v, attr in G[u].items(): if v not in seen and attr["weight"] < key[v]: key[v] = attr["weight"] heapq.heappush(heap, (attr["weight"], v, u)) return edges, sum(w for _, _, w in edges) edges2, cost2 = prim_heap(camps, "大本营") print("堆优化版 总造价:", cost2, "| 边数:", len(edges2))
与 Dijkstra 的同框对照
两份代码并排放,差异只剩一处:键值的定义。Dijkstra 的键是"到起点的总路程",松弛时累加——dist[u] + w;Prim 的键是"到已建区域的单步跨距",刷新时直接比较——w 本身。这一字之差让 Dijkstra 算的是路径总长(可能穿过许多中间点),Prim 算的是每条边各自的价钱。把 Prim 的比较误写成累加,是最常见的抄写事故;反之,理解了这处差异,也就理解了"贪心的对象决定键值的设计"这条普遍法则。
复杂度与 Dijkstra 完全同构:朴素版平方量级(稠密图友好),堆优化版"边数乘对数"量级(稀疏图友好)。值得单独一提的是稠密场合的选择题:当边数接近完全图时,朴素 Prim 反而是理论上最优的 MST 算法之一——平方量级正好抵住边数本身,堆操作纯属额外开销。
应用与变体
MST 的应用远不止架桥铺路。电网规划是它的原始出身(捷克工程师为摩拉维亚电网设计的历史案例正是 MST 算法的源头之一);光缆与管道网络的骨架设计、传感器网络的拓扑控制同构于此。分析场景里,单链聚类把 MST 当聚类工具:建树后砍掉最贵的几条边,树断裂成的几块就是聚类——第 10 章社区发现会再遇此思路。近似算法里,MST 是旅行商问题的跳板:先建 MST 再深度优先巡游,得到的不超过最优解两倍的路线,"两倍近似"的证明干净利落。变体方面,最大生成树把权重取反即可;受限最小生成树(限定某些边必须入选或每顶点度数有上限)则会让问题升级为难解的组合优化,贪心时代就此结束——那是另一册书的故事。
⚠️ 常见坑:图不连通时硬跑 Prim。键值无穷的顶点会被
min选中、父指针为空,程序行为未定义;正确做法是先跑第 4 章的连通性检查,或对每个分量各建一棵树,输出"最小生成森林"。
💡 关键直觉:Prim 与 Dijkstra 是"同一副骨架、两颗心脏"——骨架是优先队列驱动的贪心扩张,心脏分别是"总路程"与"单步跨距"。学算法学到能一眼看出这种同构,才算把两家血脉真正分开。
生长路线已成军。下一节换另一条思路:不围着任何区域转,把所有边摊开标价,从最便宜的开始逐条审批——Kruskal 的架桥清单。