Kruskal算法:按造价排序的架桥清单
Kruskal 算法:按造价排序的架桥清单
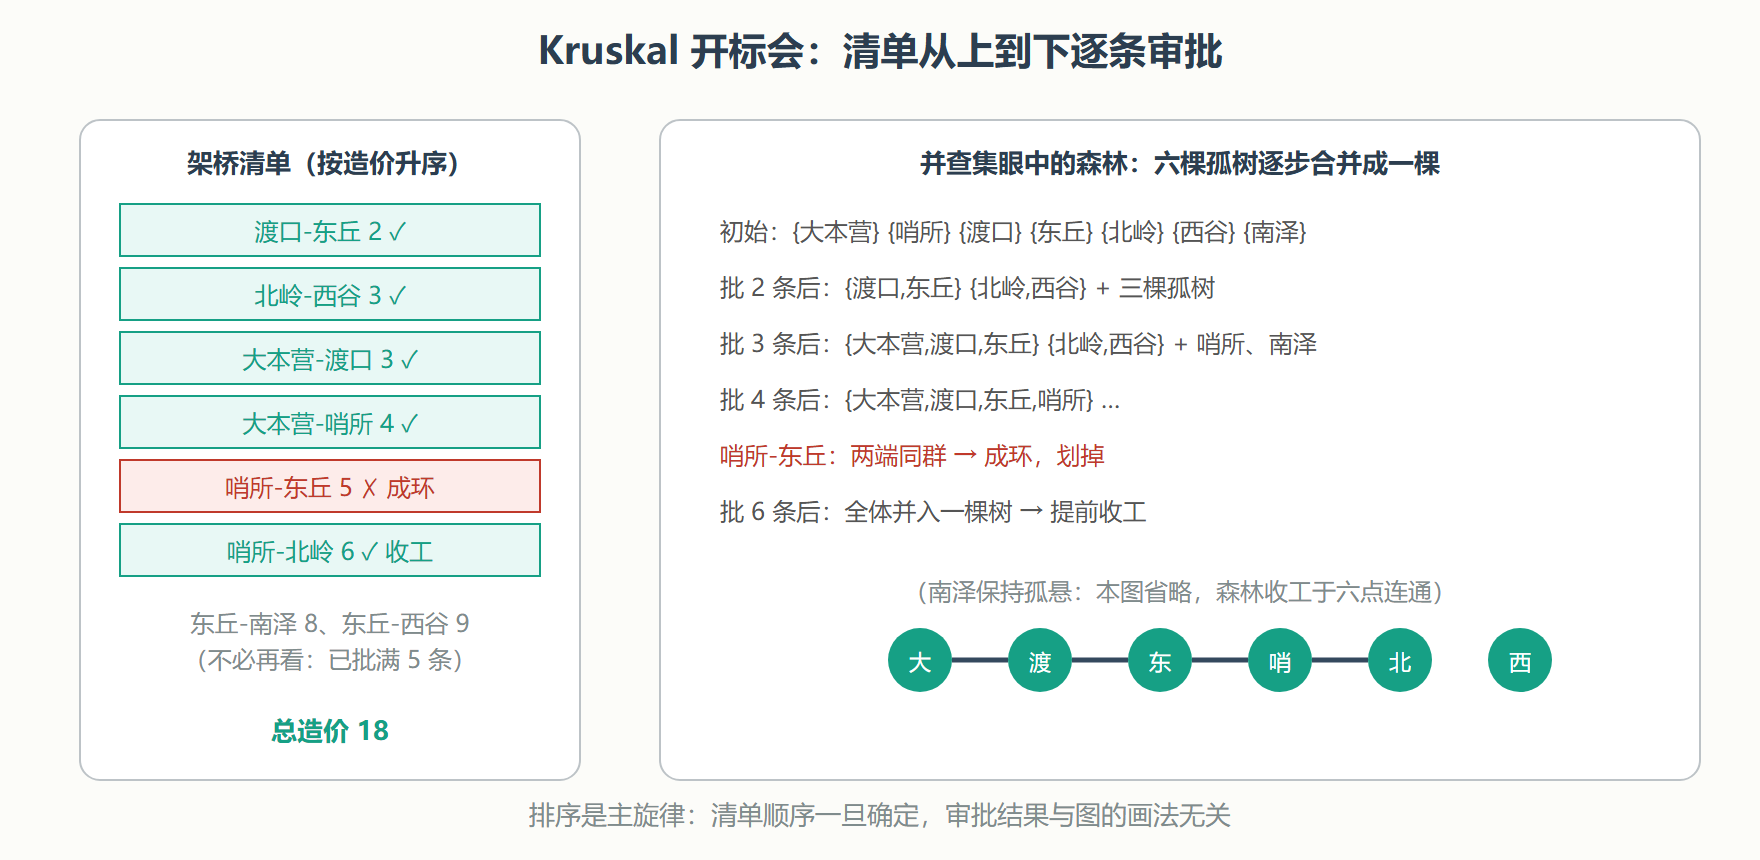
回望这条算法的谱系:从摩拉维亚电网的普查需求,到数学家们把"最省连通"提炼成最小生成树问题,再到一条以 Kruskal 命名的极简规则——把候选边全部标价排序,从最便宜的批起,会成环的划掉,批满"顶点数减一"条即收工。它与上一节的 Prim 共用同一条安全边定理,气质却全然不同:Prim 像滚雪球,盯着区域生长;Kruskal 像开标会,眼里只有一张按造价排好的清单。本节推演它的合法性,实现它的完整代码(第 4 章的并查集在此担任要职),并对比两条路线的适用地形。
思路推演:为什么"成环则弃"就够了
Kruskal 的规则只有两条:便宜者优先;接过两边已连通的边就划掉。第一条来自贪心的直觉,第二条防止浪费(成环的边对连通性零贡献,纯增造价)。合法性论证的骨架仍是切割安全定理,只是切割的取法换了:考察清单中任意时刻"已被接纳的边集"构成的森林,当算法考虑某条边 e 且其两端分属不同树时,把"包含 e 一端的树"与"其余全部顶点"视为一个切割——e 正是当前横跨该切割的最轻边(比它更轻的都已处理:要么接纳,要么因成环被弃,而被弃者两端当时已同树,不可能横跨此切割),所以 e 是安全边,接纳它不会偏离某棵 MST。
归纳到收工:接纳的边数达到"顶点数减一"时,森林连通成树;每条边都是安全边,合起来正是 MST。这段论证值得与 Prim 的版本对照着读:同一颗定理内核,Prim 每步现造一个"区域对余部"的切割,Kruskal 每步用一个"树对余部"的切割——定理是桥,两条路线是两岸。
算法步骤与实现
实现三步走:边排序;逐条过清单;用并查集判"两端是否同群"——同群划掉,异群接纳并合并两群。第 4 章造好的兵器在此原样上岗:
import networkx as nx class UnionFind: # 第4章的并查集,原样搬来 def __init__(self, items): self.parent = {x: x for x in items} self.rank = {x: 0 for x in items} def find(self, x): root = x while self.parent[root] != root: root = self.parent[root] while self.parent[x] != root: self.parent[x], x = root, self.parent[x] return root def union(self, x, y): rx, ry = self.find(x), self.find(y) if rx == ry: return False if self.rank[rx] < self.rank[ry]: rx, ry = ry, rx self.parent[ry] = rx if self.rank[rx] == self.rank[ry]: self.rank[rx] += 1 return True def kruskal(G): """返回 MST 的边列表与总造价""" edges = sorted(G.edges(data=True), key=lambda e: e[2]["weight"]) uf = UnionFind(G.nodes) chosen = [] for u, v, d in edges: if uf.union(u, v): # 异群:接纳并合并 chosen.append((u, v, d["weight"])) if len(chosen) == len(G.nodes) - 1: break # 批满即收工 # 同群:成环,自然跳过 return chosen, sum(w for *_, w in chosen) camps = nx.Graph() camps.add_weighted_edges_from([("大本营","哨所",4),("大本营","渡口",3), ("哨所","东丘",5),("渡口","东丘",2),("哨所","北岭",6), ("东丘","西谷",9),("东丘","南泽",8),("北岭","西谷",3)]) chosen, cost = kruskal(camps) print("Kruskal 选边:", chosen) print("总造价:", cost) mst_ref = nx.minimum_spanning_tree(camps, algorithm="kruskal") print("nx 对照 总造价:", sum(d["weight"] for *_, d in mst_ref.edges(data=True)))
对照 Prim 的输出:总造价必然一致(权互不相同时选边也一致),这是两条路线殊途同归的直接验证。再演练一个经典追问——次小生成树:严格比 MST 贵一点的次优树是什么?标准解法恰好把两条路线串起来用:
def second_best_mst(G): """求次小生成树:换掉 MST 中"非树边"能替换的最贵树边""" mst_edges, best = kruskal(G) mst = nx.Graph(); mst.add_weighted_edges_from(mst_edges) best2 = float("inf") for u, v, d in G.edges(data=True): # 枚举每条非树边 if mst.has_edge(u, v): continue path = nx.shortest_path(mst, u, v, weight="weight") # 树上唯一路径 heaviest = max(mst[a][b]["weight"] for a, b in zip(path, path[1:])) candidate = best - heaviest + d["weight"] if candidate > best: # 严格更贵才计入 best2 = min(best2, candidate) return best2 print("次小总造价:", second_best_mst(camps))
非树边换入时,必须退掉树上路径里最贵的一条以保持树的形态——枚举全部非树边取最小增量,就得到次小解。这类"树敏感"的追问最能检验对 MST 结构的理解。
复杂度与两条路线的选型
账单三段:排序占"边数乘对数"量级;并查集操作近似常数摊还,全体合并与查询合计近似线性;总代价由排序主导。与 Prim 对比的选型结论:稀疏图选 Kruskal(排序量小、并查集轻快、代码可移植性极强),稠密图选朴素 Prim(边多到排序都嫌重时,平方级扫描反而不吃亏)。另有第三条路线 Borůvka——每轮让每个分量各自抓一条最便宜的出边,多分量并行合并,天然适合分布式与并行机器,是历史上最早的 MST 算法思路,现代图计算框架里仍在服役。
一个必须澄清的常见疑惑:权重相等较多时 MST 不唯一,但 Prim 与 Kruskal 的输出可能不同——不同的树,同样的总价。若业务要求"唯一确定"(比如审计场景),给相等权附加一个稳定的次级排序键即可。
应用与变体
Kruskal 的"排序加并查集"骨架在聚类分析中大放异彩:层次聚类的单链法等价于在距离图上跑 Kruskal——每接纳一条边就合并两群,砍断清单的某个位置就得到一个层级的聚类结果。图像分割的经典方法也同构:把像素当顶点、相邻像素的差异当权,Kruskal 式合并配一条"区域间差异阈值"就切出物体轮廓。网络设计里,它的变体支撑着电网、供水、通信的骨架规划;约束变体(度受限、直径受限的 MST)则进入组合优化的深水区。
⚠️ 常见坑:无向图边表忘了对称登记或重复登记。Kruskal 对数据规整性零容忍——重复边会成环被弃倒无大碍,漏登记则可能错过真正的轻边。
💡 关键直觉:Prim 是"区域视角",Kruskal 是"清单视角"。前者问"往哪长最便宜",后者问"下一条最便宜的边该不该批"。视角切换而不改答案,靠的是背后同一条安全边定理——好定理能同时给两套算法发牌照。
架桥清单批完,通行网已然成型。可若据点之间的通路不是双向的呢——任务有先后、依赖有方向,行军次序怎么排?下一节的拓扑排序接过调度权杖。