5.2 社团检测算法:从模块度到信息论
5.2 社团检测算法:从模块度到信息论
摘要:社团检测把第 3 章登记的「组内稠密、组间稀疏」形态变成可计算问题。本节装配三套主力方案:以模块度为质量函数的优化路线(Louvain 两阶段流水线及其后继 Leiden)、以网络结构谱为线索的谱聚类与标签传播、以信息论压缩为准则的地图方程路线;同时登记模块度的分辨率极限、模块度的密度偏差等已知缺陷,以及重叠社团与质量评价的实务。本节在体系中的位置:仪表车间第二台设备,为第 7 章领域应用与第 6 章动力学分区提供切块能力。
检测问题:先把「像不像社团」写成函数
第 3 章看得出社团长什么样,本章要把它变成算法。第一步是定义质量函数——给任意一种划分打分,检测就退化成「找让分数最高的划分」。行业标准打分器叫模块度,构造直觉只有一句话:组内边占比,减去「随机拼接下组内边的期望占比」。前一项直接数边;后一项用保度随机图当期望基线(保持度序列不变的随机网络),一条边落在组内的期望近似由两端度的乘积除以总边数给出。实际比期望稠,模块度为正;比期望稀,为负。这个「实际减期望」的构造正是第 2 章随机对照思想的函数化——零假设正式长进了目标函数里。
模块度也有天然缺陷,先记两条再装机。分辨率极限:模块度把「全局总边数」放在分母上,小社团的信号被大网络稀释——比特征尺度小的社团,即使内部完美稠密,合并进大社团反而得分更高;极限案例是「两个各自完美的社团被误判成一个」。密度偏差:稠密网络里随机涨落也能刷出可观的模块度——所以模块度读数必须过零模型检验(下一节的 Z 分数正是为此),单看绝对值会自我恭维。
优化路线:Louvain 流水线
有了打分器,搜索空间仍然天文数字,穷举无望,流水线登场。Louvain 是「贪心局部移动 + 网络粗粒化」的两阶段循环:第一阶段,每个节点轮流尝试搬进邻居的社团,搬就搬能最大化模块度增量的那个,搬无可搬为止;第二阶段,把每个社团压成一个超节点、社团间边权合并,得到一张小一圈的粗网,回到第一阶段继续搬。两层循环交替,网络一层层缩骨,直到模块度不再上涨。快是它的招牌——边数线性级的近线性复杂度,亿级网络的社团检测成为可能。
后继者 Leiden 修了 Louvain 的两个工程毛病:局部搬迁可能产出「内部断线」的社团(社区里有一小撮节点其实与本体不连通),以及贪心易陷局部最优。Leiden 在循环里插入「精炼」步骤,允许社团先散再聚,并保证结果社团内部连通。实务默认用 Leiden、解释口径沿用 Louvain,已是车间惯例。
import networkx as nx from networkx.algorithms import community G = nx.karate_club_graph() comms = nx.community.louvain_communities(G, seed=7) Q = nx.community.modularity(G, comms) print("Louvain 划分:", [sorted(c) for c in comms]) print("模块度:", round(Q, 3)) # 与真实派系对照:管理员派 vs 教练派 truth = {"Mr. Hi" if G.nodes[n]["club"] == "Mr. Hi" else "Officer" for n in G} labels = [G.nodes[n]["club"] for n in sorted(G)] print("真实派别标签数:", len(set(labels)))
空手道网络上的划分与真实分裂高度吻合——这也是它成为社团检测「标准试金石」的原因。把检测数当超参数微调(分辨率参数、随机种子),同一网络能切出粗细不同的层级,Louvain 的层次化输出天然支持这种「显微镜调焦」。
另外两条路线:谱、标签与信息论
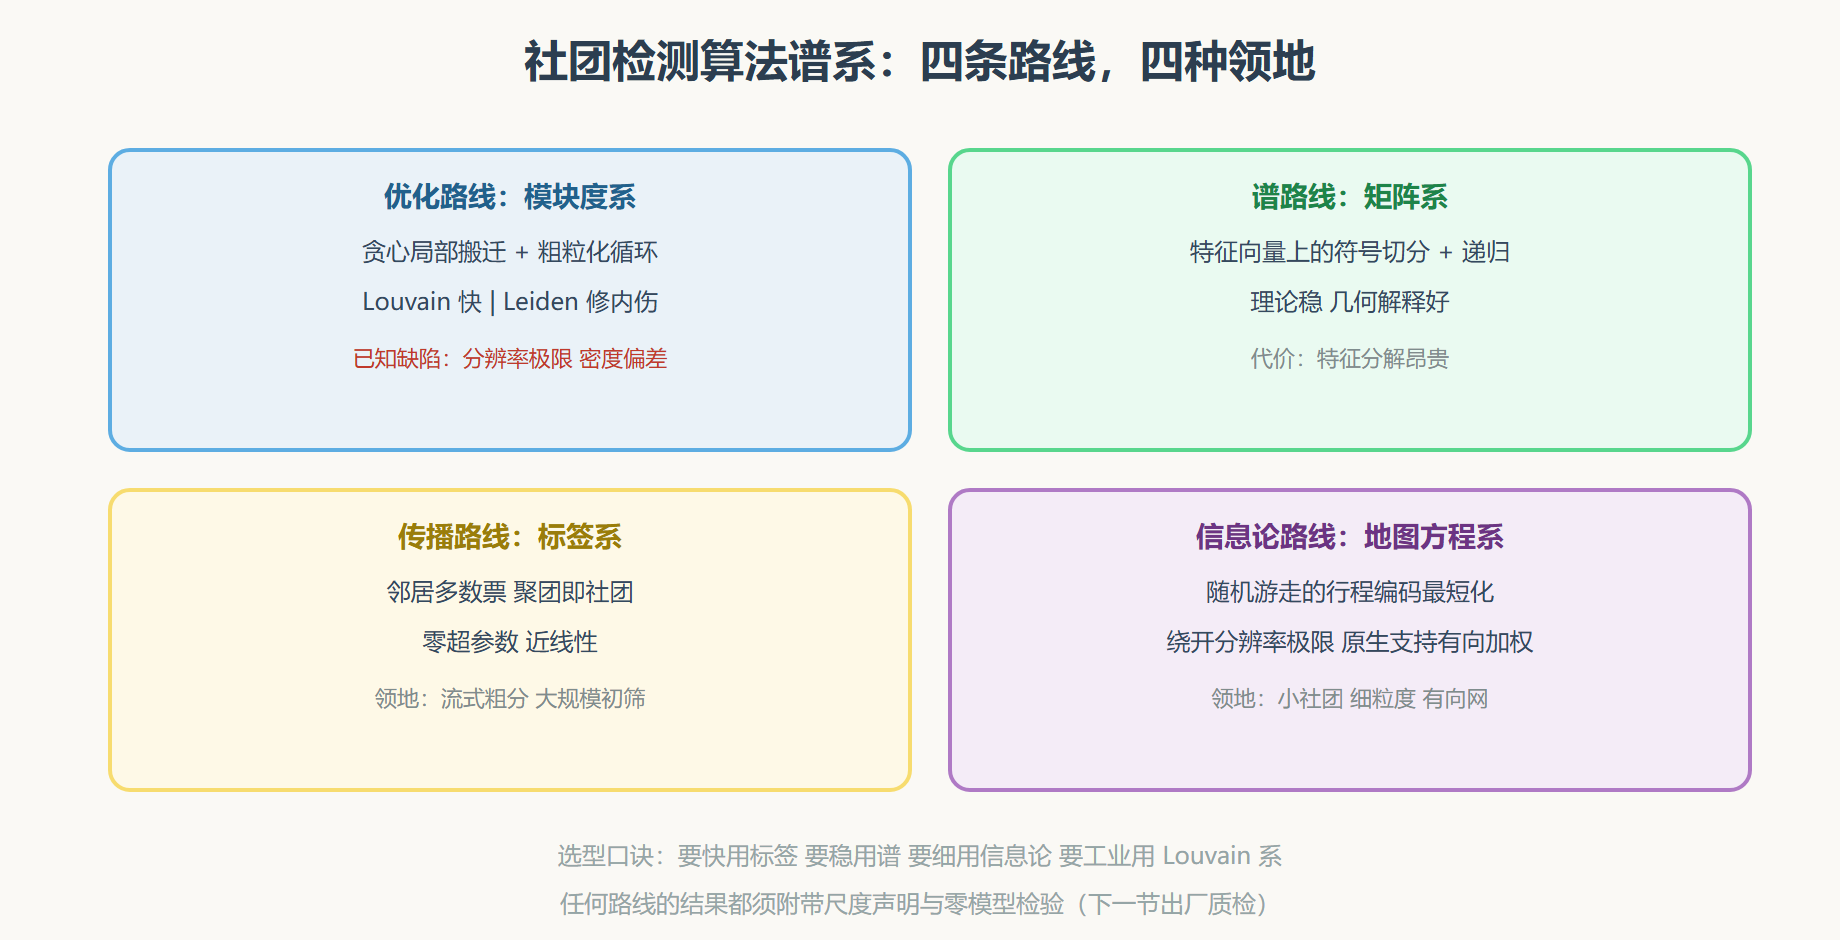
优化路线不是独木桥,另外三条各有领地。谱聚类从矩阵特征向量里读结构:模块度矩阵(或拉普拉斯矩阵)的次大特征向量把节点映射到一维,符号天然分两半,递归下去可得多社团——理论漂亮、与线性代数打通,适合社团数不多、需要稳定几何解释的场合;代价是特征分解昂贵,大网要靠稀疏迭代。标签传播走无参数快车道:每个节点随机领标签,每轮改成邻居中最流行的标签,几轮之内标签自动聚团——近线性复杂度、零超参数,流式数据的粗分用它;代价是不稳定(同网不同轮次可能微调结果)。地图方程换掉整个价值体系:不做「实际减期望」,改问「随机游走者在这张网上走,用这套划分做行程编码,描述长度能压多短」——信息论准则绕开了模块度的分辨率极限(理论上能找到更小的社团),对有向加权网也原生友好,Infomap 是其旗舰实现。三路线选型口诀:要快用标签、要稳用谱、要细用信息论、要工业用 Louvain 系。
import networkx as nx # 同一网络,三种口径的粒度对比 G = nx.karate_club_graph() lv = nx.community.louvain_communities(G, seed=7) greedy = nx.community.greedy_modularity_communities(G, resolution=0.5) lp = list(nx.community.label_propagation_communities(G)) print("Louvain 社团数:", len(lv)) print("低分辨率贪心 社团数:", len(greedy)) print("标签传播 社团数:", len(lp))
分辨率参数降低后社团数变少——粒度旋钮的存在提醒我们:社团是相对尺度上的概念,报告结果必须附带尺度声明,这与第 3 章「社团是密度对比」的形态学定义严格一致。
图 算法谱系与选型地图
边界工位:重叠、动态与评价
真实系统的社团并不守硬边界规矩,车间单设边界工位。重叠社团:节点身兼多团(人属于家庭也属于公司),派系渗流法(相邻完全图滚动成团)与链接聚类(把「边」而非节点分团,节点因边不同而多重身份)是两条代表思路。动态社团:时序快照间的社团有生灭合并,匹配—追踪流水线把静态检测器串成时间线,第 8 章时序网络一节回收。质量评价:有真值时比一致性(如互信息),无真值时比稳定性(同参数重跑的共识度)与零模型显著性——模块度读数本身也要过保度零模型这一关,否则「检测出社团」可能只是「检测出了度序列」。这句话是下一节的开场白。
⚠️ 常见坑一:报告模块度不说参照。稠密随机图也能刷出零点几的模块度,显著性要靠与保度零模型的差距说话。
⚠️ 常见坑二:把分辨率参数当自由度反复调到结果好看。粒度选择应由问题尺度决定(蛋白复合物还是细胞通路?兴趣圈还是文化圈?),事后调参要披露。
本站收束
- 模块度 = 组内边实际占比减保度随机期望占比,是随机对照思想的函数化
- Louvain 两阶段流水线(搬迁 + 粗粒化)近线性可扩展,Leiden 修正其连通性与局部最优毛病
- 谱、标签传播、地图方程各占领地;信息论准则绕开分辨率极限
- 社团是相对尺度的概念,输出必须带尺度声明;重叠与动态是两个活跃边界
- 检测结果的显著性最终要过零模型——这正是下一节整节的主题
切块仪表装好了,但「切出来的社团、量出来的聚类,到底比随机特殊多少」——这个问题需要一整台质检机。下一节:零模型比对。