6.1 博弈的语言:策略、收益与理性
6.1 博弈的语言:策略、收益与理性
摘要:博弈论给"多个自利个体的交互"提供数学建模语言。本节拆解标准式博弈三元组(玩家、策略、收益)与扩展式博弈树两种记法,讲理性的层级与共同知识假设,辨析帕累托最优与个体理性——个人最优的加总为何未必是集体最优。
冯·诺伊曼给经济学留下的那句判断常被引用:如果把"博弈"理解为一群利益相关者按规则互动的任何局面,那经济学、政治学、生物学乃至日常争吵,研究的其实是同一种对象。会馆开馆第一课不发筹码先发词典:要把"算计"变成能计算的学问,先得有一套记法。这一节属于全册的理论地基——第 3 章的协商桌、第 5 章的法庭、前面的合同网与声誉档案,在会馆里都将被重写成一张收益矩阵或一棵博弈树。
标准式:一张矩阵说清一局
最常用的记法是标准式(策略式)博弈,一个三元组:玩家集(谁在局中)、每个玩家的策略集(各自能出什么牌)、收益函数(每个策略组合下各家拿多少)。两人有限策略的博弈画成矩阵最直观:行是甲的策略,列是乙的策略,格子里的数对是(甲收益,乙收益)。
小镇水源争用的例子。两户人家共享一条溪,各自决定"多取水"还是"少取水":都少取,溪流常青各得安稳;都多取,水位暴跌两家都要花钱打井;一方多取一方少取,多取的占便宜、少取的吃亏。写进矩阵:
| 乙:少取 | 乙:多取 | |
|---|---|---|
| 甲:少取 | 3, 3 | 1, 4 |
| 甲:多取 | 4, 1 | 2, 2 |
矩阵里每个格子的第一个数是甲的收益,第二个是乙的。这张小桌子下一节还要反复用——它就是著名的囚徒困境的水资源版。
扩展式:一棵树说清先后
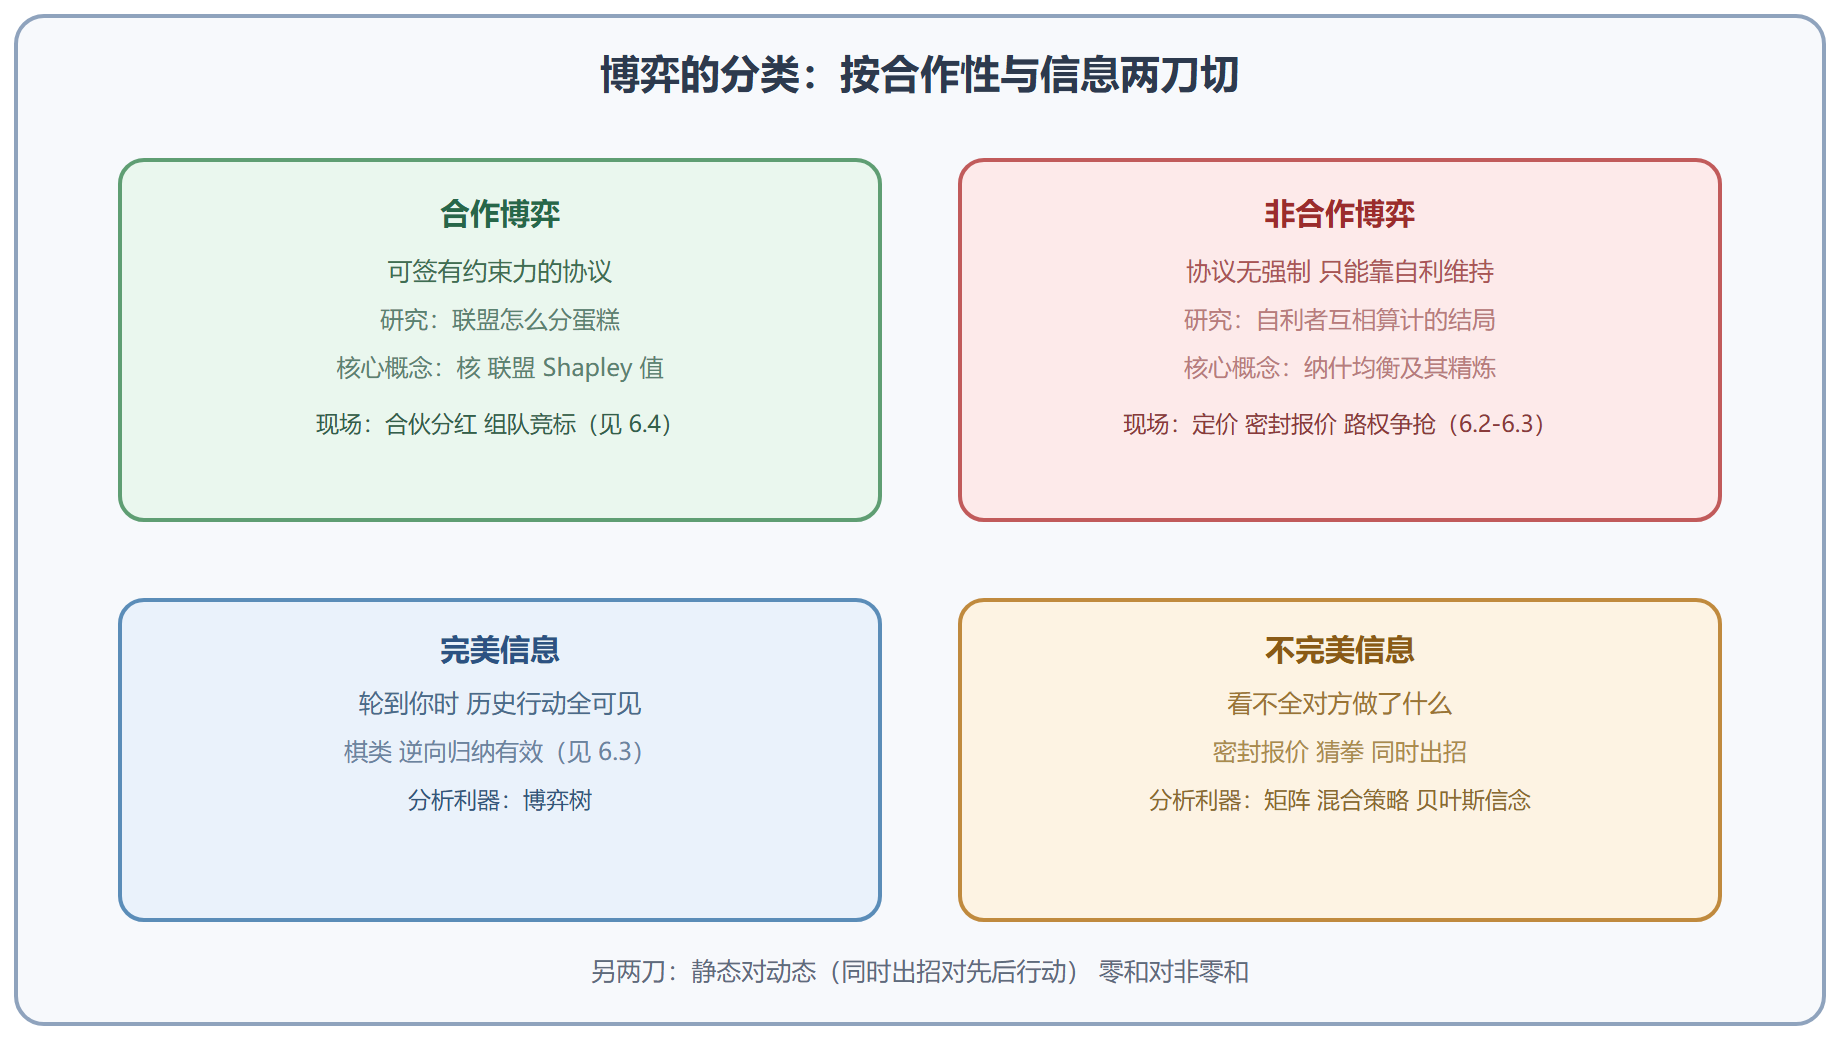
交互有先后次序、信息有遮蔽差异时,矩阵不够用,改画博弈树:节点是决策点(轮到谁出牌),枝是可选行动,叶子是终局收益。树上还能标注信息集——轮到你时你看得见什么:看得到对方刚出什么牌叫完美信息(棋类),看不到叫不完美信息(密封报价)。标准式与扩展式可以互相转换,前者便于代数分析,后者便于讲清时序与承诺。
理性:一个层层加码的假设
博弈论的引擎是理性假设:玩家追求自身收益最大化,且对博弈结构(玩家、策略、收益)了如指掌。但这还不够狠——我要预判你的行动,就得假设你也是理性的;你要预判我对你的预判,就得假设"我知道你知道我理性"。这条递归链走到头叫共同知识:不仅人人理性,而且"人人都知道人人都理性"这件事本身也人人皆知。真实世界里的镇民(无论碳基硅基)常常止步于二三层——这正是有限理性与行为博弈论的入口,也是第 6.5 节演化方法放松掉的假设。
图 6-1 博弈分类地图:会馆的房型图
两把评价尺子:帕累托最优与个体理性
有了矩阵与树,就能给结局打分。帕累托最优:不存在别的结局能让某个玩家更好而不伤别人。(3, 3) 的溪流常青在水源博弈里是帕累托最优之一——想让任何一家超过三分,另一家就得掉到一分。个体理性:参与博弈至少不比退出(保留效用)差,收益低于底线的局面理性玩家根本不会接受。
两把尺子经常打架,这正是会馆存在的原因。回到水源矩阵:每家单独看,"多取"都是硬道理——不管对方怎么选,多取的收益都更高(4 大于 3,2 大于 1)。于是两个理性人双双多取,落到 (2, 2)——比 (3, 3) 双双更差,却比一方单方面少取的 (1, 4) 体面。个人最优的加总不是集体最优,这句话的数学化就是下一节的囚徒困境,工程化就是前面五章所有协调机制的必要性证明。
💡 关键直觉:读收益矩阵先找"无论对方出什么我都更好"的策略(占优策略),再找"给定对方选择我最优"的策略(最佳响应)。前者是后者的特例;占优策略存在时,理性玩家没有悬念——而正是这种"没有悬念",常常把大家推进集体次优的坑。
代码实验:把矩阵装进机器
分析博弈之前先会表示博弈。下面的代码定义标准式博弈、检查占优策略、枚举所有结局并标出帕累托最优——这是本章后面所有实验的公共底座。
from itertools import product class Game: """标准式博弈:玩家甲乙的策略名与收益矩阵。""" def __init__(self, row_moves, col_moves, payoffs): self.row_moves, self.col_moves = row_moves, col_moves self.pay = payoffs # pay[r][c] = (甲收益, 乙收益) def cell(self, r, c): return self.pay[r][c] def dominant(self, player): """找 player 的弱占优策略:对对手的每种选择都不劣于其他选择。""" my_moves = self.row_moves if player == 0 else self.col_moves opp_n = len(self.col_moves) if player == 0 else len(self.row_moves) dom = [] for i, mv in enumerate(my_moves): if player == 0: # 行玩家:每列里都得并列最高 ok = all(self.pay[i][j][player] >= max(self.pay[k][j][player] for k in range(len(my_moves))) - 1e-9 for j in range(opp_n)) else: # 列玩家:每行里都得并列最高 ok = all(self.pay[j][i][player] >= max(self.pay[j][k][player] for k in range(len(my_moves))) - 1e-9 for j in range(opp_n)) if ok: dom.append(mv) return dom def pareto_front(self): """枚举全部结局,标出帕累托最优的格子。""" cells = [(self.pay[r][c], r, c) for r in range(len(self.row_moves)) for c in range(len(self.col_moves))] front = [] for u, r, c in cells: dominated = any( v[0] >= u[0] and v[1] >= u[1] and (v[0] > u[0] or v[1] > u[1]) for v, _, _ in cells) if not dominated: front.append((self.row_moves[r], self.col_moves[c], u)) return front water = Game(["少取", "多取"], ["少取", "多取"], [[(3, 3), (1, 4)], [(4, 1), (2, 2)]]) print("甲的占优策略:", water.dominant(0)) print("乙的占优策略:", water.dominant(1)) print("帕累托最优结局:", water.pareto_front())
跑出来你会看到:两家的占优策略都是"多取",而帕累托前沿上站着的是 (3, 3) 与两个不对称结局——占优逻辑指向的 (2, 2),恰恰被帕累托前沿开除。个人理性与集体理性的裂缝,被几行代码拍在案上。
def best_response_set(game, player, opp_move_idx): """给定对手选定某策略,返回我的最佳响应集合。""" if player == 0: col = [game.pay[r][opp_move_idx][0] for r in range(len(game.row_moves))] m = max(col) return [game.row_moves[i] for i, v in enumerate(col) if abs(v - m) < 1e-9] else: row = [game.pay[opp_move_idx][c][1] for c in range(len(game.col_moves))] m = max(row) return [game.col_moves[i] for i, v in enumerate(row) if abs(v - m) < 1e-9] print("若乙少取,甲的最佳响应:", best_response_set(water, 0, 0)) print("若乙多取,甲的最佳响应:", best_response_set(water, 0, 1)) print("若甲多取,乙的最佳响应:", best_response_set(water, 1, 1))
最佳响应是下一节的门票:纳什均衡就是"互为最佳响应"的策略组合——甲的选择是对乙的最佳响应,乙的选择也是对甲的最佳响应,谁单方面改主意谁吃亏。
沙盘推演小结
会馆的地基浇筑完毕:矩阵与树两种记法、理性与共同知识的层层假设、帕累托与个体理性两把尺子、占优与最佳响应两件分析工具。词典已发,下一节正式开盘:把"没有人愿意单方面改变"这个力学平衡点找出来。