6.2 纳什均衡:静态博弈的稳定解
6.2 纳什均衡:静态博弈的稳定解
摘要:纳什均衡是"没有玩家愿意单方面偏离"的策略组合——互为最佳响应的交点。本节讲均衡的定义与划线求法、囚徒困境的结构性悲剧、混合策略的存在性与求法(无差异原理)、均衡多重带来的选择难题,并用代码实现纯均衡自动求解与混合均衡的仿真验证。
一位年轻的数学家在博士论文里写下一个不到三十页的证明,从此给"稳定"这个词找到了数学定义——后来所有人提到均衡,说的都是他的名字。会馆第二课开盘讲纳什均衡:上一节我们备好了词典与尺子,这一节找博弈的"力学平衡点"。上一节的水源矩阵已经暗示了结局:两家都多取、双双吃亏却谁也不肯单方面收手——那个格子,就是均衡。
均衡的定义:互为最佳响应
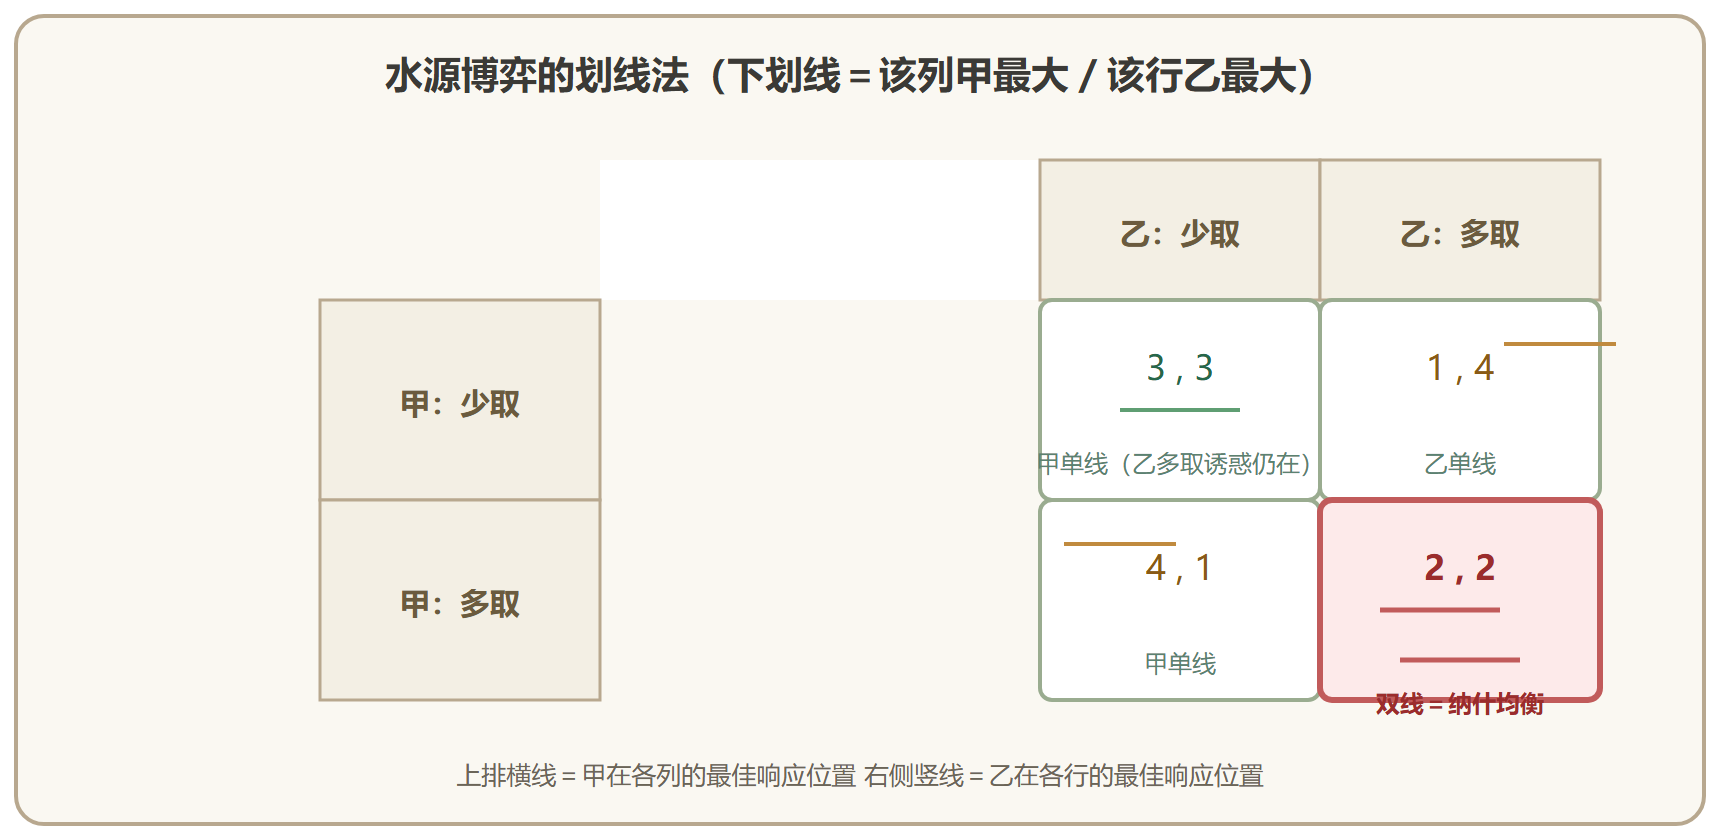
策略组合是纳什均衡,当且仅当每个玩家的策略都是对其他人策略的最佳响应。换句大白话:局面摆定之后,任何一家单独改变主意都占不到便宜。注意三个关键词——单方面(不考虑串通改)、偏离无利(不是"不能更好"而是"不想更好")、稳定(均衡是惯性点,不是道德高点)。(2, 2) 的"双双多取"满足定义:给定对方多取,我改少取从 2 掉到 1,没人动。而 (3, 3) 的"双双少取"不是均衡:给定对方少取,我改成多取能从 3 涨到 4,守约的心随时会被诱惑撬走。
手求纯策略均衡用划线法:在每一列里给甲的最大收益划线,在每一行里给乙的最大收益划线,双线格子即均衡。划线本质是逐格检查最佳响应——下面代码把它自动化。
图 6-2 划线法求解:双线格子即均衡
囚徒困境:结构性悲剧的解剖
水源博弈的一般化就是囚徒困境,它的结构值得背下来:对每个玩家,背叛(多取)严格占优;均衡落点对双方都劣于合作结局。三个推论划出它的边界——重复可以破局(下一节)、外部执行可以破局(第 3 章的制度、第 5 章的法庭把违约变得不划算)、人数变化会加重病情(公共品供给,多人博弈里搭便车更隐蔽)。识别囚徒困境结构的工程口诀:看到"占优策略指向集体次优",别急着骂镇民自私,先问博弈的规则能不能改——这正是第 6.4 节机制设计的出场预告。
混合策略:当没有纯均衡时
猜拳(石头剪刀布)没有纯策略均衡:任何固定出法都会被克制。这类博弈的均衡在混合策略里——玩家按概率分布随机出招。求法是无差异原理:我方混合的概率要调到让对方各纯策略的期望收益相等(对方怎么选都一样,才没有可乘之机),对称地,对方也这么调。猜拳的答案是对各出三分之一;均衡时谁都无法剥削谁,期望收益打平。
纳什的传奇定理保证了普适性:任何有限博弈都存在至少一个均衡(纯策略或混合策略)。定理不保证唯一,也不保证"找得到"——一般博弈求均衡的计算复杂度是另一个世界(后文账本里记这笔)。
代码实验一:纯策略均衡自动求解
把划线法写成代码:枚举所有组合,检查双方是否都在自己的最佳响应集合里。
def find_pure_equilibria(pay, row_moves, col_moves): """枚举全部格子,返回互为最佳响应的策略组合。""" eq = [] for i in range(len(row_moves)): for j in range(len(col_moves)): best_row = max(pay[r][j][0] for r in range(len(row_moves))) best_col = max(pay[i][c][1] for c in range(len(col_moves))) if (abs(pay[i][j][0] - best_row) < 1e-9 and abs(pay[i][j][1] - best_col) < 1e-9): eq.append((row_moves[i], col_moves[j], pay[i][j])) return eq water = [[(3, 3), (1, 4)], [(4, 1), (2, 2)]] print("水源博弈均衡:", find_pure_equilibria(water, ["少取", "多取"], ["少取", "多取"])) coord = [[(5, 5), (0, 4)], [(4, 0), (5, 5)]] # 协调博弈:都想同边 print("协调博弈均衡:", find_pure_equilibria(coord, ["码头", "广场"], ["码头", "广场"])) rps = [[(0, 0), (-1, 1), (1, -1)], [(1, -1), (0, 0), (-1, 1)], [(-1, 1), (1, -1), (0, 0)]] # 猜拳 print("猜拳纯均衡:", find_pure_equilibria(rps, ["石", "剪", "布"], ["石", "剪", "布"]))
三个博弈三种命运:水源博弈一个"坏"均衡,协调博弈两个"好"均衡(多重性来了),猜拳零个纯均衡(混合策略接盘)——一张代码把均衡理论的三大主题全跑了出来。
代码实验二:混合均衡的求与验
对猜拳类博弈用无差异原理解混合概率,再用随机仿真验证:均衡混合对任何固定对手都不吃亏,偏离均衡则会被剥削。
import random BEAT = {"石": "剪", "剪": "布", "布": "石"} # 我的出法 -> 它克制的出法 IDXS = ["石", "剪", "布"] def play_once(a_move, b_move): if a_move == b_move: return 0 return 1 if BEAT[a_move] == b_move else -1 def best_response_to(strategy): """给定对手混合(或固定)策略,找期望收益最高的纯响应。""" best, best_ev = None, None for my in IDXS: ev = sum(play_once(my, opp) * w for opp, w in zip(IDXS, strategy)) if best_ev is None or ev > best_ev: best, best_ev = my, ev return best, best_ev def simulate(a_mix, b_mix, rounds=30000, seed=5): random.seed(seed) score = 0 for _ in range(rounds): a = random.choices(IDXS, weights=a_mix)[0] b = random.choices(IDXS, weights=b_mix)[0] score += play_once(a, b) return score / rounds eq = [1/3, 1/3, 1/3] # 均衡混合 biased = [0.7, 0.2, 0.1] # 偏爱出石的离经叛道者 br_eq, ev_eq = best_response_to(eq) br_biased, ev_biased = best_response_to(biased) print(f"对均衡混合的最优响应: {br_eq} 期望 {ev_eq:+.3f}") print(f"对偏石混合的最优响应: {br_biased} 期望 {ev_biased:+.3f}") paper = [0, 0, 1] # 克制石头:一直出布 print("布 对 均衡混合 实测:", round(simulate(paper, eq), 3)) print("布 对 偏石混合 实测:", round(simulate(paper, biased), 3))
戏眼在最后两行:同样一手"永远出布",打均衡混合颗粒无收(理论上恰好打平),打偏石混合则大赚——均衡混合把对手的一切响应都"抹平"到无差异,这正是无差异原理的另一面;谁偏离均衡,偏离本身就成了对手的利润来源。
⚠️ 常见坑:把纳什均衡当预测。均衡是"稳定点"不是"必然结果"——真实玩家(尤其是学习中的智能体)可能在均衡间游移、卡在次优习惯上;均衡多重时(协调博弈),"哪一个均衡会被选中"本身就是问题,焦点效应、沟通与惯例都在起作用。第 7 章会看到:学习算法收敛到哪个均衡,取决于初始条件与学习率的工程细节。
理论账本
纳什均衡的两笔大账。资产:普适存在定理(有限博弈必有解)、自执行性(不需要外部强制者,自利本身就维持均衡)、可计算验证(给定候选策略组合,检查均衡性是多项式的)。负债:多重性(协调博弈选边靠文化习俗)、非唯一预测(均衡筛选理论一大堆:风险占优、收益占优、颤抖手)、计算复杂度(一般博弈找均衡是 PPAD 完全,通俗讲:别指望大规模博弈的精确均衡解)、理性假设过强(6.5 节演化路线来救)。工程用法由此清楚:小博弈精确求解,大博弈近似或学习逼近(第 7 章),制度设计直接构造"说真话即均衡"(6.4 节)。
沙盘推演小结
会馆的墙上挂出了第一张牌桌速查图:找均衡先划线,双线格子是稳定点;没双线就翻概率,无差异原理调混合。镇长看着"双双多取"的均衡格子皱起了眉——个人都稳、集体受伤,这张桌子本身有问题。下一节把桌子换成牌局的长跑:让博弈重复、让历史可见,看"未来的报复"能否把合作钉进均衡。