6.3 动态与重复博弈:可信威胁与合作的诞生
6.3 动态与重复博弈:可信威胁与合作的诞生
摘要:行动有先后、博弈有历史时,静态均衡概念会放过"说大话"的策略。本节讲博弈树上的逆向归纳与子博弈完美均衡(剔除不可信威胁)、承诺装置如何把空话变成实力,以及重复博弈里合作均衡的诞生条件(贴现因子、触发策略、无名氏定理),用代码实现逆向归纳与一场重复囚徒困境策略锦标赛。
别被纸面上的威胁吓住——除非对方为这个威胁付过真金白银。会馆第三课讲时间:上一节的矩阵把所有选择当作同时发生,可真实交互有先来后到、有历史记录。把时间加进来,一半的"狠话"会现出原形,另一半的合作会凭空出现。本节同时收编旧教程"重复博弈"一讲的全部内容:一锤子买卖里的背叛逻辑,如何被"来日方长"四个字改写。
博弈树上的倒推法
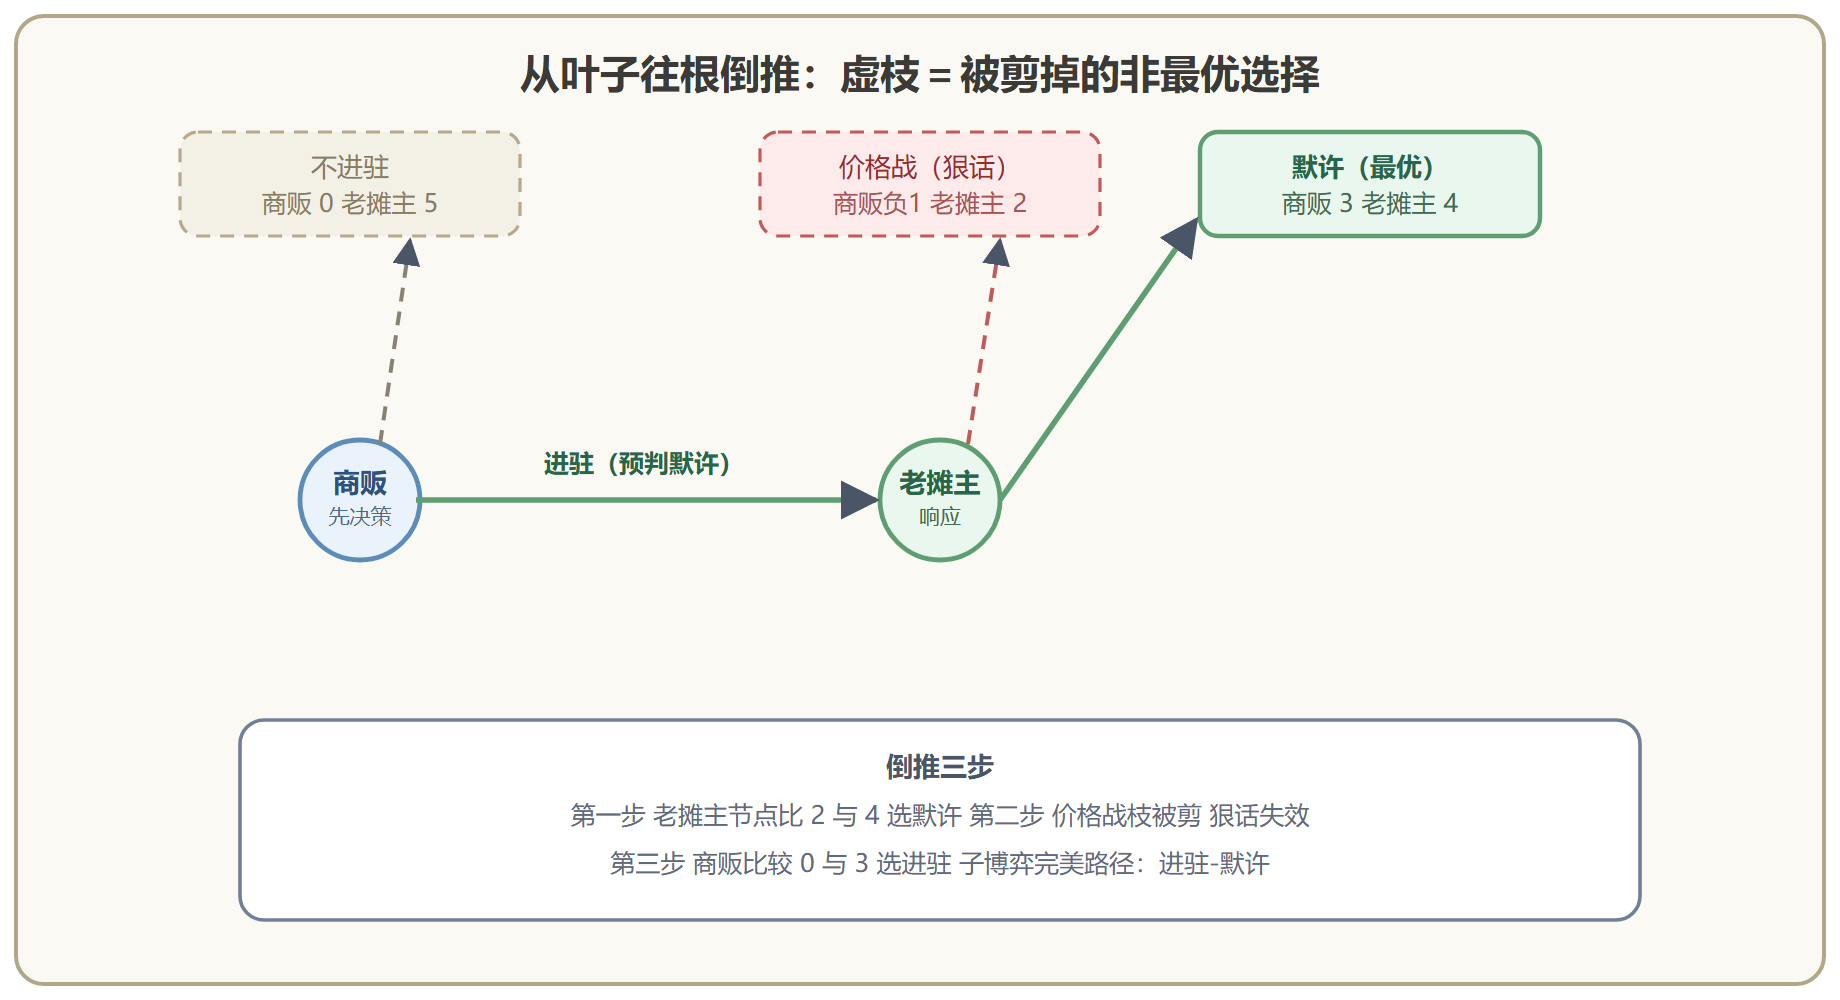
先看一个静态分析会吃亏的例子。外来商贩考虑要不要进驻小镇集市:他先进(或不进),本地老摊主随后决定"打价格战"还是"默许分享"。收益:不进,商贩得零、老摊主安稳得五;进了被价格战,两败俱伤(负一与二);进了被默许,双双得三与四。
老摊主的狠话是:"你敢来我就打价格战,让你血本无归。"静态思维会被吓退;动态分析倒着推:先看最后一个决策点——真到商贩已进驻的节点,老摊主打价格战得二、默许得四,理性老摊主会默许。预判到这一点,商贩在第一个节点比较:不进得零、进得三——进。倒推的结论与狠话相反:威胁不可信,因为它到兑现时不合算。
这个"从叶子往根倒推、每层取最优"的方法就是逆向归纳,它算出的均衡叫子博弈完美均衡——要求策略在每一个子博弈(树的每个决策点往下的部分)上都是最优的,不单单是全局。纳什均衡只查全树,子博弈完美连每个岔路口都查,于是能把"计划到不了的地方说大话"的策略筛掉。完美信息有限博弈里逆向归纳必定收敛,这是动态博弈的基本功。
图 6-3 市场进驻博弈的逆向归纳
承诺装置:把空话变成实力
狠话不可信,是因为兑现时不合算。想让威胁可信,就得改变兑现时的收益——这叫承诺装置。老摊主若当众签下"凡有外摊进驻、摊位费全额补贴老户打价格战"的合约(相当于自缚双手),价格战从亏本选项变成义务,商贩的倒推随之改写。历史与商战里这类"自断退路以立信"的操作屡见不鲜:破釜沉舟、公开烧掉退路、缴纳不可退还的保证金。第 5 章法庭的"保证金"、第 3 章合同网的"违约金",机制上全是承诺装置——可信性是可以购买的,价格是预先放弃的选择权。
重复博弈:来日方长改写一切
现在把一锤子买卖拉长成一世交道。同样的阶段博弈(比如囚徒困境)重复进行,每轮之间历史公开,这就是重复博弈。关键参数是贴现因子:明天的收益在今天值多少(零到一之间,越接近一越有耐心)。重复带来两样新武器:奖励(你合作我下轮继续合作)与惩罚(你背叛我下轮报复)。当贴现因子足够高——未来足够值钱——"未来报复的现值"超过当期背叛的甜头,合作就成为均衡行为。无名氏定理的通俗版:贴现够高时,几乎所有"个体理性以上"的收益都能被某个均衡支撑——合作不需要道德,只需要足够长的影子。
支撑合作的常用策略是触发策略:冷醋策略(grim trigger,你背叛一次我就永远背叛)与以牙还牙(tit-for-tat, copying 对方上一轮的动作:先合作,然后人家干嘛我干嘛)。政治学者阿克塞尔罗德当年办过一场著名的策略锦标赛,邀请各方提交重复囚徒困境策略循环对打,结果最简单朴素的以牙还牙夺冠——它的成功四要素至今被引用:善良(不首先背叛)、可激怒(立刻报复)、宽容(对方回头就恢复合作)、清晰(行为模式容易被识别)。
代码实验一:逆向归纳自动化
把市场进驻博弈写成树结构,从叶子倒推剪枝,输出子博弈完美路径。
class Node: """决策节点:行动 -> 子节点;叶子:payoff 元组。""" def __init__(self, player=None, payoff=None): self.player, self.payoff = player, payoff self.branches = {} # 行动名 -> Node def add(self, action, child): self.branches[action] = child return child def backward(node, path=()): """逆向归纳:返回(最优收益, 均衡路径)。""" if node.payoff is not None: return node.payoff, path results = {a: backward(child, path + (a,)) for a, child in node.branches.items()} best_action = max(results, key=lambda a: results[a][0][node.player]) return results[best_action] root = Node(player=0) # 商贩 stay_out = root.add("不进驻", Node(payoff=(0, 5))) enter = root.add("进驻", Node(player=1)) # 老摊主 enter.add("价格战", Node(payoff=(-1, 2))) enter.add("默许", Node(payoff=(3, 4))) payoff, path = backward(root) print("子博弈完美路径:", " -> ".join(path), " 收益:", payoff) # 老摊主加装承诺装置:价格战收益被合约抬高到五 enter.branches["价格战"].payoff = (-1, 5) payoff2, path2 = backward(root) print("承诺装置后路径:", " -> ".join(path2), " 收益:", payoff2)
对比两条路径:没有承诺时商贩进驻、老摊主默许;老摊主自缚双手抬高价格战收益后,狠话变成可信威胁——商贩倒推改判"不进驻"。承诺装置花的是自己的选择权,买的是对手的决策。
代码实验二:重复囚徒困境锦标赛
让四名选手循环对打重复囚徒困境:以牙还牙、冷醋、永远背叛、随机。每轮得分矩阵用上一节的水源版(合作三对三,双双背叛二对二,单方背叛四对一),轮数与贴现因子可调。
import random def stage_move(strategy, my_hist, opp_hist, rng): if strategy == "always-defect": return "多取" if strategy == "random": return rng.choice(["少取", "多取"]) if strategy == "tit-for-tat": return "少取" if not opp_hist else opp_hist[-1] if strategy == "grim": return "多取" if "多取" in opp_hist else "少取" raise ValueError(strategy) PAY = {("少取", "少取"): (3, 3), ("少取", "多取"): (1, 4), ("多取", "少取"): (4, 1), ("多取", "多取"): (2, 2)} def duel(s1, s2, rounds=50, discount=0.9, seed=17): rng = random.Random(seed) h1, h2, v1, v2 = [], [], 0.0, 0.0 for t in range(rounds): m1 = stage_move(s1, h1, h2, rng) m2 = stage_move(s2, h2, h1, rng) p1, p2 = PAY[(m1, m2)] v1 += (discount ** t) * p1 # 未来收益打折 v2 += (discount ** t) * p2 h1.append(m1); h2.append(m2) return v1, v2 field = ["tit-for-tat", "grim", "always-defect", "random"] totals = {s: 0.0 for s in field} for i, a in enumerate(field): for j, b in enumerate(field): if i < j: va, vb = duel(a, b) totals[a] += va; totals[b] += vb for s, v in sorted(totals.items(), key=lambda kv: -kv[1]): print(f"{s:15s} 总分 {v:8.1f}")
典型跑分值得细读:冷醋与以牙还牙靠互相合作领跑;耐人寻味的是"永远背叛"咬得很紧——它先骗走善良策略第一轮的便宜,之后虽然被拉进互相背叛的泥潭,靠那份不义之财仍能挂在榜上。这不是理论的漏洞而是生态的真相:剥削型策略的排名取决于场上善良策略的密度,把参赛名单加厚(更多愿意合作的策略),剥削者的相对位置就会滑落;场上全是背叛者时大家一起沉底。另一个细节是以牙还牙对随机选手的无奈——对方的乱拳会触发连环回声,这正是它"零宽容于噪声"的软肋,宽容变体(对方连着两次背叛才反击)在嘈杂环境里更稳。把贴现因子调低再跑:未来不值钱,惩罚的威慑缩水,合作策略的排名应声下滑。合作的出现不靠人性,靠贴现因子撑起的"未来的重量"。
⚠️ 常见坑:以为"重复"自动等于"合作"。贴现因子低(对方只看眼前)、博弈终止期已知且临近(末期背叛无可惩罚,倒推回开头全线崩溃—— finite horizon 谜题)、或历史不可观察(没法定位背叛者)时,合作照样瓦解。第 5 章的声誉档案与本章的触发策略是同一件事的两副面孔:都是把历史变现成当期威慑。
💡 关键直觉:把第 5.3 节的声誉系统放到会馆里再看一遍——它其实是"社区帮你记账的触发策略"。档案让每个镇民都默认在跟"重复博弈里的同一个对手"打交道,女巫攻击想做的正是"假装换了对手"以逃避历史。机制与理论在这里严丝合缝。
理论账本
重复博弈的资产栏:合作的均衡化(无名氏定理给出巨大的可支撑集)、触发策略的极简实现(一行代码的策略能支撑市场秩序)、声誉与承诺的理论根基。负债栏:均衡爆炸(无名氏定理的另一面——能支撑的收益太多,预测力反而稀释)、有限期倒推崩溃(理论上末期必背叛,现实里靠不确定性或不完全理性续命)、观察噪声的脆弱性(以牙还牙在误会频发的环境里会陷入互相报复的死循环,宽容版"以两报还一牙"更稳健)。工程取舍由此来:真实系统里贴现因子对应"关系持续的期望",把长期关系的期望做厚(会员制、押金、声誉档案),就是在抬高系统的贴现因子。
沙盘推演小结
会馆的长桌今晚坐满了熟客:摊主与常客心照不宣地互相让利——他们都知道明天还要见面。新来的骗子试探了一轮,第二天全市场的冷眼让他明白贴现因子的分量。镇长在本子上记下两行:狠话要配上保证金才可信,合作要配上记忆才持久。下一节轮到会馆最有权势的人物出场——规则制定者:不研究怎么在牌桌上赢,而研究怎么设计牌桌。