第一章 大模型会什么、不会什么
第一章 · 大模型会什么、不会什么
本章要回答的三个问题:智能体和聊天机器人到底差在哪?大模型的真实能力边界画在哪里?让它从"能聊"走到"能干",具体卡在哪几件事上?
为什么会有这一章
市面上讲智能体的内容,大多一上来就堆框架和名词,读者跟着跑通了示例,却说不清自己到底多了什么能力。这一章反着来:先不写任何代码框架,而是把家底摊开盘点——模型作为"大脑"强在哪、弱在哪。盘点的意义在于,后面每一章的每个设计决策,都能追溯到某个具体的"不会":不会动手所以要有工具调用,记不住事所以要有记忆,不会拆事所以要有规划。把缺口定位准了,技术方案才不是玄学。
另一个现实原因是成本。团队里最常见的浪费,是拿智能体方案去解决聊天就能解决的问题,或者反过来,指望一个聊天接口直接完成多步任务。边界画得越清楚,选型失误越少。
本章全景
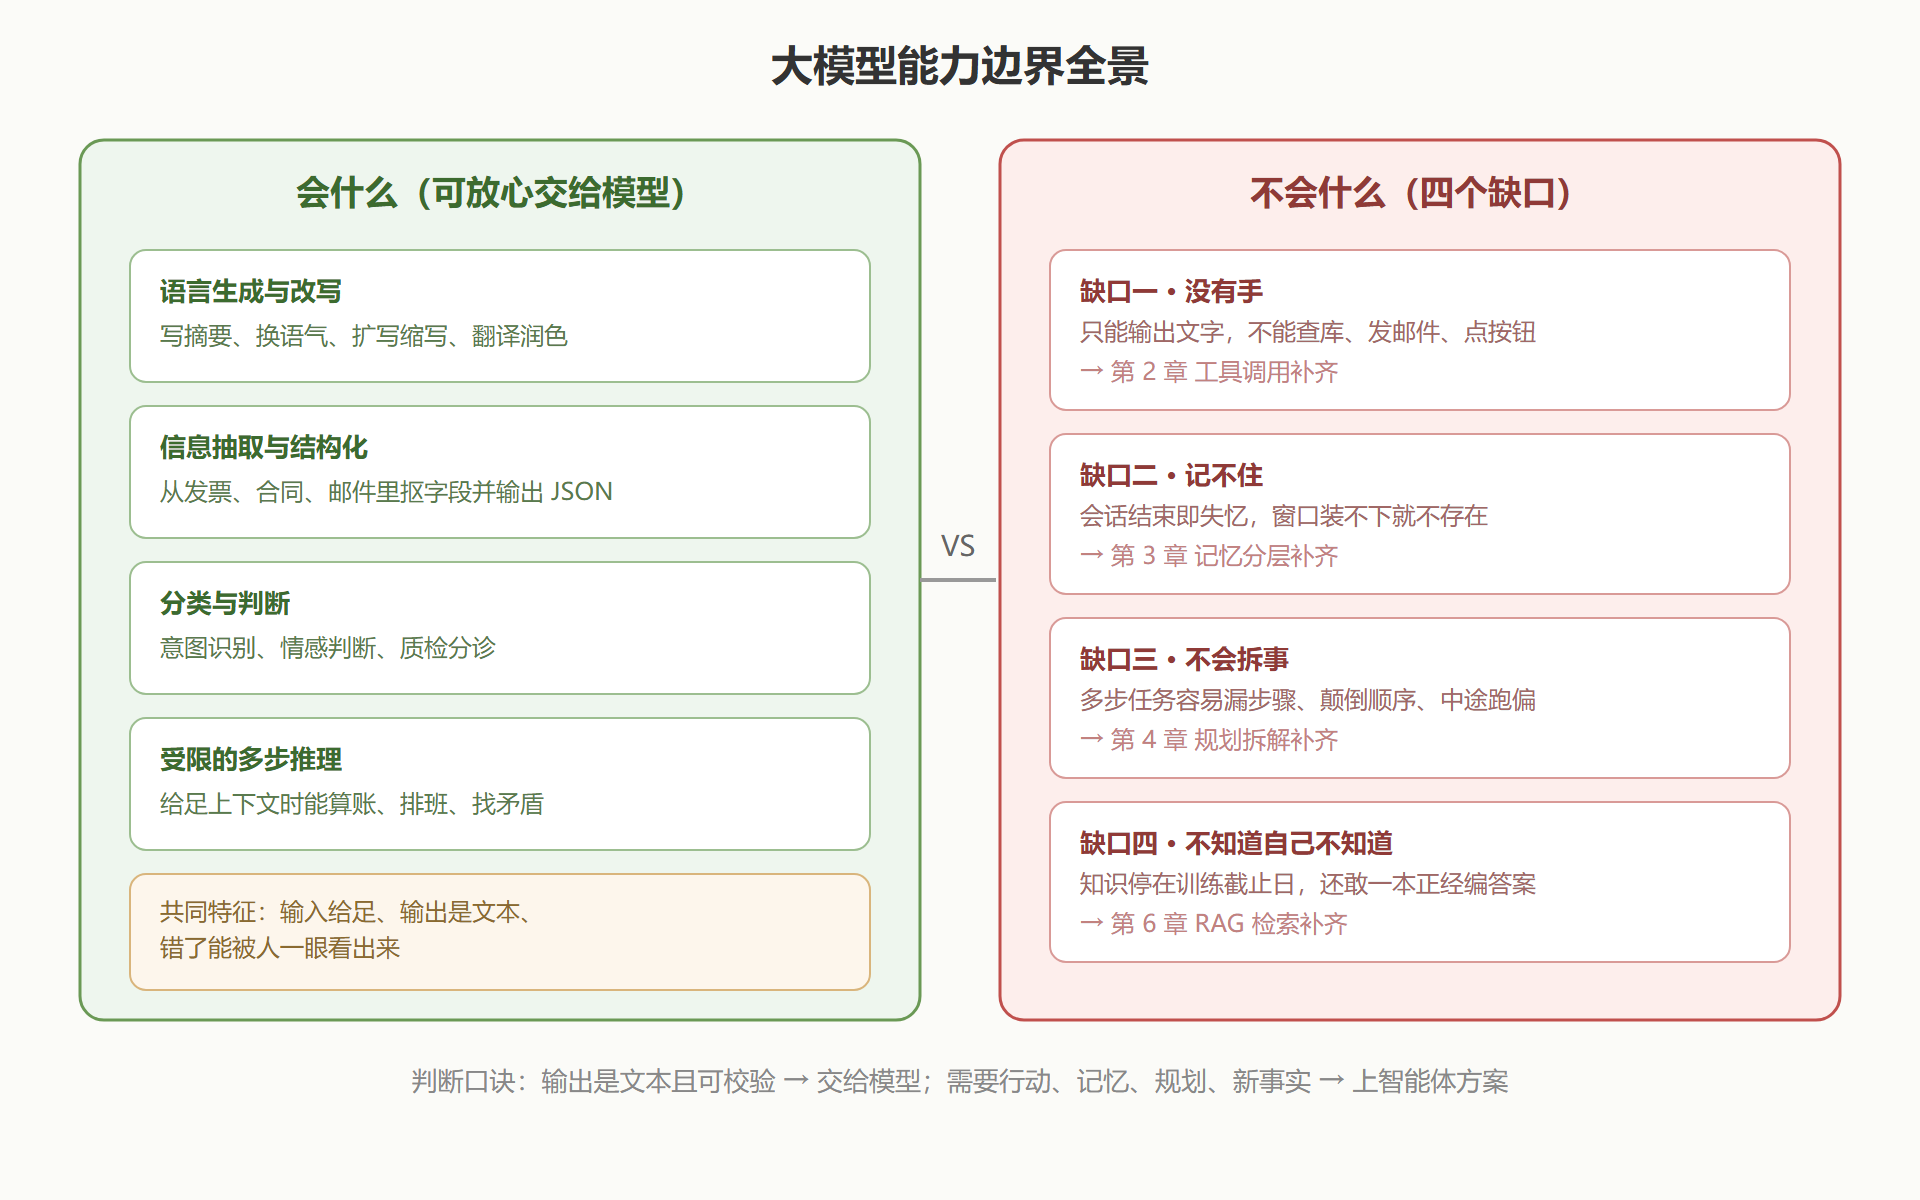
图:能力边界全景——会什么、不会什么、谁来补
读完能解决什么
- 接到"让 AI 做 X"的需求时,能判断它属于"一次生成"还是"多步执行",并估算两者的方案成本差。
- 能对着一个翻车案例指出:模型是在哪个能力上越界了——是编了事实,还是没有工具可用。
- 能向没有技术背景的相关方解释清楚:为什么聊天机器人和智能体是两种工程,预算和周期为什么不能套用。
- 拿着"四个缺口"的清单,为后续章节建立阅读地图:每个缺口对应哪一章的哪套解法。
各节怎么分工
| 节 | 回答的问题 | 关键产出 |
|---|---|---|
| 1.1 智能体是什么 | 聊天与干活的结构差异在哪 | 感知-决策-行动闭环的定义与最小对比代码 |
| 1.2 大模型会什么 | 能力盘点与真实边界 | 能力-靠谱度-用法建议对照表 |
| 1.3 大模型不会什么 | 干活卡在哪几件事上 | 四个缺口的定位与补法索引 |
| 1.4 从 RPA 到智能体 | 为什么自动化方案要换代 | RPA 与智能体的适用判断清单 |
先决条件
- 用过任意一个大模型对话产品,知道"发提示词、收回复"的基本交互。
- 听说过 API 这个词即可,不需要调用经验——本章不写生产代码,只有一段用于对比的示意代码。
- 不需要机器学习背景;本章不涉及任何训练与微调内容。
往下走到哪
本章结尾会把四个缺口摆在桌上。第 2 章从最要命的"没有手"开刀:给模型接上工具,让它第一次拥有"行动"的能力——那是整个智能体大厦的地基。
两个高频疑问
问:模型版本更新很快,现在盘点能力边界会不会很快过时?
答:边界的"位置"会移动,边界的"形状"很稳定。语言能力最强、推理次之、事实时效与自主行动靠工程补齐——这个梯度自 GPT 系列公开评测以来没有变过,变的只是各档位的绝对分数。用形状做架构决策(哪些交给模型、哪些交给工程),比盯某次跑分稳得多。
问:这一章不写代码,会不会太"虚"?
答:恰恰相反。智能体项目返工的头号原因,是需求定性错误——把对话需求做成了智能体,或反之。本章的四类能力对照、四个缺口定位、RPA 与智能体的选型清单,都是立项评审会上直接可用的判断工具。工具与代码从第 2 章开始,而且一旦开始,你希望每行代码都花在定性正确的事情上。
问:四个缺口会不会随着模型迭代变成两个、一个?
答:会减少,但最后两个(记忆与时效)几乎不会消失,因为它们本质是物理与治理问题:训练永远有截止日,你的私有数据永远不在通用模型里。把工程投入押在这两个"不消失"的缺口上(检索与记忆管理),是面向未来的架构决策;把希望寄托在行动与规划被下一代模型原生解决上,则要做好方案随时重写的心理准备。本册的组件化设计正是为了这种此消彼长——某个缺口被模型原生补上时,替换掉对应模块即可,架构不动。