6.4 部署与运维:从 demo 到生产
6.4 部署与运维:从 demo 到生产
本节摘要:demo 与生产之间隔着五件套:多方网络编排、预计算库存管理、故障恢复、审计合规、密钥治理。本节逐件给出可执行的落地方案,并汇总一张上线自查清单。
定位:本节解决什么
框架示例几乎都是"同一台机器上起三个进程",而生产是"三家机构、三个机房、三套安全策略"。差距不在协议代码,而在协议代码周围的系统:谁启动、谁等待、一方挂了怎么办、材料怎么备货、出了纠纷怎么自证清白。本节按上线前的真实评审顺序逐项过,读完你应当能写出自己项目的上线方案初稿。
五件工程套件
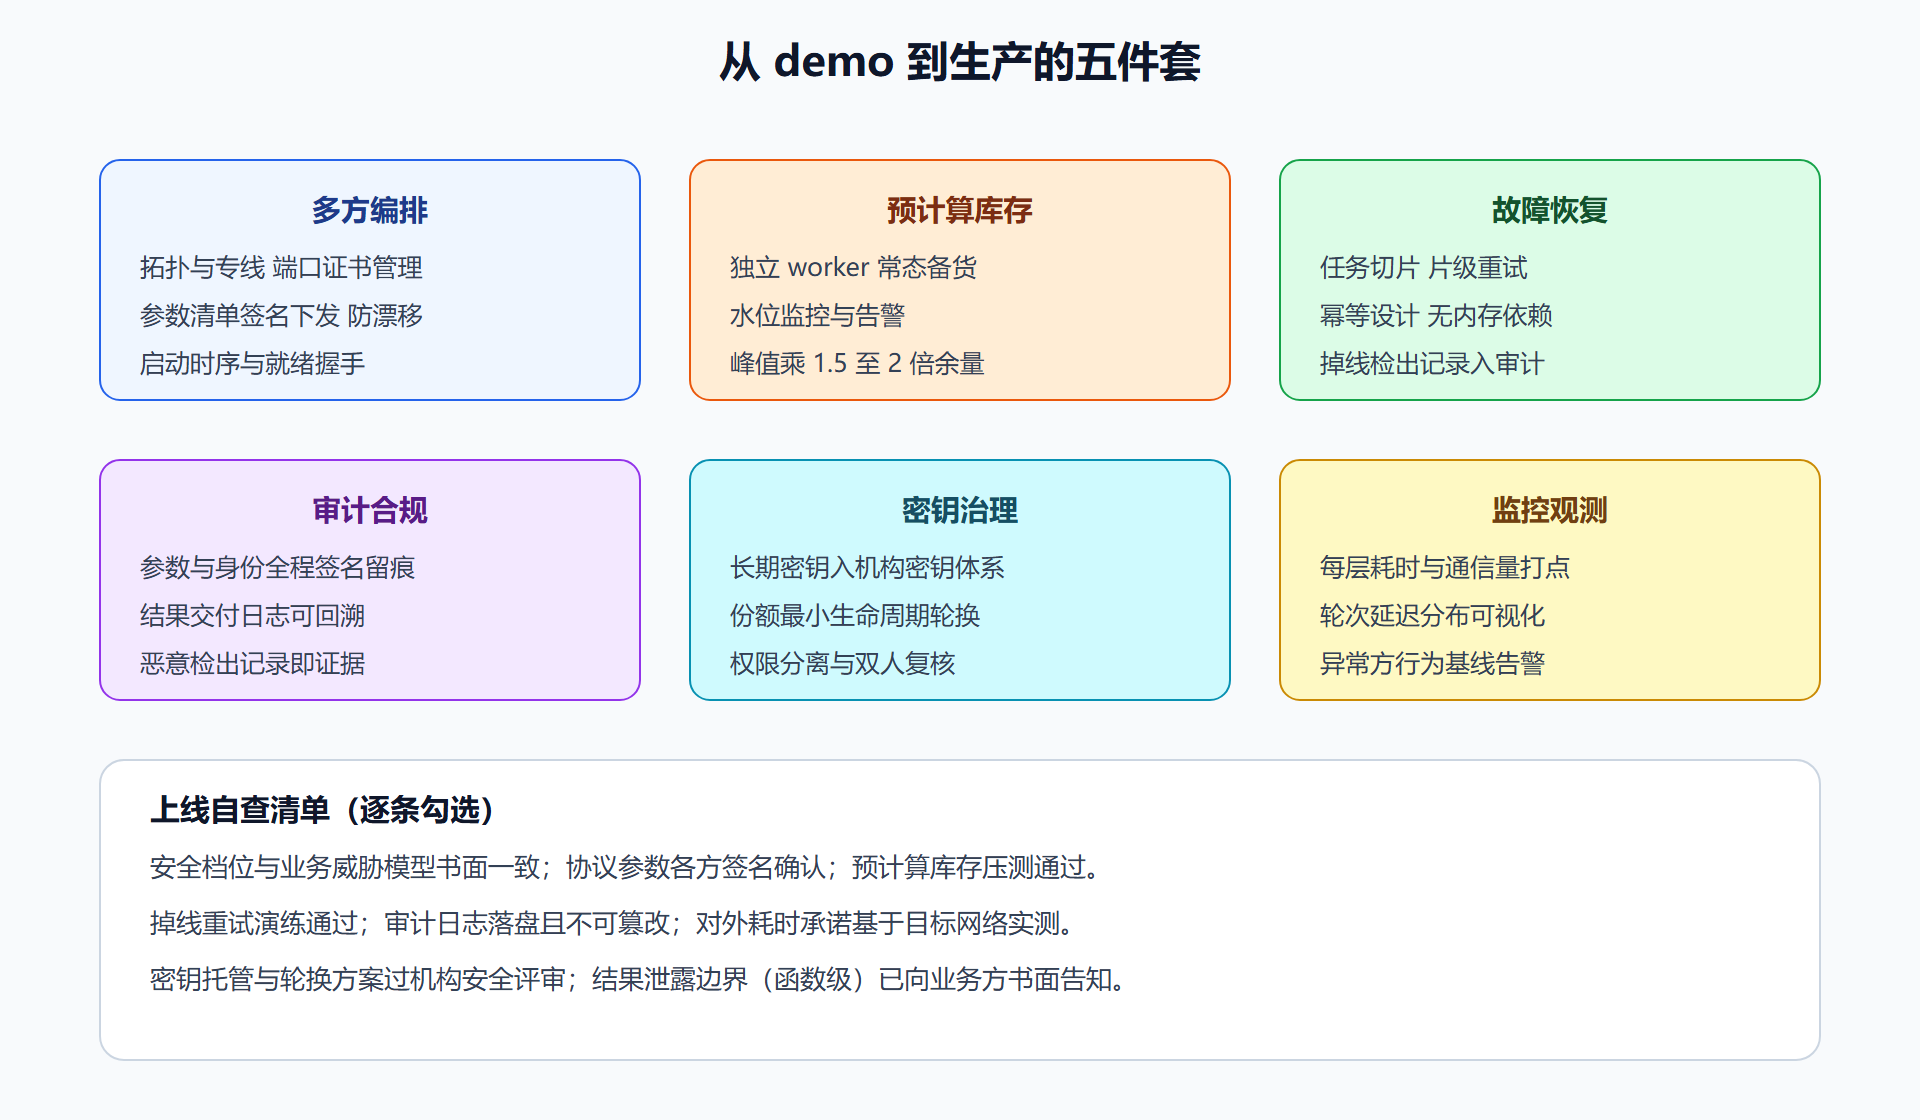
第一件:多方编排。 demo 的"本地三进程"要换成真实拓扑:各方内网部署计算节点、经专线或加密隧道互联,端口与证书轮换纳入机构安全规范。编排层要处理"启动时序"——MPC 各方必须就协议参数(环宽、安全档位、电路指纹)达成一致后才能开工,建议由协调服务下发带签名的参数清单,各方校验后执行,避免"参数漂移"这类最阴险的配置事故。第二件:预计算库存。 5.1 节说过三元组是消耗品。生产做法是独立的预处理 worker 常态化生产、按任务队列预填库存、监控水位并在低于阈值时告警;库存估算用"任务峰值乘法数乘 1.5 到 2 倍余量"。第三件:故障恢复。 半诚实协议里一方中途掉线,通常整轮作废;恶意协议里掉线可被检出但计算同样中断。工程上没有"断点续跑"的通用魔法,务实方案是任务级重试加幂等设计——把大任务切片、每片独立可重跑,片间状态不依赖内存。第四件:审计与合规。 MPC 的卖点"数据不出域"要在合规上成立,需要配套证据:协议参数记录、参与方身份签名、结果交付日志。恶意安全模型的"作弊可检出"特性在这里格外值钱——检出记录本身就是审计证据。第五件:密钥与份额治理。 参与方的长期密钥(用于认证与 OT 基础材料)要进机构的密钥管理体系;协议中的长期秘密(如各方持久份额)按最小生命周期原则轮换。
图:上线前的五件套与自查清单
动手演练:库存监控的最小脚本
import time class PrecomputeStore: """三元组库存的极简监控:低于水位即告警(概念实现)。""" def __init__(self, low_watermark): self.stock = 0 self.low = low_watermark def produce(self, n): self.stock += n def consume(self, n): assert self.stock >= n, "库存不足 在线引擎将停摆" self.stock -= n if self.stock < self.low: print(f"告警 库存 {self.stock} 低于水位 {self.low} 请加开预处理") return self.stock store = PrecomputeStore(low_watermark=100_000) store.produce(1_000_000) # 预热一批 store.consume(920_000) # 大任务消耗 # 输出:告警 库存 80000 低于水位 100000 请加开预处理
会话行为:大任务消耗后库存跌破水位触发告警。真实系统里"加开预处理"由调度器自动完成并带背压,概念一致。
💡 关键直觉:MPC 运维的心智模型不是"部署一个服务",而是"运营一条流水线"——材料(三元组)有库存、工序(轮次)有节拍、工位(参与方)有考勤。用流水线的语言定监控指标,团队沟通成本最低。
本节要点:生产化的差距在协议代码之外;五件套对应五类负责人;上线自查清单里"泄露边界书面告知"最容易被遗忘也最该写。下一章看这些工程能力最终落到了哪些业务形态上。
事故复盘两则
两个化名案例,比清单更有体感。案例一:库存静默耗尽。 某平台上线三个月后在线任务突然成批超时,排查半天发现预处理 worker 的上游数据管道两天前故障停摆,三元组库存缓慢耗尽——在线引擎本身毫无异常,监控面板全绿。教训:库存水位必须接入告警且与数据管道联动监控,"全绿"不等于"健康"。案例二:参数漂移。 两家机构各自升级框架版本,环宽默认值在新版本中变了,双方协议参数不一致导致结果随机错误——错误结果而非报错,若非数值抽查几乎上线即事故。教训:协议参数清单必须带版本与签名校验,不匹配即拒绝开工,这条检查值不了几十行代码。
两个案例的共同点:事故都不发生在密码学里,发生在密码学的四周边缘。MPC 系统的运维心智要把"协议正确"当默认假设,把注意力放在供给、配置、时序这些平凡环节——平凡环节才是生产事故的主产区。
多方运维的协作契约
多方系统的运维与传统运维有一处本质差异:任何一方变更,全体承担后果——框架升级、参数调整、网络割接,单方动作都可能让整个协作计算停摆或出错。因此需要一个跨机构的"协作变更契约",四条核心条款:变更窗口协商制(涉及协议的变更提前约定联调窗口);版本对齐清单(框架版本、依赖版本、协议参数三方对齐并签名存档);变更回滚承诺(出问题时各方回滚到对齐版本的时限);联系人升级路径(值班到决策人的升级链条与时限)。
这套契约在单机构内部也许显得繁琐,跨机构场景里它是救命绳——6.4 节的参数漂移事故,正是缺失变更契约的典型代价。把契约文本放进合作协议附件,与技术方案同等对待。
最后把"多方运维"与"单方运维"的成本差异给个直觉:多方系统的每一次变更都是一场小型多方协作项目,沟通成本至少三倍于单方。这个倍数解释了为什么成熟的隐私计算平台都把"参数与版本的自动化校验"当作核心功能卖——用工具吃掉协作成本,是多方运维降本唯一可持续的路。
上线后的第一个月清单
上线不是终点,第一个月是多方系统的敏感期,五件事按周排。第一周:盯库存与参数——三元组水位、各方法线版本对齐情况,每天核对。第二周:建立基线——把正常的吞吐、延迟、失败率记录成基线,此后一切告警阈值以基线为准而非拍脑袋。第三周:做一次主动演练——人为停掉一个参与方,验证重试与告警链路,演练结果写入运维手册。第四周:首次复盘会——把一个月内的异常单全部过一遍,区分"已解释"与"未解释",未解释异常是潜在事故的种子。第五周起:转入常态运维节奏,月度对账、季度演练。
这五周清单的本质是把 6.4 节的五件套从"部署时的一次性动作"变成"运行时的持续机制"。多方系统的信任是靠一次次平稳运行攒出来的——运维的稳定性,就是这套技术最好的市场口碑。