7.1 MPC 与联邦学习:两条路线正面比较
7.1 MPC 与联邦学习:两条路线正面比较
本节摘要:联邦学习让数据不动、梯度动,MPC 让原始输入根本不进入任何单方视野。两者不是竞品:联邦学习的梯度聚合正是泄露点,MPC 是给这个环节加密的趁手工具。本节用信息流对照讲清泄露面差异,给出三种混合架构与选型判据。
核心概念
先各自陈述主张。联邦学习(FL):各方在本地训练,只把模型参数或梯度上传到聚合服务器,服务器加权平均后下发。数据确实不出本地,但"梯度不出"是另一回事——梯度是一份高维数值,研究界反复实证它可能被反推出训练样本(成员推断、梯度反演攻击都有公开结果)。MPC:多方以秘密分享持有输入,任何单方(包括聚合服务器)只见份额,计算全程无明文。保护强度高一档,代价是通信与计算开销高、工程复杂度高。
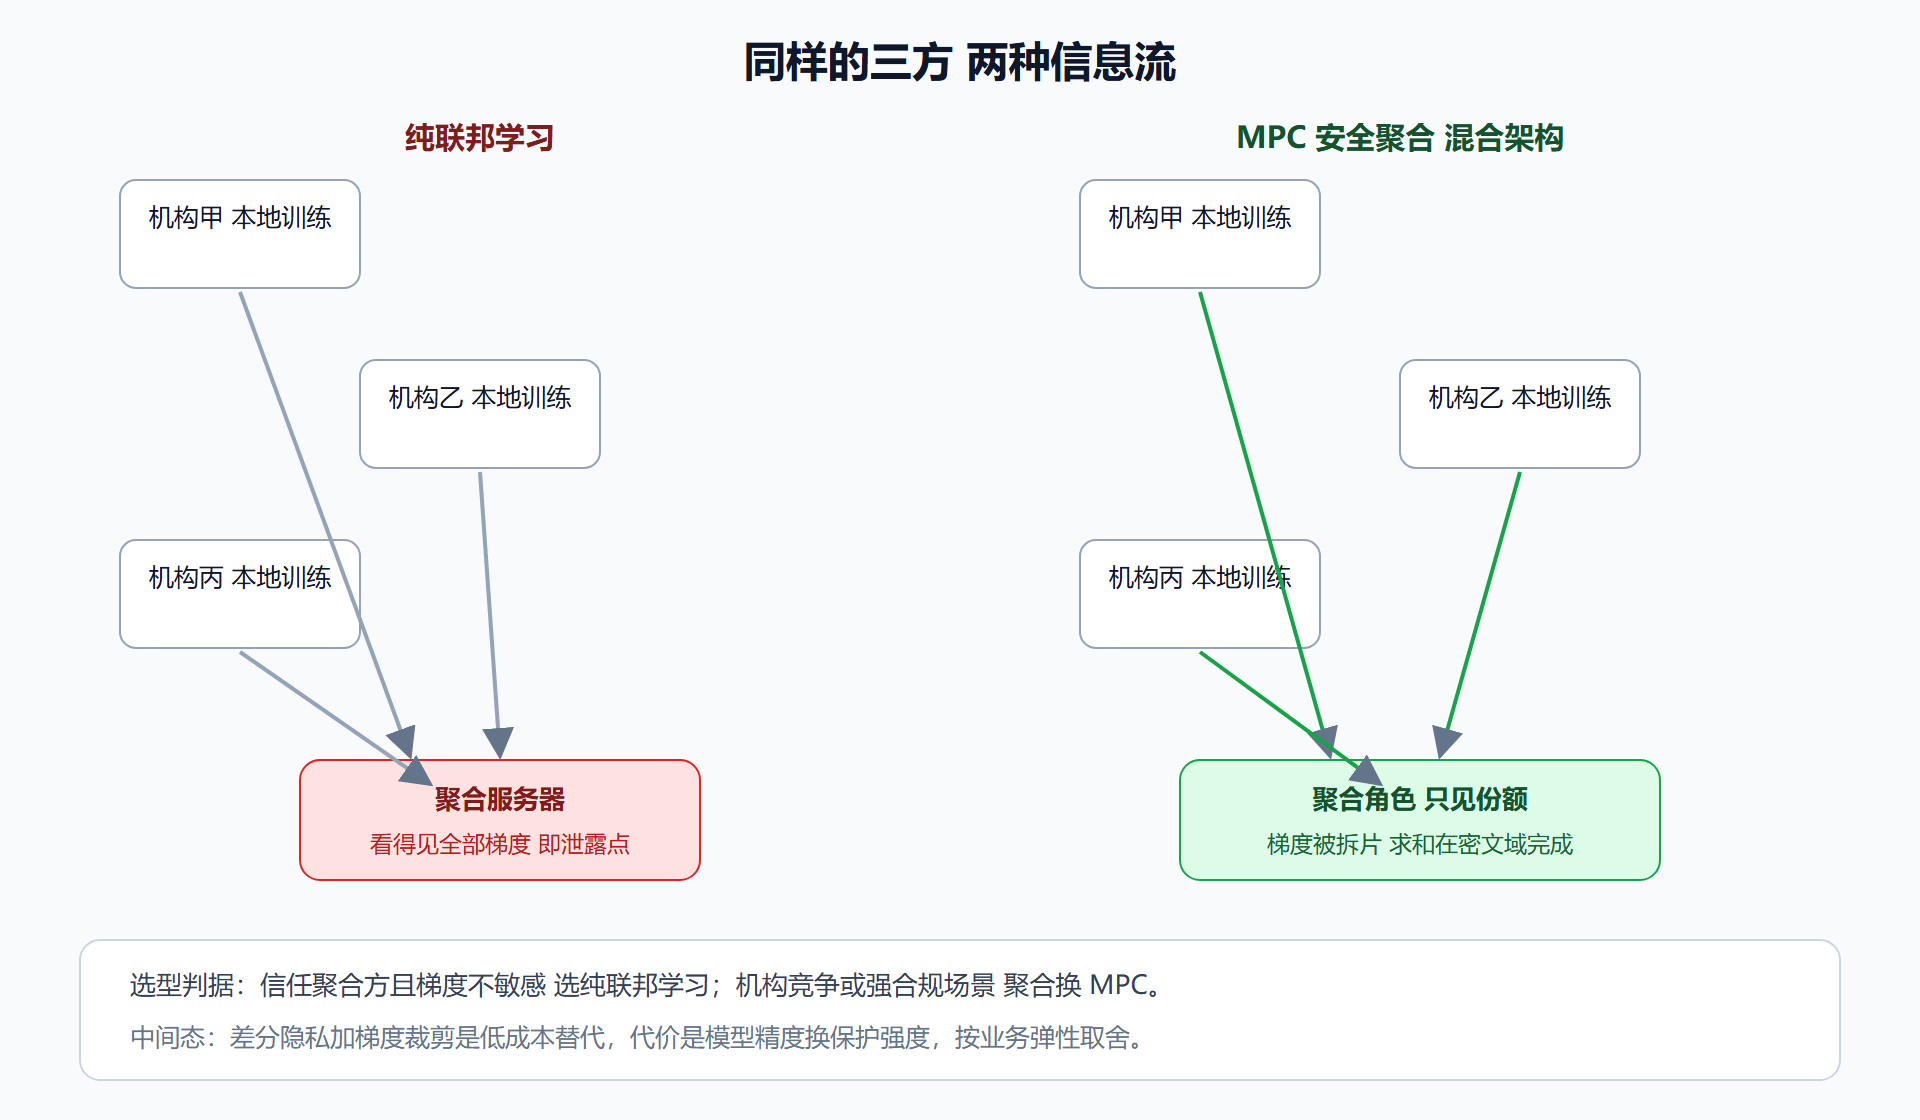
把两者的信息流并排画出来,差异一目了然:联邦学习的聚合服务器是"看得见所有梯度的中心",MPC 的聚合角色是"只见份额的盲算师"。于是问题从"MPC 还是联邦学习"变成"梯度这个环节,你敢让中心看吗"——敢(信任聚合方、且业务对梯度泄露不敏感),纯联邦学习最省;不敢(机构间竞争、强合规),就该把聚合环节换成 MPC 的安全聚合——这就是混合架构。
图:两条路线的信息流对照
三种混合架构
按 MPC 介入深度递增排列。架构一:联邦学习加差分隐私——聚合前给梯度加噪,不改系统结构,成本最低,保护从"密码学级"降为"统计级",适合参与方互信基础尚可的场景。架构二:安全聚合——各方把梯度拆成秘密分享再上传,聚合服务器只见份额、只能算出总和,单方梯度不可见;这是目前工业界最主流的混合形态,通信开销约为明文联邦学习的两到三倍。架构三:全 MPC 训练——连本地训练的矩阵运算都跑在秘密分享上(CrypTen 路线),保护最强、开销最大,广域网上尚属激进选择,多见于两方小模型的联合建模。
动手演练:安全聚合的最小演示
import os K = 1 << 32 def rand_mask(): return int.from_bytes(os.urandom(4), 'big') # 三方两两约定掩码 m_ij 等于 m_ji(经 OT 或密钥协商交换) m12 = m21 = rand_mask() m13 = m31 = rand_mask() m23 = m32 = rand_mask() g1, g2, g3 = 120, -80, 200 # 各方本地梯度(标量示意) u1 = (g1 + m12 + m13) % K # 各方上传的只是掩码后数值 u2 = (g2 + m21 + m23) % K u3 = (g3 + m31 + m32) % K total = (u1 + u2 + u3) % K # 聚合方求和:掩码两两相消 expected = (g1 + g2 + g3) % K print(total == expected) # True 总和精确 print(u1, u2, u3) # 单看任一上传值 梯度不可见
会话输出 True 加三行互不相关的随机数:掩码在总和里两两抵消,聚合方拿到精确总和,却对每家梯度一无所知。这就是"安全聚合"四个字的全部机制——生产系统再叠加 OT 换掩码、掉线方掩码可由剩余方协作恢复等工程加成,概念不变。
工程实践要点
三个常见误判。"联邦学习天生隐私安全"——梯度泄露是被反复实证的,合规评审里把联邦学习当免检通行证会翻车。"MPC 联邦学习二选一"——在真实招标场景里两者常打包出现,评审要点是"聚合环节用了什么保护"。"开销吓退一切"——安全聚合的增量开销只有两三倍,而它换来的"梯度不可见"常常正是过审与不过审的区别。
💡 关键直觉:联邦学习保护的是"数据不动",MPC 保护的是"信息不漏"。数据不动不代表信息不漏——梯度就是漏点。两句话记住两者的分工。
本节要点:泄露面差异在聚合环节;三种混合架构按介入深度递进;安全聚合是最主流落点。下一节看 MPC 家族里最先赚到钱的成员——隐私求交。
联合建模的完整决策树
把 7.1 的比较收束成一棵可执行的决策树。第一层问题:数据能出本地吗? 能(同一法人内部),根本不需要这些技术,直接集中训练。不能,进第二层:要交换的是参数还是结论? 交换结论(评分、标签、交集),走 MPC 直连路线——求交、联合统计、联合评分,第 7 章各节的应用骨架即此;交换参数(模型梯度),进入联邦学习骨架,进第三层。第三层:聚合环节的梯度可见性能否接受? 能,纯联邦学习加基本安全措施;不能,上安全聚合或全 MPC 训练,按预算与延迟约束二选一。
决策树的价值在于把"要不要用 MPC"从立场之争变成逐层可答的事实题。实践中多数争论卡在第三层——"梯度反推是学术风险还是现实威胁"没有一刀切答案,建议的写法是按数据敏感度分级:公开行为数据可接受纯联邦学习,客户级敏感数据默认安全聚合,涉监管红线的字段不进任何交换环节。给每一级数据定交换策略,比给整个项目定路线更可执行。
混合架构的成本核对单
混合架构的报价单常有两处模糊地带,核对时要逐项戳破。模糊一:聚合环节的加密开销算在哪边。 安全聚合让聚合方多算密文域运算,有的方案把这个成本转嫁给参与方终端——手机端做秘密分享的能耗与流量成本可观,终端侧成本必须单独列示。模糊二:掉线补偿的开销。 掉线方份额的协作恢复要剩余方多跑通信,参与方越多掉线概率越高,这笔"冗余通信税"与参与方规模正相关,长期运行的成本模型里必须有它的位置。
两处模糊的共同点是都发生在"架构的接缝处"——单看任何一方的方案文档都合理,合起来账就对不上。混合架构的评审纪律因此只有一条:把接缝处的成本与责任写成三方签认的对照表,谁付算力、谁付带宽、谁担掉线风险,逐格填数。填完这张表,多数看似双赢的混合方案会显出真实的成本结构,决策质量随之水涨船高。
两个提法的是非判断
收尾澄清两个高频提法的是非。提法一:"联邦学习天然保护隐私"——错,梯度泄露有实证,正确说法是"联邦学习减少原始数据暴露面,隐私强度取决于聚合环节的补强"。提法二:"MPC 过于昂贵不适合生产"——过时,生产级 SPDZ 部署在金融与政务领域已经规模化,正确说法是"MPC 的适用边界由任务形状与网络条件决定"。两个错误提法分别高估与低估了这两门技术,而它们的流行恰恰说明:这个领域的公共讨论里,精确表述仍然稀缺。把 7.1 节的对照图与这一节的两个判断一起带走,你在任何一场关于"MPC 还是联邦学习"的讨论里都不会失分。