1.1 数据类型与结构:食材验收
1.1 数据类型与结构:食材验收
本节摘要:验收是备料间的头道工序——拿到数据先逐列认清类型,再谈处理。本节给出 type、dtype、info 三种验收问法,梳理整数、浮点、字符串、布尔、时间、类别六类常见"食材"的脾气,并解释 NaN 为什么总把整型列变成浮点。承接导读的教室地图,这里是第 1 站;通往 1.2 的容器选型。
收货单上的第一件事
后厨收货有个规矩:箱子进门先验,不看箱子上的字,看里面的货。数据进程序也一样——CSV 第一行写着 amount,里面装的可能是数字、可能是"1,280.00"这种带逗号的文本、甚至可能混着"待定"两个字。类型不对,后面每一步都在替这箱错货买单。本节就是那双验收用的手套:读完你能给任何一份陌生数据开出一张验收单,并且知道哪里要打问号。往前的承接是导读里的教室地图,往后的去处是 1.2——验完货,得决定用什么盛器装。
六类基础食材
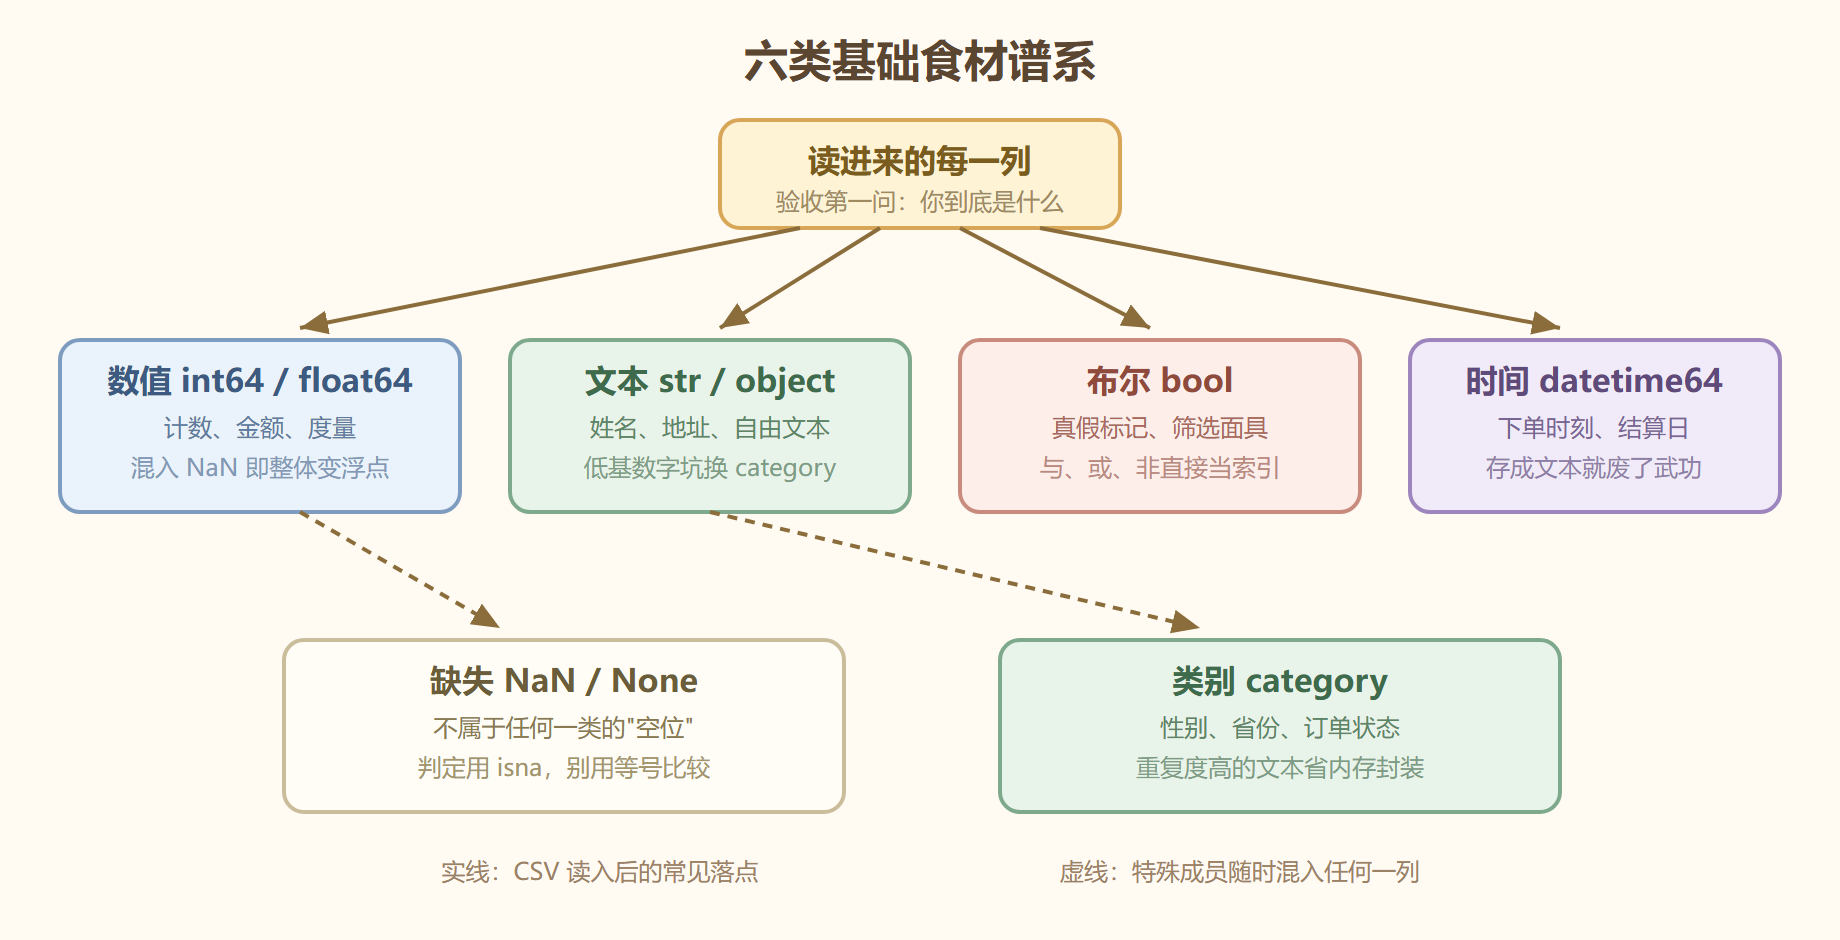
日常处理表格数据,绝大多数列能归进六类。**整数(int)**管计数与编号:订单数、用户 ID。**浮点数(float)**管度量:金额、权重、评分,它还有一个特殊成员 NaN——"这不是数,是空的"这一身份,决定了含缺失的列哪怕全是整数也会被 pandas 升级成 float64,这是全册出场率最高的隐性变换。**字符串(str)**管名字、地址、自由文本;在 pandas 里未优化的字符串列显示为 object。**布尔(bool)**只管真与假,是筛选用得最多的临时食材。**时间(datetime64)**单独一类,能做加减、能抽年月日,一旦存成字符串就什么都做不了;2.4 与 3.4 会专门伺候它。**类别(category)**是 pandas 给低基数文本的省内存封装——性别、省份、状态这类取值重复度极高的列,换成 category 往往能省下大半内存,第 8 章算内存账时会再见到它。
图 六类食材谱系与常见来源
参数拆解:看类型的三种问法
验收有三问,各答各的事。第一问 type(x):问 Python 解释器"这个对象本身是什么",管到单个值;第二问 df.dtypes:问 DataFrame"每一列装的是什么 dtype",管到整列,这是日常用得最多的一问;第三问 df.info():一次性报出每列类型、非空行数与内存占用,验收时先跑它,等于把收货单整个扫一遍。
import pandas as pd import numpy as np df = pd.DataFrame({ "order_id": [1001, 1002, 1003], # 整数:编号 "amount": ["128.00", "96.50", "待定"], # 混入文本的金额 "paid": [True, False, True], # 布尔:是否支付 "created": ["2024-05-01", "2024-05-02", "2024-05-03"], # 时间,但存成了文本 }) print(df.dtypes) # order_id int64 # amount object <- 肉眼看是金额,实际是字符串,验收打回 # paid bool # created object <- 时间存成文本,武功全废 print(type(df["order_id"].iloc[0])) # <class 'numpy.int64'> print(df["amount"].iloc[0] + 1) # TypeError:字符串不能加数字
实操示例:给一份陌生数据开验收单
验收的价值在"对照":肉眼预期和 dtype 实际落点不一致的列,就是要打回重洗的列。下面这段脚本是可直接照抄的验收流程,输出即一张简易验收单。
def accept_report(df: pd.DataFrame) -> pd.DataFrame: """对任意 DataFrame 逐列开验收单:预期之外的类型一眼可见。""" report = pd.DataFrame({ "dtype": df.dtypes.astype(str), "非空数": df.notna().sum(), "缺失率": (df.isna().mean()).round(3), "唯一值数": df.nunique(), }) # 唯一值占比极低的文本列,标注"可换 category 省内存" report["建议"] = "" mask = (report["dtype"] == "object") & (report["唯一值数"] < len(df) * 0.05) report.loc[mask, "建议"] = "低基数文本,可转 category" return report print(accept_report(df)) # dtype 非空数 缺失率 唯一值数 建议 # order_id int64 3 0.0 3 # amount object 3 0.0 3 # paid bool 3 0.0 2 # created object 3 0.0 3
验收单里 amount 的建议栏空着——因为它的唯一值占比不低,但 dtype 是 object 这件事本身就是打回理由。规则是死的,验收动作是活的:先看 dtype,再看缺失率,最后才看唯一值。
坑点与翻车
**翻车一:整型列悄悄变浮点。**有人发现订单号显示成 1001.0,查了半天"谁加了小数点"。真相是列里混入了一个空值,pandas 为容纳 NaN 把整列升级成 float64——NaN 属于浮点世界,这是它的代价。处置办法看场景:要么先填缺失再转回整型,要么用可空整型 astype("Int64")(大写 I,2.4 详述)。
s = pd.Series([1001, 1002, np.nan]) print(s.dtype) # float64 <- 一个 NaN 拖累整列 print(s.astype("Int64").tolist()) # [1001, 1002, <NA>] 可空整型保住整数身份
**翻车二:拿等号判缺失。**np.nan == np.nan 的结果是 False——NaN 连自己都不等于自己。所以 s == np.nan 造不出筛选面具,正确的问法是 s.isna()。这类错误的隐蔽之处在于它不报错,只是静默地一个都筛不出来。
替代方案
除了 type 和 dtypes,还有一组"类型谓词"专门做判定:pd.api.types.is_numeric_dtype、is_datetime64_any_dtype、is_bool_dtype,写通用清洗函数时比手写字符串比较稳。列类型实在不理想时,出路在 2.4(类型转换):to_numeric 强制数值、to_datetime 强制时间、astype("category") 压缩低基数文本。验收发现问题,矫正交由择菜间处置——食材先验明正身,再决定是洗是退。
收档清单
- 验收三问:type 管单值,dtypes 管整列,info 管全局;
- NaN 拖累:一个空值能把整型列变成 float64,可空整型 Int64 是解药;
- 判缺失:永远用 isna,别用等号——NaN 不等于任何值,包括它自己;
- 六类食材:数值、文本、布尔、时间、类别、缺失,各有脾气各有去处;
- 低基数文本:唯一值占比很低的字符串列,转 category 立省内存。
下一节仍在备料间:验完的食材装进什么盛器——列表、字典、集合、数组怎么选,1.2 给你一张选型对照。