- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:把数据处理当成一间料理教室
从"跑报表"的年代到今天的数据岗位,这项工作换过许多名字,本质却始终是同一门手艺:把采买回来的生食材,按规矩做成能端上桌的菜。原料不会自己变干净,刀工不会从天上掉下来,汤的火候、摆盘的次序、后厨的动线,都有讲究。本册把这套讲究搬进一间"数据料理教室",让你沿着后厨的真实工序,把常用的数据处理函数逐个练成手上的肌肉记忆。
一句话定位:这是一册以函数为中心的数据处理实操手册——每个函数是一道带食谱卡的菜,讲的是"这味料怎么用、火候怎么控、翻车了怎么救",不讲统计理论,也不展开分析方法论;那些内容另有专册负责。
为什么是料理教室
数据处理的老教材喜欢按库的目录结构排章节,读完能背出函数清单,一上手还是不知道先做哪步。料理教室的思路相反:它按"出餐顺序"组织训练。食材进了后厨,先验收(认识数据类型与结构),再择菜(清洗:缺失、异常、重复、类型),然后切配(筛选、排序、字符串与时间的整形),下锅熬汤(分组、聚合、统计与窗口计算),最后摆盘上桌(合并、重塑、汇总报表)。调味架上的工具(函数式三件套、正则、抽样)什么时候需要什么时候取;等单量大了,再走进中央厨房(pandas、NumPy、SciPy、scikit-learn、Dask、PySpark 这些成建制的大厨房),学它们怎么把家常小灶扩成流水线;后厨动线一章则专门解决"出餐太慢、灶台太挤"的问题——效率、内存、并行、排错,最后把全部手艺串成一条完整流水线。
食谱卡:每道菜的固定读法
本册每个函数都按同一张食谱卡展开,翻任何一节都能对号入座:
- 适用场景:什么食材适合这道菜,什么情况别用它(对应"适用场景");
- 参数拆解:把函数的火候旋钮逐个拧给你看,常用取值配小例子(对应"参数拆解");
- 实操示例:可照抄运行的代码,输入、输出、注释齐全(对应"实操示例");
- 坑点与翻车:新手最常翻车的地方,先看别人怎么摔,自己少摔一半(对应"坑点与翻车");
- 替代方案:没有这味料,或者这味料不对口时的 substitutions(对应"替代方案")。
图 全册知识地图:料理教室平面图与学习路线
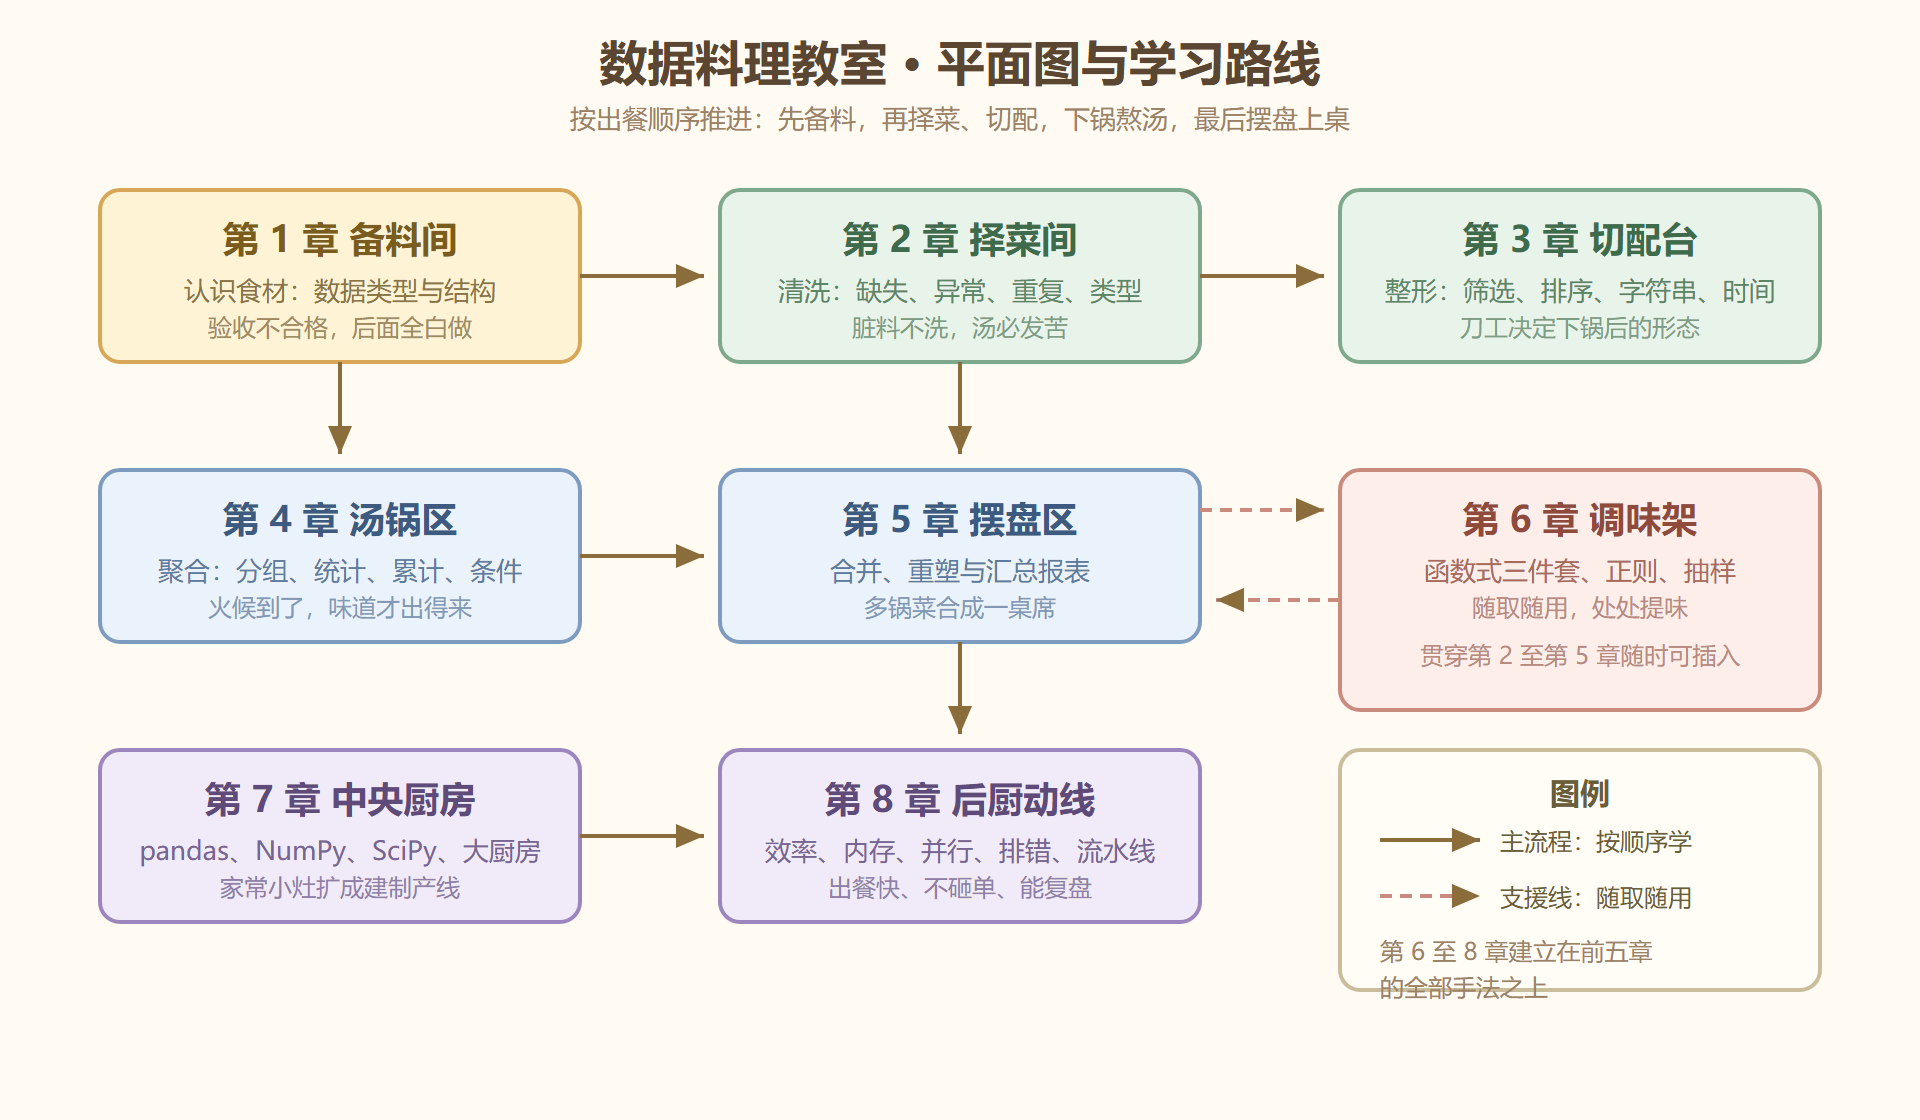
地图上有条主流程,也有条支援线:第 2 章到第 5 章是出餐主线,顺着学即可;第 6 章调味架不占工序,函数式工具、正则、抽样在任何一步都可能用上,学的时候不必拘泥先后;第 7、8 章是规模化的两步,等你把家常小灶的手艺练稳,再去见识中央厨房的建制与后厨动线的提速逻辑,收获最大。
各章一句话导览
- 第 1 章 备料间:把 int、float、字符串、布尔、时间戳、NaN 这些"食材"认全,学会验收(type 与 dtype),再把列表、字典、集合、数组这些"盛器"的脾气摸清,顺手练数组的算术运算。
- 第 2 章 择菜间:dropna、fillna、interpolate 处理缺失;分位数与 Z 分数揪异常;drop_duplicates 去重;to_numeric 与 to_datetime 矫正类型;最后用缩放、分箱、独热编码完成"腌制冷藏"。
- 第 3 章 切配台:loc、iloc、query 三种下刀方式;sort_values 与 rank 排序排名;str 访问器做字符串精加工;to_datetime 与 dt 访问器拆解时间。
- 第 4 章 汤锅区:groupby 的拆-算-合三步;describe 一锅出的描述统计;cumsum 与 rolling 的累计滚动;np.where 与 np.select 的条件分流。
- 第 5 章 摆盘区:merge 的四种对位、concat 的拼盘手法;pivot 与 melt 的长宽互换;pivot_table 与 crosstab 出汇总报表。
- 第 6 章 调味架:map、apply 的作用域差别;正则表达式的提取与替换;sample 抽样与批处理、流处理的量级观。
- 第 7 章 中央厨房:pandas 全函数地图一图收拢;NumPy 向量化为什么快;SciPy 与 scikit-learn 预处理调料柜;Dask 与 PySpark 的超大规模方案。
- 第 8 章 后厨动线:向量化替代循环的效率改造;dtype 降级的内存账;多灶开火的并行;报错家族的排错手册;最后用一份脏订单数据把整条流水线走通。
怎么用这间教室
别只看不练。每节的示例代码建议亲手敲一遍再看讲解——pandas 的报错信息只有摔过跤的人才读得懂。每节的"坑点与翻车"优先看,那是别人用真实数据换来的教训;"替代方案"则在你被环境版本卡住时救急。全部章节走完,你应该能独立完成"读入—清洗—整形—聚合—合并—导出"的完整链路,并且说得出每一步为什么这么选。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...