3.1 数据筛选与切片:loc、iloc 与 query
3.1 数据筛选与切片:loc、iloc 与 query
本节摘要:筛选是切配台的第一刀——布尔面具定条件,loc 按标签下刀,iloc 按位置下刀,query 把条件写成一句话。本节讲清四把刀的分工、与或非的组合写法,以及链式索引的陷阱。承接第 2 章洗好的料,通往 3.2 的排序站位。
某场评审会上的五分钟
某场评审会上,业务方临时要看"华东大区、季度金额过千、且还没退款"的客户名单。会前没人准备,现场五分钟全靠筛选功夫救场——条件一层层叠上去,行数一张张收窄,名单当场出。这就是本节要练的手感:拿到任何"只看某部分"的需求,都能用顺手的刀法快速切出来。往前承接择菜间产出的干净表,往后,切好的片要交给 3.2 排出次序。
适用场景:四把刀各管一面
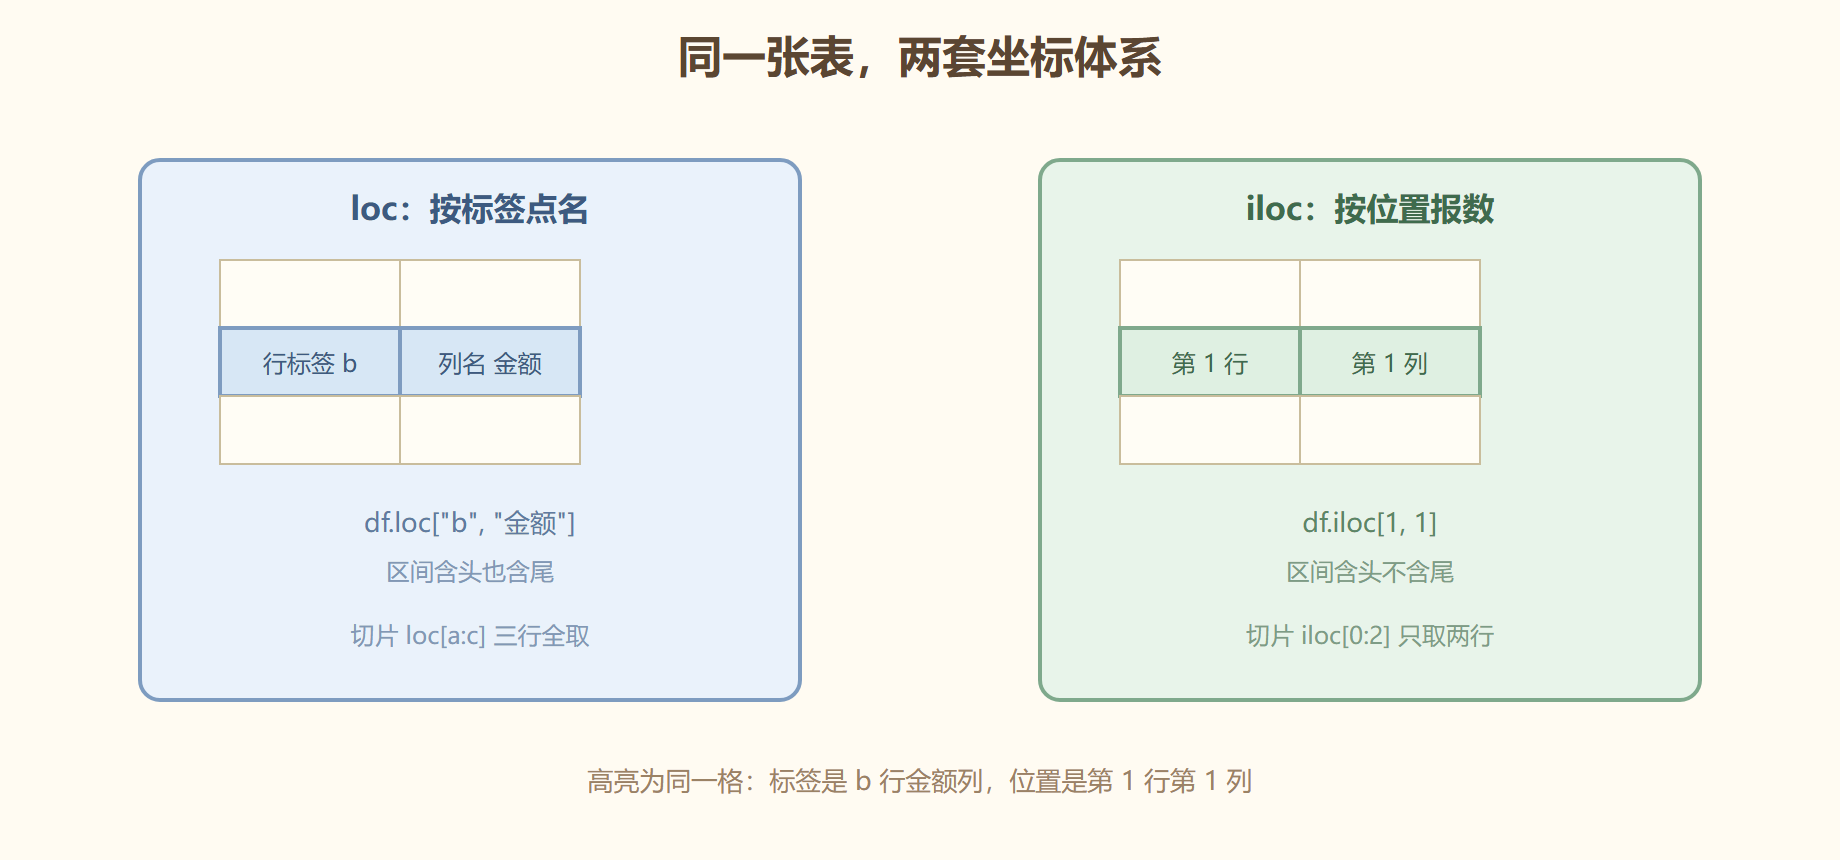
布尔面具是筛选的地基:条件表达式产出一列真与假,pandas 按它留行。loc 按标签取——行标签、列名,写起来最像"点菜";它还能顺手赋值,是改数的正路。iloc 按位置取——第几行第几列,纯看坐次不问姓名,适合"取前几行看看""取最后一行"这类位置需求。query 把条件写成字符串表达式,多层条件时最接近人话,长链条可读性最好。四把刀不是互斥关系:面具常与 loc 搭档使用,query 则是面具的语法糖。
图 loc 与 iloc 的两套坐标
筛选结果的验收动作
切片切完,两眼一抹黑地往下传是大忌。固定的验收动作有两条:一看行数与列数(shape 属性一行出结果,对照预期);二抽查首尾几行(head 与 tail 各看一眼),确认切出来的确实是想要的那块。这两眼合计不超过十秒,却能把"条件写反""列拿错"这类低级事故拦在第一时间——切配台的活快不快,很大程度取决于返工多不多。
参数拆解:旋钮逐个拧
df.loc[行条件, 列选择]:行位置放面具或标签列表,列位置放列名列表;单个标签返回标量,列表返回表。df.iloc[行号, 列号]:整数下标,切片遵循 Python 惯例含头不含尾。df.query("表达式"):字符串里直接写 列名与数值的比较,多个条件用 and、or(query 内部解析,不受普通索引那句与或非限制);列名带空格时用反引号包住。s.isin(候选列表):判断"值在不在名单里",是"多选一"筛选的利器。s.between(下界, 上界):区间筛选的 sugar,inclusive 参数控制两端开闭。
import pandas as pd df = pd.DataFrame({ "大区": ["华东", "华南", "华东", "华北", "华东"], "金额": [1280.0, 640.0, 990.0, 1500.0, 420.0], "状态": ["完成", "完成", "退款", "完成", "完成"], }, index=["r1", "r2", "r3", "r4", "r5"]) mask = (df["大区"] == "华东") & (df["金额"] > 500) & (df["状态"] != "退款") print(df.loc[mask, ["大区", "金额"]]) # 大区 金额 # r1 华东 1280.0 print(df.query("大区 == '华东' and 金额 > 500 and 状态 != '退款'")) print(df[df["大区"].isin(["华东", "华南"])].shape) # (4, 3)
实操示例:从全量到名单的完整下刀
把评审会那道题完整走一遍:多条件面具、按列裁剪、按金额取前三、最后回填一个状态。注意每一步都是"出新表",不动原料。
# 刀一:面具加 loc,条件收紧 target = df.loc[(df["大区"] == "华东") & (df["状态"] == "完成")] # 刀二:isin 多选一,把华南也圈进来 target = df[df["大区"].isin(["华东", "华南"]) & (df["状态"] == "完成")] # 刀三:按金额取前三(详见 3.2) top3 = target.nlargest(3, "金额") # 刀四:iloc 按位置取最后一行做抽查 print(top3.iloc[-1]) # 大区 华东 # 金额 1280.0 # 状态 完成 # Name: r1, dtype: object
筛选的三条配套纪律
下刀之外,切配还有三条配套纪律,少一条就埋雷。**其一,筛选结果当副本用。**面具切出的表在内部实现上可能是视图,直接在它上面赋值会触发链式索引的连带问题——养成 mask 加 loc 一次到位、或对结果显式 copy() 的习惯,改数才稳。**其二,筛选前先看行数。**条件写完先 print(len(df[mask])),行数为零多半是条件写反(相等写成不等、日期口径差一天),行数爆表多半是条件失效没起过滤作用——行数是筛选的免费体检。其三,条件复用要抽函数。"高价值客户"这类口径在报表里反复出现,散落各处迟早不一致——封装成返回面具的小函数,口径改一处全局生效。
def 高价值(df, 门槛=1000.0): """口径只写一处:金额达标且非退款的订单。""" return (df["金额"] >= 门槛) & (df["状态"] != "退款") print(df.loc[高价值(df), ["大区", "金额"]])
坑点与翻车
**翻车一:and 与 or 直接写进面具。**Python 的 and 要求两侧都是明确的真假,Series 会当场抛"真值不明确"异常。面具组合必须用位运算符:与或非分别写作与号、竖线、波浪号,且每个条件都要加括号——位运算优先级高于比较。**翻车二:链式索引赋值不生效。**df[df["大区"]=="华东"]["金额"]=0 这类写法是对中间副本赋值,原表纹丝不动,还会收到 SettingWithCopyWarning。正路是一次性 loc:df.loc[面具, "金额"]=0。**翻车三:loc 与 iloc 的区间口径搞反。**loc 含头含尾,iloc 含头不含尾——同一组数字在两套坐标下切出的行数不同,背错一次就错一次。
替代方案
条件很长时,query 的字符串写法最清爽,但它内部要解析表达式,性能敏感的循环里不如预计算的面具;"取最大最小的几行"不必排序全表,nlargest 与 nsmallest 直达(3.2 详述);"按条件保留形状"则轮到 4.4 的 where 与 mask 出场——它们不删行,只把不满足的位置改成空。
收档清单
- 四把刀:面具定条件,loc 点名,iloc 报数,query 写句子;
- 组合纪律:面具必须用与、或、非符号,条件各自加括号;
- 赋值正路:一次性 loc 定位再赋值,远离链式索引;
- 区间口径:loc 双闭,iloc 半开;
- 名单筛选:isin 管多选一,between 管区间。
切下来的片有了,下一步是让它们按次序站好:3.2 讲 sort_values、nlargest 与 rank,把名次排出章法。