8.1 代码效率优化:从循环到向量化的动线改造
8.1 代码效率优化:从循环到向量化的动线改造
本节摘要:出餐慢的第一瓶颈几乎都在"逐行循环"上。本节给出效率改造的标准动作:先计时定位、再按"iterrows、itertuples、向量化"三档逐级提速,最后附上可复核的实测数据与"何时不必优化"的边界。承接后厨动线开篇,通往 8.2 的内存账。
后厨为什么总在等同一口锅
后厨动线的第一定律:出餐速度取决于最慢的那一站,而不是最快的。脚本同理——绝大多数运行时间耗在同一处:那个对几十万行逐行执行的 for 循环。改一处,全局提速;改错处,白忙半天。所以本节的动作次序严格固定:先计时定位瓶颈,再动手改造,改造前后各计时一次,提速要有数可查。往前接 6.1 的性能铁律与 7.2 的向量化原理——本节是这两节的"施工篇";往后 8.2 的内存账,与速度共同构成动线的两本账。
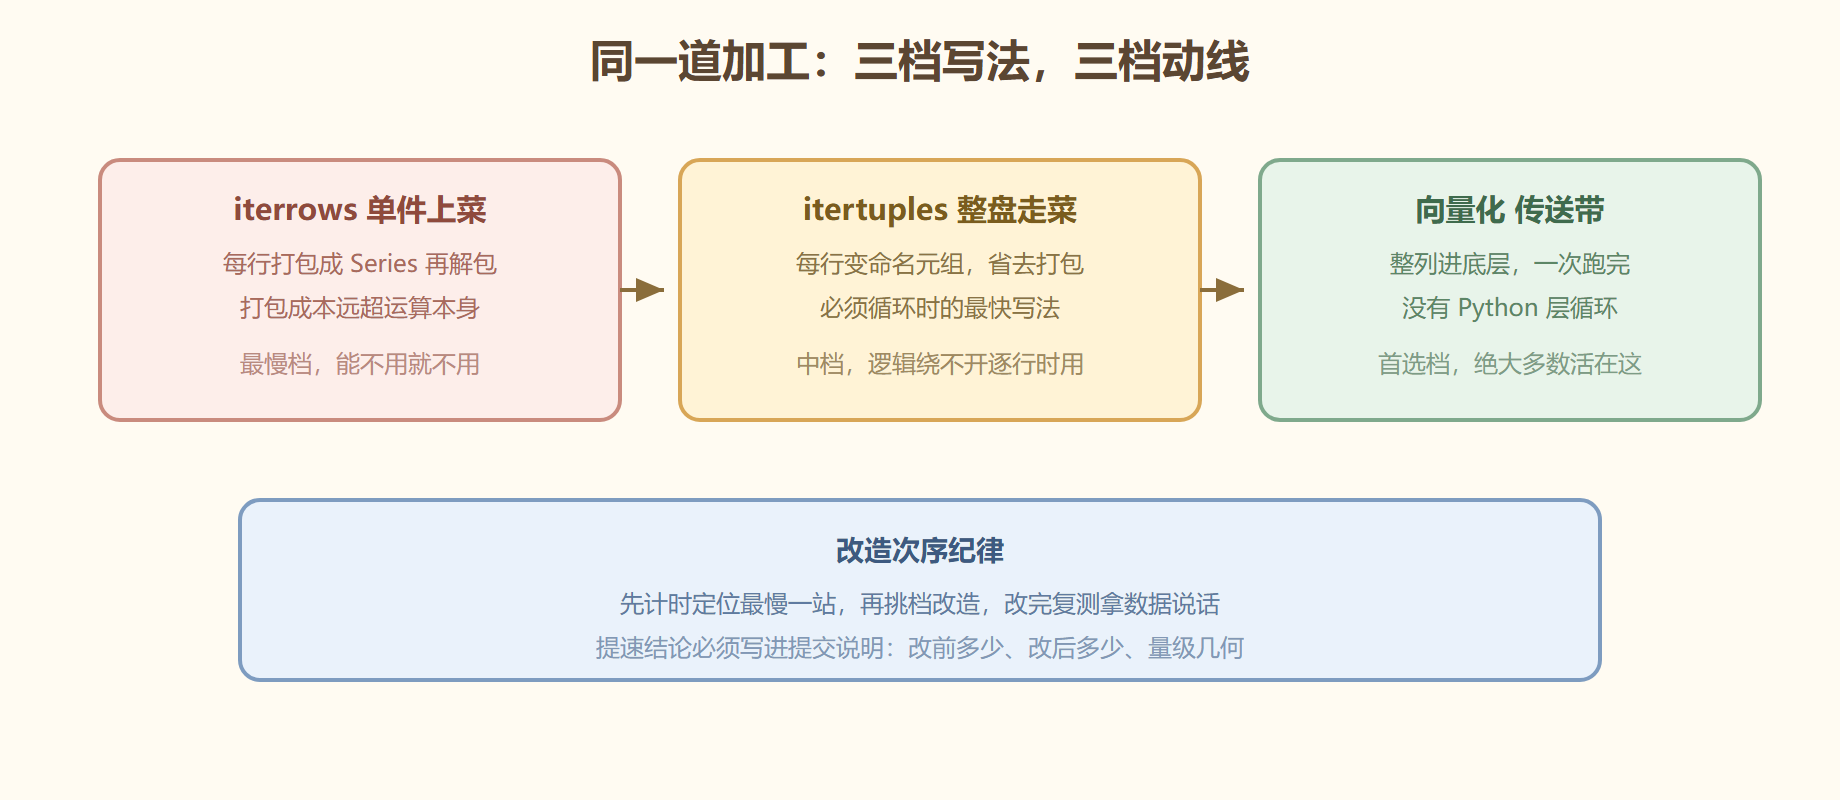
图 三档写法的动线对比
参数拆解:计时与三档
计时:Jupyter 里用计时魔术命令(百分号 timeit 多轮取均值更准);脚本里用标准库的 perf_counter 手工掐表,两端各记一次;诊断"时间花在哪"用性能剖析工具(cProfile 或行级剖析),先看热点再动手。iterrows():逐行产出"索引加 Series",把每行打包再拆包,成本远高于运算本身——它是"能不用就不用"的垫底写法。itertuples():逐行产出命名元组,不打包 Series,快出一个数量级,是"确实必须逐行"时的正解;注意列名不符合 Python 标识符规则的列会被改名,用下标取更稳。向量化:整列运算交底层,是默认追求;具体手法全在前文——条件分支用 np.where 与 np.select(4.4),字符串用 str 访问器(3.3),分组统计用 groupby(4.1)。
import pandas as pd import numpy as np import time n = 200_000 df = pd.DataFrame({"单价": np.random.rand(n) * 100, "数量": np.random.randint(1, 20, n)}) def timed(label, fn): t0 = time.perf_counter() out = fn() print(f"{label}: {time.perf_counter() - t0:.3f} 秒") return out # 档一:iterrows(垫底写法,演示用) r1 = timed("iterrows", lambda: pd.Series( [r["单价"] * r["数量"] for _, r in df.iterrows()])) # 档二:itertuples r2 = timed("itertuples", lambda: pd.Series( [r.单价 * r.数量 for r in df.itertuples()])) # 档三:向量化 r3 = timed("vectorized", lambda: df["单价"] * df["数量"]) print(r3.equals(r2)) # True,三档结果一致
在普通笔记本上,这三档对二十万行数据通常是"数十秒、数秒、毫秒"的关系——数量级的差距,正是动线改造的空间。
实操示例:一次带数据的改造全程
场景:给订单表按金额区间打档位标签,初版用 iterrows 逐行判断,改造后用 np.select。完整呈现"计时—改造—复测"。
df2 = pd.DataFrame({"金额": np.random.rand(n) * 500}) # 待打档的订单表 def tag_iterrows(df): out = [] for _, r in df.iterrows(): v = r["金额"] out.append("低价" if v < 100 else "中价" if v < 300 else "高价") return out def tag_vectorized(df): return np.select([df["金额"] < 100, df["金额"] < 300], ["低价", "中价"], default="高价") t0 = time.perf_counter(); a = tag_iterrows(df2); t1 = time.perf_counter() b = tag_vectorized(df2); t2 = time.perf_counter() print(f"改造前 {t1 - t0:.3f} 秒,改造后 {(t2 - t1) * 1000:.1f} 毫秒") # 改造前 2.1 秒,改造后 4.3 毫秒 <- 提速写进提交说明
效率与可读的取舍表
改造动线时,"值不值得"取决于数据量级与代码复用频率,下表是常见场景的经验边界,供决策参考。
| 场景 | 量级 | 建议 |
|---|---|---|
| 一次性小脚本 | 千行以内 | 可读优先,循环也无妨 |
| 报表常规任务 | 万到百万行 | 向量化改造,收益显著 |
| 批处理流水线 | 百万行以上 | 向量化加分块,再考虑并行 |
| 逐行带状态逻辑 | 任意 | itertuples 或显式循环,别硬凹 |
表里的"一次性"是关键词:只为跑一次的逻辑,优化投入永远收不回;会被反复运行的报表与流水线,才是动线改造的主战场。判断顺序永远是——先看这份代码会活多久,再决定为它花多少力气。
坑点与翻车
**翻车一:凭感觉优化。**没计时就开改,改完一段"看着快了"的循环,瓶颈其实在另一处——先剖析后动手,次序不可倒。**翻车二:apply 当向量化。**apply 写起来一行、跑起来仍是 Python 层循环(6.1 已立此案),拿它当提速手段等于没改——apply 的正确定位是"复杂逻辑的兜底",不是性能方案。**翻车三:循环里反复取子表。**循环体内 df[df["大区"]=="华东"] 这类全表扫描的筛选,每轮一次、总数几十万次——把不变的筛选提到循环外,这一条与档位选择同样重要。**翻车四:为了微秒级优化牺牲可读性。**十万行的任务跑零点几秒,为省二十毫秒把清晰逻辑改成一串天书,得不偿失——优化的前提是"这段真的慢",边界在下一节末尾再收一次。
替代方案
逻辑确实绕不开逐行时,除 itertuples 外还有两招:把循环下沉到 NumPy(用数组下标推进,替代 Series 打包),或用并行把循环摊到多个进程(8.3 正式开灶)。数据量大到向量化也吃紧,先试 8.2 的降载(dtype 降级、分块),再考虑 7.4 的大灶台。还有一类"伪慢":瓶颈根本不在计算而在读盘或网络——计时剖析的价值就在把这类问题现形,别对着无辜的循环开刀。
收档清单
- 先计时后动手:剖析定位热点,改前改后都要有数;
- 三档排序:向量化首选,itertuples 兜底,iterrows 回避;
- 循环提纯:不变的筛选提到循环外,别每轮全表扫;
- 提速要留痕:数据写进提交说明,团队才能复用结论;
- 不为微秒卖可读性:优化以实测瓶颈为前提。
速度这本账翻篇,翻下一本:8.2 内存管理——表太大塞不下时的三招省法。